

Полное меню
- Актуальное
законодательство - Интернет
и право- - Рассылка ''Закон есть закон''
- - Форум сайта (архив)
- - Законодательство
- - Судебная практика (необычная)
- - Судебная практика (авторская)
- - Процедура UDRP и и решения WIPO
- - Книги серии ''Интернет и Право''
- - Книги в открытом доступе
- - Учебный курс ''Интернет и Право''
- - Учебный курс ''Доменные споры''
- - Литература по ''Интернет и Право''
- - Литература по интел. собственности
- - Научный уголок (работы гостей)
- - Авторские публикации
- Информационные
материалы - ЮРИДИЧЕСКИЕ
УСЛУГИ- - Перечень юридических услуг
- - Карта юридических услуг
- - Юридическая консультация
- - Доменные споры (RU), авторское право
- - Международный суд по доменам (COM)
- - Защита прав на маркетплейсе (WB, Ozon)
- - Защита прав в соцсетях (Vk, Ok, FB)
- - Купля-продажа домена, сайта, ПО
- - Досудебное урегулирование конфликта
- - Защита чести и деловой репутации
- - Отмена блокировки сайта/домена РКН
- - ФАС: товарные знаки, авторское право
- - Регистрация ПО/сайта (Роспатент)
- - Юридическая проверка домена
- - Нотариальное заверение сайтов
- - Способы и формы оплаты услуг
- - Мы в СМИ
- - О компании, клиенты
- - Наши дела и победы
- - Контакты и реквизиты
- Информация
о сайте -


ОписаниеИсточник публикации М.: Стандартинформ, 2017 Примечание к документу Документ введен в действие с 1 июля 2019 года. Название документа "ГОСТ Р ИСО 11073-91064-2017. Национальный стандарт Российской Федерации. Информатизация здоровья. Стандартный протокол коммуникаций. Часть 91064. Компьютерная электрокардиография" (утв. и введен в действие Приказом Росстандарта от 26.09.2017 N 1236-ст) "ГОСТ Р ИСО 11073-91064-2017. Национальный стандарт Российской Федерации. Информатизация здоровья. Стандартный протокол коммуникаций. Часть 91064. Компьютерная электрокардиография"
|
|||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||

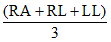 , который называется центральной терминалью Вилсона (ЦТ). В векторкардиографии выполняются записи трех взаимно перпендикулярных отведений, проходящих параллельно осям системы прямолинейных координат, связанной с телом. Это ось X, идущая слева направо, ось Y, идущая сверху вниз, и ось Z, идущая спереди назад.
Категория | Требующийся раздел данных | Описание содержания |
I | 0, 1, [2], 3, 6, (7), (8), (10) | Демографические данные и данные ритма ЭКГ (несжатые или со сжатием без потери информации) |
II | 0, 1, [2], 3, 4, 5, 6, (7), (8), (10) | Демографические данные, данные ритма ЭКГ (несжатые, со сжатием без потери информации или с высоким сжатием) и эталонные циклы |
Примечания 1 Квадратные скобки [ ] указывают на необходимость раздела данных 2, если используется кодирование Хаффмана. 2 Круглые скобки ( ) указывают на то, что эти разделы данных не обязательны для экспорта. | ||
В будущих версиях может быть добавлена дополнительная категория, чтобы выполнить определенные требования устройств ЭКГ, используемых в других областях (например, в телемедицине или лечении на дому).
Все устройства, для которых объявлена категория формата данных SCP-ECG, должны импортировать как минимум разделы данных 0, 1, 3, 6, 7 и 8. Все категории могут иметь дополнительные разделы (например, 9, 10, 11). Данные, специфичные для конкретного производителя, должны необязательно включаться только в поля, байты и блоки, специфичные для производителя, которые были определены в документе. Зарезервированные, не специфицированные и не определенные поля, байты или блоки данных не должны использоваться для данных, специфичных для производителя.
Для конкретного устройства заявление о соответствии SCP-ECG перечисляет категории экспортируемых данных (т.е. снимаемых и доступных записей SCP-ECG) и импортируемых (т.е. принимаемых и доступных пользователю записей SCP-ECG). Устройство может также объявить свою способность передачи (т.е. возможности сделать доступной запись SCP-ECG без смены формата данных, например, экспортировать записи, которые были импортированы до этого). (В целях настоящего стандарта эти термины точно определены в приложении B.)
Выборка и определение синтаксиса высокого уровня, ориентированного на ЭКГ и предназначенного для передачи сообщений и данных между серверами, например EDIFACT или ASN.1, не входит в область применения настоящего стандарта.
Настоящий стандарт определяет общие соглашения, требующиеся для обмена конкретными данными пациента (демографическая информация, записи и т.д.), данными сигнала ЭКГ, измерениями ЭКГ и результатами интерпретации ЭКГ как между устройством картирования и сервером, так и между устройствами картирования.
Настоящий стандарт устанавливает содержание и структуру информации, которой будут обмениваться цифровые устройства картирования ЭКГ и компьютерные системы управления ЭКГ, а также другие компьютерные системы, в которых хранятся данные ЭКГ.
В настоящем стандарте использованы нормативные ссылки на следующие международные стандарты. Для датированных ссылок применяют только указанное издание ссылочного документа, для недатированных ссылок применяют последнее издание ссылочного документа (включая все его изменения):
ISO/IEC 646 Information technology - ISO 7-bit coded character set for information interchange (Информационные технологии. 7-битный набор кодированных символов ИСО для обмена информацией)
ISO/IEC 2022:1994, Information technology - Character code structure and extension techniques (Информационные технологии. Структура кода символов и методы расширения)
ISO/IEC 4873, Information technology - ISO 8-bit code for information interchange - Structure and rules for implementation (Информационные технологии. 8-битный набор кодированных символов ИСО для обмена информацией)
ISO/IEC 8859-1, Information technology - 8-bit single-byte coded graphic character sets - Part 1: Latin alphabet No. 1 (Информационные технологии. 8-битовые однобайтовые наборы кодированных графических знаков. Часть 1. Латинский алфавит N 1)
JIS X 0201-1976, Code for Information Interchange (Код для обмена информацией)
JIS X 0208-1997, Code of the Japanese Graphic Character Set for Information Interchange (Код японского набора графических символов для обмена информацией)
В настоящем стандарте применены следующие термины с соответствующими определениями:
3.1 кардиограф, снимающий показания (acquiring cardiograph): Кардиограф, записывающий исходный сигнал ЭКГ.
3.2 бимодальное сжатие (bimodal compression): Использование низкочастотного фильтра и прореживания считываний за пределами защищенной зоны, содержащей комплекс QRS, без прореживания или фильтрации внутри защищенной зоны. На это указывает байт 6 из 5.9.3.
3.3 подтверждение (confirming): Процесс, в ходе которого обученный и опытный кардиолог проверяет сгенерированную компьютером интерпретацию ЭКГ (или расшифровку), чтобы подтвердить сгенерированную компьютером интерпретацию (или расшифровку) либо внести окончательные изменения в текст интерпретации.
Примечание - Подтвержденная ЭКГ является окончательной клинически приемлемой версией для диагностики и лечения.
3.4 Проект CSE (CSE Project): Проект, поддерживаемый генеральным директоратом XII Европейской комиссии, нацеленный на разработку общих стандартов для (количественной) электрокардиографии.
3.5 коэффициент снижения частоты/коэффициент прореживания (downsampling factor/decimation factor): Коэффициент, задающий сокращение считываний в разделах данных, где частота считываний снижена относительно исходной частоты считываний.
Примечание - Это применимо к бимодальному сжатию данных.
Пример - Исходная частота считываний 500 отсчетов в секунду (равносильна интервалу между считываниями 2 мс) сокращена до 125 считываний в секунду (равносильно интервалу между считываниями 8 мс). Коэффициент снижения частоты в таком случае составляет 4.
3.6 интерпретирующее устройство (interpretive device): Устройство (картирующее устройство, компьютер), анализирующее сигнал ЭКГ.
3.7 сообщение (message): Текстовое тело информации.
3.8 расшифровка (overreading): Процесс, в ходе которого кардиолог или ассистент проверяет интерпретацию ЭКГ, сгенерированную компьютером, чтобы проверить точность интерпретации или внести изменения в ее текст.
Примечание - Расшифровка ЭКГ, как правило, не является окончательной клинически приемлемой версией для диагностики и лечения. Как правило, процесс расшифровки предшествует процессу подтверждения.
3.9 запись (record): Весь файл данных, который необходимо передать, включая данные ЭКГ и связанную с ними информацию, например, идентификацию пациента, демографические и другие клинические данные.
3.10 эталонный цикл (reference beat): Эталонный/типичный цикл ЭКГ, вычисленный с помощью любого (но не указанного) алгоритма, охватывающий зубцы P, QRS и ST-T.
3.11 остаточные данные (residual data): Данные исходной ЭКГ, остающиеся после "надлежащего" вычитания эталонного цикла, где "надлежащий" означает точное совмещение циклов.
3.12 данные ритма (rhythm data): Полные данные исходной ЭКГ или разархивированные и восстановленные данные ЭКГ с уменьшенным разрешением.
Примечание - Длина ритма, как правило, равна 10 с.
3.13 раздел (section): Совокупность элементов данных, связанная с одним аспектом записи, измерения или интерпретации электрокардиографии.
3.14 универсальные коды интерпретации (universal statement codes): Коды интерпретации ЭКГ (см. приложение F).
Примечание - Другие технические термины, связанные с настоящим стандартом, см. в приложении G.
В настоящем стандарте применены следующие сокращения:
AAMI | - Американская ассоциация содействия развитию медицинской техники; |
AC | - переменный ток; |
AHA | - Американская ассоциация изучения сердечных заболеваний; |
AIM | - продвинутые информационные технологии для медицинских программ генерального директората Европейской комиссии XIII; |
ANSI | - Американский государственный институт стандартизации; |
ASCII | - американский стандартный код для обмена информацией; |
ASN.1 | - язык OSI для описания абстрактного синтаксиса; |
AVM | - множитель величины амплитуды (см. 5.8.3); |
BS | - клавиша "обратный ход" (управляющий символ); |
CCITT | - Международный консультативный комитет по телеграфии и телефонии; |
CEN | - Европейская комиссия по стандартизации; |
CR | - возврат каретки (управляющий символ); |
CRC | - циклическая проверка избыточности; |
CSE | - общепринятые стандарты для количественной электрокардиографии; |
DG | - генеральный директорат (Европейской комиссии); |
EC | - Европейское сообщество; |
ЭКГ | - электрокардиограмма; |
ECU | - европейская валютная единица  ; |
ЭДИФАКТ | - стандарт электронного обмена данными в управлении, торговле и на транспорте; |
EN | -  Norm (европейский стандарт); |
ENV | -  Norm Vorausgabe (европейский предварительный стандарт); |
ESC | - клавиша "Escape" (управляющий символ); |
FF | - смена страницы (управляющий символ); |
HT | - клавиша горизонтальной табуляции (управляющий символ); |
ICD | - международная классификация болезней; |
ID | - идентификация; |
МЭК | - Международная электротехническая комиссия; |
ИИЭЭ | - Институт инженеров по электротехнике и электронике; |
IMIA | - Международная ассоциация медицинской информатики; |
ИСО | - Международная организация по стандартизации; |
JIS | - японский промышленный стандарт; |
LF | - символ новой строки (управляющий символ); |
LSB | - младший двоичный разряд; |
MSB | - старший двоичный разряд; |
RMS | - среднее квадратичное; |
SCP | - стандартный коммуникационный протокол; |
SCP-ECG | - стандартный коммуникационный протокол для компьютерной электрокардиографии; |
TC | - технический комитет; |
VCG | - векторная электрокардиография; |
VT | - вертикальная табуляция (управляющий символ). |
5.1.1 Запись данных, которая предполагается для обмена, должна быть разделена на разные разделы. Содержание и формат каждого из этих разделов определяются в настоящем стандарте.
5.1.2 Все текстовые данные (строки символов) должны удовлетворять ограниченным требованиям для соответствия ИСО/МЭК 2022, которые описаны в приложении A. Latin-1 (ИСО/МЭК 8859-1) должен быть набором символов по умолчанию.
5.1.3 Все строки символов должны завершаться байтом NULL (не является частью ИСО/МЭК 2022).
5.1.4 Для всех двоичных значений со знаком должен использоваться дополнительный код.
5.1.5 Все двоичные значения, состоящие из одного или нескольких байтов, считаются целочисленными без знака, если не указано иное.
5.1.6 Двоичные значения, состоящие из нескольких байтов, должны передаваться в порядке возрастания значимости (наименьший значащий байт передается первым, а наибольший - последним).
5.1.7 Последовательные байты нумеруются слева направо (начиная с первого). Биты байта нумеруются справа налево (0 - LSB, 7 - MSB).
5.1.8 Первый байт записи (т.е. первый байт контрольной суммы) определен как Байт 1.
5.1.9 Считывания ЭКГ индексируются и нумеруются, начиная со считывания номер 1. Номер считывания 0 не используется в настоящем стандарте. Номер считывания является 16-битным индексом. Первое считывание происходит в момент времени 0. Второе считывание, в случае частоты 500 считываний в секунду, происходит в 0 + 2 мс.
5.1.10 Разделы нумеруются, начиная с 0 (указатель раздела) по 32 767.
5.1.11 Термин "эталонный цикл" используется в настоящем стандарте по отношению к комплексу ЭКГ, выбранному в качестве представителя класса таких комплексов. Данный термин не предполагает никакого конкретного статистического смысла; например, это может быть усредненный цикл, "средний цикл", выбранный или какой-либо другой единичный цикл, взятый из общей записи ЭКГ. "Эталонный цикл" включает в себя P-зубцы, если они присутствуют (не в случае предсердной фибрилляции), сегмент ST-T и T-зубец данного цикла.
ЭКГ может обладать множеством эталонных циклов. Термин "тип цикла", используемый в настоящем стандарте, означает один цикл из упорядоченного списка эталонных циклов, начиная с типа эталонного цикла 0 (ноль). Эталонный цикл типа 0 по определению является эталонным циклом, применяемым для классификации ЭКГ и для вычитания, если при сжатии используется вычитание эталонного цикла. Упорядочивание списка эталонных циклов не предполагает наличия их последовательности во времени в данных ритма.
Термин "данные ритма" применяется для описания данных ЭКГ, полученных на протяжении всего времени записи, как правило, 10 сек. в большинстве записывающих устройств. Описание этих терминов и рекомендованной методологии сжатия данных, включая цифровые примеры и методы испытания сжатия данных и искажения сигнала на соответствие минимальным требованиям, даны в разделе 6, приложениях B и C.
В 5.8 данные эталонного цикла типа 0 предназначены для использования в целях отображения, (повторного) анализа, и если для сжатия данных было использовано вычитание эталонного цикла, то для реконструкции данных ритма.
5.1.12 Все индексы или указатели определены в байтах и начинаются с единицы, если не указано обратное.
5.1.13 1 Кбайт = 1024 байтам.
5.2.1 Все разделы должны начинаться с нечетного индекса (четное смещение). Это предполагает, что все разделы должны содержать четное число байтов. В конец любого раздела, содержащего нечетное число байтов, должен быть добавлен заполняющий байт. Заполняющие байты должны всегда иметь значение NULL. Блоки данных в разделе могут содержать либо нечетное, либо четное число байтов. Заполнение происходит только в конце раздела, если оно необходимо.
5.2.2 Всем разделам присваиваются идентификационные номера. Номера разделов с 0 по 11 на данный момент определены в протоколе SCP-ECG, номера с 12 по 127, а также номера, превышающие 1023, зарезервированы для будущего использования. Номера с 128 по 1023 назначаются разделам, специфичным для конкретного производителя. Сочетания кода производителя (см. 5.4.3.1, тег 14) и номера раздела с 128 по 1023 уникально определяют содержание разделов, специфичных для конкретного производителя. Не существует никаких конкретных правил для раскладки и формата этих разделов. Тем не менее рекомендуется использование структуры, определенной в 5.2.7.
5.2.3 Включение разделов 2, 4, 5, 7 - 11 (см. 5.2.7 и 5.2.8) является необязательным. Любая запись данных SCP-ECG должна содержать раздел 0 (указатели), раздел 1 (заголовок), раздел 3 (определение отведения ЭКГ) и раздел 6 (данные ритма). Не предполагается никаких иных проверок целостности других присутствующих разделов. В частности, если присутствует какой-либо из разделов 8, 9 или 11, то не предполагается, что должны быть в наличии все три.
5.2.4 Запись ЭКГ начинается с 6-байтового заголовка, состоящего из 2-байтовой контрольной суммы, за которым следует 4-байтовая длина записи. Они определяются следующим образом:
1) 2-байтовый циклический избыточный код (CRC) вычисляется по алгоритму CRC-CCITT, описанному в E.5.5. CRC вычисляется для всей записи, начиная с первого байта, следующего за CRC, и заканчивая последним байтом в записи;
2) 4-байтовая длина записи обозначает число байтов во всей записи, включая 6 байтов заголовка данной записи.
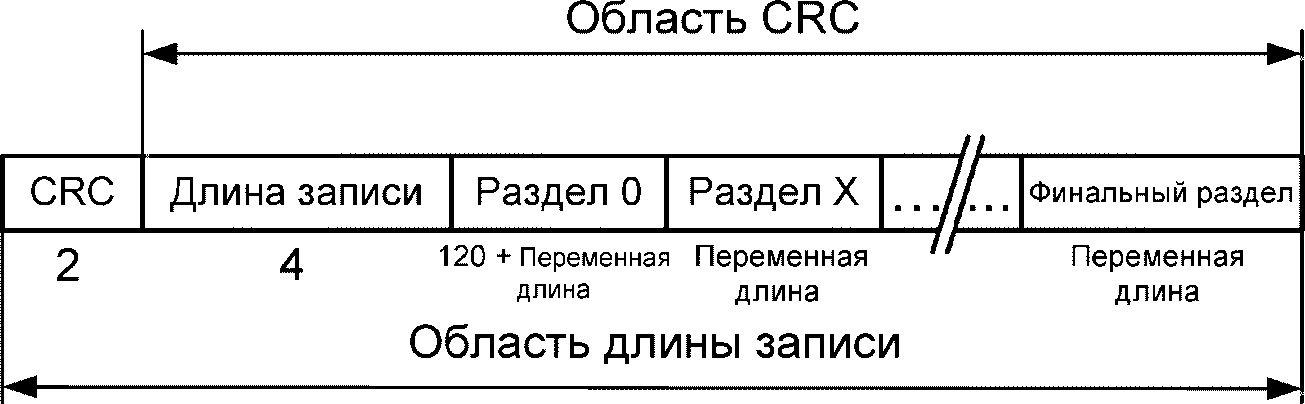
Рисунок 1 - Обзор записи
5.2.6 Порядок последовательности разделов записи является свободным, за исключением раздела 0 (ноль), который должен следовать непосредственно за ее заголовком. Однако в записи данных SCP-ECG разрешен максимально один экземпляр любого раздела.
1) идентификации заголовка раздела (ID заголовка раздела);
2) части данных раздела.
Любой раздел должен начинаться с "ID заголовка раздела" (16 байтов), определенного ниже:
Байты | Содержание |
1 - 2 | 16-битовая контрольная сумма CRC-CCITT для всего раздела, за исключением этих двух байтов. |
3 - 4 | |
5 - 8 | Длина раздела в байтах, включая "ID заголовка раздела" (5.3.3.2). |
9 | Номер версии раздела. |
10 | Номер версии протокола (см. 5.4.3.1, тег 14, байт 15). |
11 - 16 | Зарезервировано (для раздела данных 0, см. 5.3.1). |
Каждый раздел должен иметь номер версии протокола раздела (см. байты 9 и 10), который может использоваться для указания различных уровней совместимости со стандартом, когда этот стандарт будет обновлен в будущем (см. приложение B). Для разделов с 1 по 11 номера версий разделов (байт 9) должны быть версией протокола, для которой был одобрен данный раздел. Для разделов данных с 12 по 1023 версия раздела должна обозначать версию производителя для данного раздела, не зависящую от версии протокола.
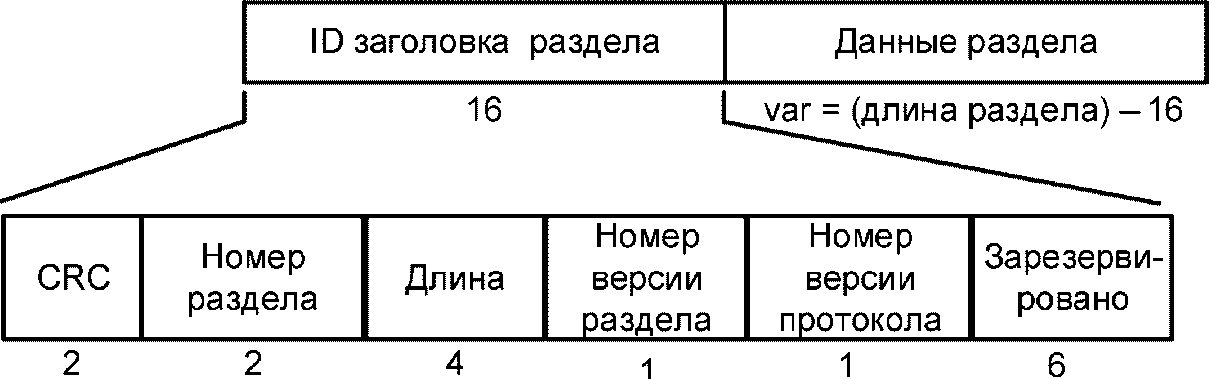
Рисунок 2 - Обзор организации раздела
ИС NORMPROD: примечание. В официальном тексте документа, видимо, допущена опечатка: в п. 5.2.5, 5.2.9 курсива нет. |
5.2.10 Числа, указанные курсивом, в обзорах организации раздела (в 5.2.5, 5.2.9), указывают длину соответствующего поля в байтах или обозначенный блок (var - переменная длина).
5.2.11 Общий обзор структуры данных SCP-ECG приведен в таблице 2.
Таблица 2
Структура данных SCP-ECG
Статус обязательности | Содержание |
Обязателен | 2 байта - контрольная сумма - CRC-CCITT для всей записи (за исключением этого слова) |
Обязателен | 4 байта - (без знака) размер всей записи ЭКГ (в байтах) |
Обязателен | (Раздел 0) Указатели на области данных в записи |
Обязателен | (Раздел 1) Информация заголовка - данные пациента/данные о снятии ЭКГ |
Условно обязателен | (Раздел 2) Таблицы Хаффмана, используемые в кодировании данных ЭКГ (если используются) |
Обязателен | (Раздел 3) Определение отведений ЭКГ |
Необязателен | (Раздел 4) Местоположения QRS (если эталонные циклы закодированы) |
Необязателен | (Раздел 5) Закодированные данные эталонных циклов, если осуществляется их хранение |
Обязателен | (Раздел 6) "Остаточный сигнал", если выполняются вычитание эталонного цикла и его хранение, в противном случае закодированные данные ритма |
Необязателен | (Раздел 7) Глобальные измерения |
Необязателен | (Раздел 8) Текст диагноза от "интерпретирующего" устройства |
Необязателен | (Раздел 9) Диагностика, специфичная для производителя, и расшифровка данных от "интерпретирующего" устройства |
Необязателен | (Раздел 10) Результаты измерений отведений |
Необязателен | (Раздел 11) Универсальные коды утверждений, вытекающие из интерпретации |
5.2.12 Приведенные ниже замечания применимы к областям данных, определенным выше.
0 | Данный раздел содержит указатели на начало каждого из следующих разделов. Этот раздел обязателен. |
1 | Данный раздел содержит общую информацию, относящуюся к пациенту (например, фамилию и имя пациента, идентификатор пациента, возраст и т.п.), а также к ЭКГ (дату снятия, время и т.п.). Этот раздел обязателен. |
2 | Данный раздел содержит все таблицы Хаффмана, используемые в кодировании ритма (или "остаточного сигнала") и данных эталонного цикла. В разделах 5 и 6 на эти таблицы должны приводиться ссылки согласно порядковым номерам этих таблиц в данном разделе. Таким образом, когда в разделе кодирования эталонного цикла приводится ссылка на таблицу 2, то она должна отсылать ко второй таблице, определенной в разделе 2. Этот раздел обязателен в зависимости от использования кодирования Хаффмана при кодировании ритма (или "остаточного сигнала") и эталонного цикла (если он хранится). |
3 | Данный раздел указывает отведения ЭКГ, содержащиеся в записи. Этот раздел обязателен. |
4 | Если эталонные циклы закодированы, то данный раздел должен идентифицировать позиции этих эталонных циклов относительно "остаточного" сигнала, содержащегося в разделе 6. Этот раздел необязателен. |
5 | Записи эталонных циклов для каждого отведения кодируются в случае, если устройство, с которого они поступили, идентифицировало эти комплексы. Данный раздел необязателен. |
6 | Данный раздел содержит "остаточный" сигнал, остающийся для каждого отведения после вычитания записей эталонного цикла. Если эталонные циклы не вычитались, он содержит весь сигнал ритма. Этот раздел обязателен. |
7 | Данный раздел содержит глобальные измерения для каждого типа эталонного цикла или для каждого комплекса QRS, содержащегося в записи, а также список возможных импульсов кардиостимулятора в записи. Этот раздел необязателен. |
8 | Данный раздел содержит самый последний актуальный текст интерпретации диагностики записанных данных ЭКГ, включая все расшифровки, если они были выполнены. Данный раздел должен включать только самую актуальную интерпретацию и расшифровку. В тексте не должны использоваться никакие коды, специфичные для производителя. При необходимости могут использоваться мнемокоды, перечисленные в универсальных кодах интерпретации. Данные, содержащиеся в данном разделе, должны согласовываться с данными в разделах 9 и 11. Этот раздел необязателен. |
9 | Данный раздел содержит диагностические утверждения анализирующего устройства, специфичные для конкретного производителя, а также привязки интерпретаций к расшифровкам. Источник анализирующего устройства, а также фамилия и имя последнего подтверждающего врача (или устройства) определены в "разделе заголовка" (раздел 1). Данный раздел необязателен. |
10 | В данном разделе представлены набор базовых измерений и измерений, специфичных для производителя (если имеются), для каждого записанного отведения. Данный раздел необязателен. |
11 | Данный раздел содержит самую последнюю интерпретацию и данные расшифровки, закодированные в соответствии с универсальными кодами интерпретации и правилами кодирования (приложение F). Данные, содержащиеся в данном разделе, должны согласовываться с данными в разделах 8 и 9. Этот раздел необязателен. |
5.3.1 Цель данного раздела заключается в хранении указателей на остальные разделы записи. Всем разделам даются идентификационные номера в соответствии с 5.2.2.
5.3.2 Данный раздел начинается с "ID заголовка раздела" в соответствии с 5.2.7. Байты с 11 по 16 ID заголовка раздела должны содержать строку ASCII из шести символов "SCPECG".
5.3.3 Для обеспечения гибкости управления разделом данные раздела указателей определяются следующим образом:
- независимо от присутствия необязательных разделов должно быть предоставлено одно поле указателя для каждого раздела с 0 по 11, определенного протоколом SCP-ECG. Для каждого необязательного раздела, не включенного в запись данных SCP-ECG, поле указателя должно содержать специальные коды, определенные в 5.3.3.2 и 5.3.3.3;
- каждому разделу, специфичному для производителя (если присутствуют), должно соответствовать поле указателя в разделе 0.
Каждое поле указателя содержит три части:
a) идентификация раздела (см. 5.3.3.1);
b) длина раздела (см. 5.3.3.2);
c) индекс раздела (см. 5.3.3.3).
5.3.3.1 Идентифицирующий номер раздела хранится в двух байтах, содержащих этот номер, в соответствии с 5.2.2. В настоящее время номера разделов с 0 по 11 определены в протоколе SCP-ECG, номера с 12 по 127, а также номера, превышающие 1023, зарезервированы для будущего использования. Номера с 128 по 1023 являются кодами разделов, специфичных для производителя.
5.3.3.2 Длина раздела в байтах (четное число, см. 5.2.1) представлена в данной 4-байтовой целочисленной части поля без знака. Длина включает байты "ID заголовка раздела" (см. 5.2.7). Четырехбайтовое целое необходимо, чтобы позволить разделы, длина которых превышает 32 Кбайта. Для данных, содержащихся в разделах 2 - 11, поле указателя должно присутствовать. Если в каком-либо из этих разделов не передается никаких данных, то длина этого раздела должна иметь значение 0.
5.3.3.3 Индекс первого байта раздела должен быть представлен в данной 4-байтовой целочисленной части поля без знака. Индекс вычисляется относительно начала записи, т.е. байта 1 записи (первый байт CRC). Например, если раздел 11 начинается со сдвигом в 128 900 байтов от начала записи ЭКГ, то индекс раздела 11 будет иметь значение 128 901. Четырехбайтовое целое необходимо, чтобы позволить запись SCP-ECG, длина которой превышает 32 Кбайта. Если раздел не включен в запись SCP-ECG, то его индекс должен иметь значение NULL (0). Индекс раздела 0 должен всегда иметь значение 7, так как разделу 0 всегда предшествует контрольная сумма (2 байта) и длина записи (4 байта).
5.3.3.4 Поля указателя должны быть представлены в порядке возрастания номеров разделов. Но сами разделы не обязаны следовать в порядке возрастания номеров.
5.3.4 Обзор структуры раздела указателя:
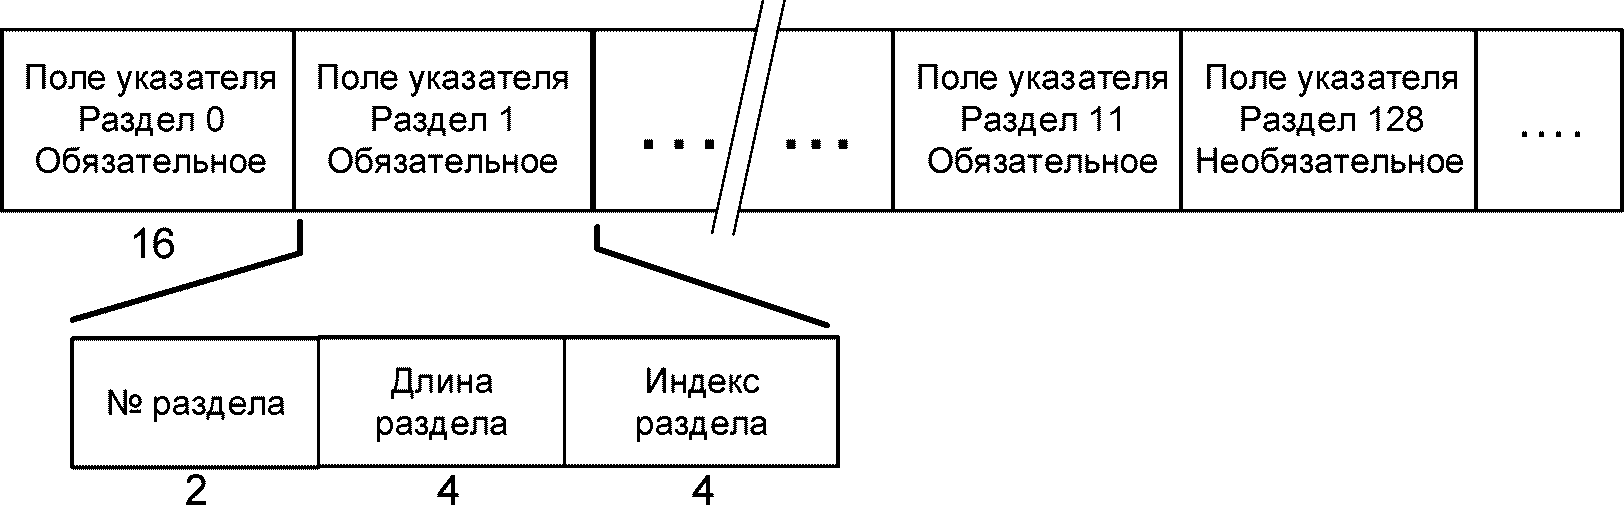
Рисунок 3 - Обзор структуры раздела указателя
5.4.1 Общие положения
Раздел должен начинаться с "ID заголовка раздела" в соответствии с 5.2.7.
5.4.2 Введение в данные раздела
Приведенная ниже раскладка подробно описывает формат, который должен использоваться для передачи демографических данных пациента и административных данных ЭКГ в качестве части стандартного (SCP-ECG) протокола коммуникаций для цифровых данных ЭКГ.
5.4.3 Базовая методология
5.4.3.1 Известно, что несмотря на возможность передачи большого числа параметров, большинство устройств передает только их подмножество. Поэтому было принято решение сделать формат демографических данных пациента более гибким.
Каждый параметр должен храниться в отдельном поле. Включение поля в данный раздел должно быть необязательным при условии, что присутствуют следующие параметры (с 1 по 4):
Тег | Параметр | |
1 | 2 | Идентификатор пациента (используется как первичный ключ в базе данных управления ЭКГ). |
2 | 14 | Идентификатор снимающего устройства. |
3 | 25 | Дата снятия. |
4 | 26 | Время снятия. |
Кроме того, рабочая группа SCP-ECG настоятельно рекомендует следующие параметры для уникальной идентификации пациента и времени снятия:
Тег | Параметр | |
5 | 0 | Фамилия пациента. |
6 | 1 | Имя пациента. |
7 | 5 | Дата рождения пациента (в принципе, датой рождения должен быть год нашей эры). |
8 | 8 | Пол пациента. |
9 | 15 | Идентификатор анализирующего устройства. |
10 | 34 | Часовой пояс даты и времени. |
5.4.3.2 Гибкость достигается путем идентификации каждого поля с помощью следующих средств:
a) один ведущий байт спецификации, именуемый "тег", идентифицирует содержание поля параметров;
b) 2-байтовое целое число без знака, именуемое "длиной", содержащее длину значения поля в байтах, позволяет вносить текстовые записи различной длины и использовать мультибайтовые наборы символов (например, наборы японских символов). В длину поля должен входить символ NULL, завершающий строку текста. Например, длина фамилии "Menuel" должна иметь значение 7, учитывающее NULL. Допустима длина поля 0, эквивалентная утверждению "не определено";
c) нуль или более байтов параметра, именуемых "значением", содержащие фактические данные параметра.
Тег поля (один двоичный байт) разрешает определять всего 255 различных типов поля (от 0 до 254; 255 используется для завершения), из которых 55 (с 200 по 254) зарезервированы для использования конкретным производителем. Любое поле, идентифицированное значением от 200 до 254, не определено в рамках спецификации данного протокола, что позволяет производителю определить свой собственный набор полей.
Длина поля (два двоичных байта) должна содержать фактическую длину значения поля. Байты длины и тега (первые три байта любого поля) не включены в длину поля. Максимальная возможная длина каждого значения поля составляет 65 535 байтов (два байта без знака). Тем не менее по практическим причинам максимальная длина поля не должна превышать 64 байта, за исключением элементов произвольного текста (см. 5.4.3.5).
Значение поля, содержащее данные фактических параметров, может иметь любую комбинацию двоичных байтов и текстовых символов.
5.4.3.3 В разделе "Заголовок" разрешено использование не более одного экземпляра любого поля, определенного в 5.4.5, за исключением полей, перечисленных ниже:
Тег | Описание значения | Максимальное число экземпляров |
10 | Лекарственные препараты | Без ограничений |
13 | Диагноз или указание направления к специалисту | Без ограничений |
30 | Произвольный текст | Без ограничений |
32 | Коды диагноза в истории (болезни) | Без ограничений |
35 | История заболевания свободным текстом | Без ограничений |
5.4.3.4 Первые 16 символов идентификации пациента должны быть уникальными.
5.4.3.5 Для упрощения реализации протокола были определены максимальная длина поля, т.е. 64 байта (за исключением тега 13, тега 30 и тега 35, где ограничение составляет 80), и разумные значения длины разных полей свободного текста (таблица 3).
Таблица 3
Максимальная и разумная длина полей произвольного текста
Раздел | Тег | Содержание | Экземпляров больше одного | Разумная длина |
1 | 0 | Фамилия | - | 40 |
1 | 1 | Имя | - | 40 |
1 | 2 | Идентификатор пациента | - | 40 |
1 | 3 | Вторая фамилия | - | 40 |
1 | 10 | Лекарственные средства | Да | 40 <a> |
1 | 13 | Диагноз или указание направления к специалисту | Да | 80 |
1 | 14 | Идентификационный номер снимающего устройства | - | 40 |
1 | 15 | Идентификационный номер анализирующего устройства | - | 40 |
1 | 16 | Описание организации, в которой выполнено снятие | - | 40 |
1 | 17 | Описание организации, в которой выполнен анализ | - | 40 |
1 | 18 | Описание отделения, в котором выполнено снятие | - | 40 |
1 | 19 | Описание отделения, в котором выполнен анализ | - | 40 |
1 | 20 | Направивший врач | 60 | |
1 | 21 | Самый последний подтверждающий врач | 60 | |
1 | 22 | Описание лаборанта | 40 | |
1 | 23 | Описание помещения | 40 | |
1 | 30 | Поле свободного текста | Да | 80 <a> |
1 | 31 | Порядковый номер ЭКГ | 12 | |
1 | 35 | Анамнез заболевания свободным текстом | Да | |
5.4.4 Обзор части данных раздела "Заголовок" представлен ниже.
Примечание - Заполняющие байты (если имеются) должны иметь нулевое значение. Это применимо ко всем разделам, но не будет отображаться во всех последующих диаграммах.
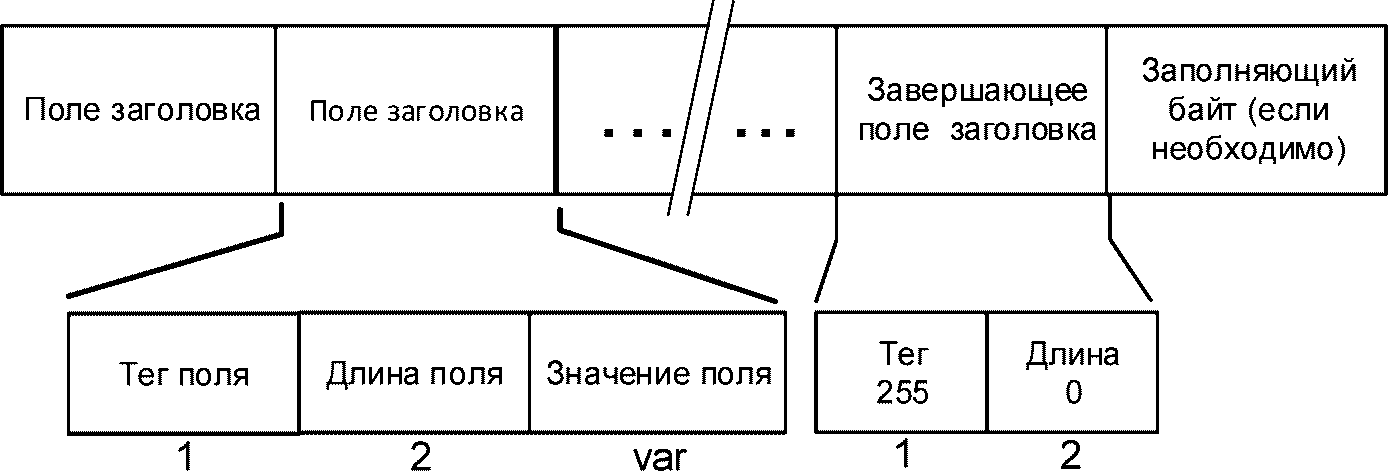
Рисунок 4 - Обзор части данных раздела "Заголовок"
Таблица 4
Спецификация определенных параметров
Тег | Длина | Значение (данные параметра) | ||
0 | Длина | Фамилия (текстовые символы) Данное поле должно также использоваться для передачи фамилии и имени полностью, если исходное устройство не дает явного указания имени | ||
1 | Длина | Имя (текстовые символы) | ||
2 | Длина | Идентификатор пациента (текстовые символы) | ||
3 | Длина | Вторая фамилия (текстовые символы) Значение поля может быть определено как подходящее для страны или области, где используется прибор ЭКГ. Например, в США это поле может содержать код префикса члена семьи, во Франции оно может содержать девичью фамилию, а в Португалии, как и в Испании и нескольких странах Латинской Америки, - вторую фамилию пациента | ||
4 | 3 | Возраст (двоичные значения) Данное поле имеет следующий формат: | ||
Байты | Содержание | |||
1 - 2 | Двоичное. Возраст в единицах измерения, указанных в байте 3. | |||
3 | Двоичное. Единицы измерения возраста определены ниже: | |||
Значение | Единицы измерения | |||
0 | не указаны | |||
1 | год | |||
2 | месяц | |||
3 | неделя | |||
4 | день | |||
5 | час | |||
Если все 3 байта равны нулю, то возраст не указан | ||||
Продолжение таблицы 4
Тег | Длина | Значение (данные параметра) | ||||
5 | 4 | Дата рождения (двоичные значения) Данное поле имеет следующий формат: | ||||
Байты | Содержание | |||||
1 - 2 | Двоичное. Год (полная целочисленная нотация, например, 1990). | |||||
3 | Двоичное. Месяц (диапазон с 01 по 12; 01 = Январь). | |||||
4 | Двоичное. День (диапазон с 01 по 31). | |||||
Если все 4 байта равны нулю, то дата рождения не указана | ||||||
6 | 3 | Рост (двоичные значения) Это поле имеет следующий формат: | ||||
Байты | Содержание | |||||
1 - 2 | Двоичное. Рост в единицах измерений, указанных в байте 3. | |||||
3 | Двоичное. Единицы измерения роста, определенные ниже: | |||||
Значение | Единицы измерения | |||||
0 | не указаны | |||||
1 | сантиметр | |||||
2 | дюйм | |||||
3 | миллиметр | |||||
Если все 3 байта равны нулю, то рост не указан | ||||||
7 | 3 | Вес (двоичные значения) Это поле имеет следующий формат: | ||||
Байты | Содержание | |||||
1 - 2 | Двоичное. Вес в единицах измерений, указанных в байте 3. | |||||
3 | Двоичное. Единицы измерения веса в соответствии с определением ниже: | |||||
Значение | Единицы измерения | Значение | Единицы измерения | |||
0 | не указаны | 3 | фунт | |||
1 | килограмм | 4 | унция | |||
2 | грамм | |||||
Если все 3 байта равные нулю, то вес не указан | ||||||
8 | 1 | Пол (двоичные значения) Данное поле имеет следующий формат: | ||||
Байты | Содержание | |||||
1 | Двоичное. Указание пола, определенное как: | |||||
Значение | Пол | Значение | Пол | |||
1 | мужской | 0 | не известен | |||
2 | женский | 9 | не указан | |||
9 | 1 | Раса (двоичные значения) Данное поле имеет следующий формат: | ||||
Байты | Содержание | |||||
1 | Двоичное. Указание расы, определенное как: | |||||
Значение | Раса | |||||
0 | не указана | |||||
1 | белая европеоидная | |||||
2 | негритянская | |||||
3 | азиатская | |||||
4 - 9 | зарезервировано | |||||
10 - 255 | другая (специфичная для производителя) | |||||
10 | Длина | Лекарственные препараты (двоичные байты и текстовые символы) Каждый лекарственный препарат, вводимый в демографическую область пациента, должен быть описан с помощью следующей структуры: | ||||
Байты | Содержание | |||||
1 | Двоичное. Индикатор таблицы кодов лекарственных препаратов. Если байт 1 установлен в значение 0, то применима следующая таблица. | |||||
2 | Двоичное. Код класса. | |||||
3 | Двоичное. Определенный код лекарственного препарата в определенном классе. | |||||
4 по *** | Текстовые символы: текстовое описание лекарственного препарата (не обязательно). | |||||
Продолжение таблицы 4
Тег | Длина | Значение (данные параметра) | ||||
10 | Длина | Определены следующие классы: | ||||
0 - не указан | 9 - блокаторы кальция | |||||
1 - дигиталис | 10 - антигипотензивные | |||||
2 - антиаритмические | 11 - гиполипидемические препараты | |||||
3 - диуретики | 12 - ингибиторы АПФ | |||||
4 - противогипертонические | с 13 по 19 - зарезервированы | |||||
5 - антиангинальные | 100 - не принимает лекарства | |||||
6 - антитромботические | 101 - принимает лекарства, но их тип неизвестен | |||||
7 - бета-блокаторы | 102 - другое лекарственное средство | |||||
8 - психотропные препараты | 103 по 255 - коды, специфичные для производителя | |||||
Примечания 1 За кодом класса 0 всегда следует код лекарственного препарата со значением 0, указывая на то, что этот препарат не определен в данном документе и что текст в байтах с 4 по *** является единственным доступным описанием. 2 Код класса, не равный 0, вместе с кодом лекарственного препарата 0 всегда указывает на то, что был применен препарат этого конкретного класса, но он либо неизвестен, либо не определен в данном документе. Даже если применены ненулевой класс и код лекарственного препарата, то текстовое описание препарата может быть также передано в байтах с 4 по ***. Не существует никаких стандартизированных условных обозначений названий. 3 Не существует ограничений по числу лекарственных препаратов, которые можно кодировать. 4 В рамках каждого класса код 9 должен использоваться для "другого лекарственного препарата". | ||||||
Класс 1. Препарат дигиталиса | Класс 6. Антитромботические агенты | |||||
0 - Не указано | 0 - Не указано | 4 - Варфарин | ||||
1 - Дигоксин-Ланоксин | 1 - Аспирин | 5 - Стрептокиназа | ||||
2 - Дигитоксин-Дигиталис | 2 - Кумадин | 6 - t-PA | ||||
Класс 2. Антиаритмическое средство | 3 - Гепарин | |||||
0 - Не указано | Класс 7. Бета-блокаторы | |||||
1 - Дисопирамид | 0 - Не указано | 3 - Метопролол | ||||
2 - Хинидин | 1 - Пропранолол | 4 - Пиндолол | ||||
3 - Прокаинамид | 2 - Коргард | 5 - Ацебутолол | ||||
4 - Лидокаин | Класс 8. Психотропные | |||||
5 - Фенитоин | 0 - Не указано | |||||
6 - Дилантин | 1 - Трициклический антидепрессант | |||||
7 - Амиодарон | 2 - Фенотиазин | |||||
8 - Токайнид | 3 - Барбитурат | |||||
9 - Другое | Класс 9. Блокаторы кальция | |||||
10 - Энкаинид | 0 - Не указано | |||||
11 - Мекситил/Мексилетин | 1 - Нифедипин | |||||
12 - Флекаинид | 2 - Верапамил | |||||
13 - Лоркаинид | Класс 10. Антигипотензивные | |||||
Класс 3. Диуретики | 0 - Не указано | |||||
0 - Не указано | 1 - Астматический препарат | |||||
1 - Тиазид | 2 - Аминофиллин | |||||
2 - Фуросемид (Лазикс) | 3 - Изупрел | |||||
3 - Хлористый калий | Класс 11. Гиполипидемические | |||||
Класс 4. Противогипертонические средства | 0 - Не указано | |||||
0 - Не указано | 1 - Холестид | |||||
1 - Клонидин | 2 - Ловастатин | |||||
2 - Празозин | 3 - Симвастатин | |||||
3 - Гидралазин | 4 - Фибрат | |||||
Класс 5. Антиангинальное средство | Класс 12. Ингибиторы АПФ | |||||
0 - Не указано | 0 - Не указано | |||||
1 - Изосорбид | 1 - Каптоприл | |||||
2 - Блокаторы кальция | ||||||
3 - Нитраты | ||||||
11 | 2 | Систолическое давление крови (двоичные значения) | ||||
Байты | Содержание | |||||
1, 2 | Двоичное. Систолическое давление крови в миллиметрах ртутного столба | |||||
Продолжение таблицы 4
Тег | Длина | Значение (данные параметра) | |||
12 | 2 | Диастолическое давление крови (двоичные значения) | |||
Байты | Содержание | ||||
1, 2 | Двоичное. Диастолическое давление крови в миллиметрах ртутного столба | ||||
13 | Длина | Диагноз или указание направления к специалисту (текстовые символы) Данное поле содержит текстовое описание диагноза пациента или направления к специалисту | |||
14 | Длина | Идентификатор машины снимающего устройства (двоичные байты и текстовые символы) Данное поле однозначно идентифицирует устройство, снявшее ЭКГ. Оно использует следующую общую структуру данных для описания характеристик устройства, которая также используется в теге 15. | |||
Байты | Содержание | ||||
1, 2 | Двоичное. Номер медицинской организации. | ||||
3, 4 | Двоичное. Номер отделения. | ||||
5, 6 | Двоичное. Идентификатор устройства. | ||||
7 | Двоичное. Тип устройства | ||||
Значение | Тип | ||||
0 | Картирующее устройство | ||||
1 | Вычислительная система (или сервер) | ||||
8 | Двоичное. Положено равным 255, см. строку символов производителя в конце тега 14. | ||||
Примечание - Унаследованные устройства использовали этот байт для указания кода производителя. Эти коды не должны больше использоваться, за исключением идентифицирующих унаследованных файлов. В исторических целях ниже приведены ранее присвоенные коды: | |||||
0 - Не известен | 8 - Mortara instruments | 16 - ESA-OTE | |||
1 - Burdick | 9 - Nihon Kohden | 17 - Schiller | |||
2 - Cambridge | 10 - Okin | 18 - Picker-Schwarzer | |||
3 - Compumed | 11 - Quinton | 19 - et medical devices (ex Elettronica-Trentina) | |||
4 - Datamed | 12 - Siemens | ||||
5 - Fukuda | 13 - Spacelabs | 20 -  | |||
6 - Hewlett-Packard | 14 - Telemed | 21 по 99 - Зарезервировано | |||
7 - Marquette electronics | 15 - Hellige | 100 - Другое | |||
С 9 по 14 | Текстовые символы. Текстовое описание модели. До 5 байтов текста и завершающее значение NULL | ||||
15 | Двоичное. Номер версии протокола SCP-ECG (точка должна быть удалена; версия 1.0 становится 10; версии должны быть максимально возможно обратно совместимы). Этот номер должен точно ссылаться на письменный документ, описывающий фактическую версию протокола | ||||
16 | Двоичное. Уровень совместимости протокола SCP-ECG (1 байт). Подробная спецификация приведена в приложении B (см. B.4) | ||||
17 | Двоичное. Код поддержки языка (1 байт). Поддерживаемые наборы символов представлены в следующей битовой карте: | ||||
Продолжение таблицы 4
Тег | Длина | Значение (данные параметра) | ||||||||||
Бит 0 | Бит 1 | Бит 2 | Бит 3 | Бит 4 | Бит 5 | Бит 6 | Бит 7 | Представление | ||||
1 | X | X | X | X | X | X | X | Только 8-битовый ASCII | ||||
1 | 0 | X | X | X | X | X | X | ISO-8859-1 Latin-1 | ||||
1 | 1 | 0 | 0 | 0 | 0 | 0 | 0 | ISO-8859-2 Latin-2 (Центральная и Восточная Европа) | ||||
1 | 1 | 0 | 1 | 0 | 0 | 0 | 0 | ISO-8859-4 Latin-4 (Балтика) | ||||
1 | 1 | 0 | 0 | 1 | 0 | 0 | 0 | ISO-8859-5 Кириллица | ||||
1 | 1 | 0 | 1 | 1 | 0 | 0 | 0 | ISO-8859-6 Арабский | ||||
1 | 1 | 0 | 0 | 0 | 1 | 0 | 0 | ISO-8859-7 Греческий | ||||
1 | 1 | 0 | 1 | 0 | 1 | 0 | 0 | ISO-8859-8 Иудейский | ||||
1 | 1 | 0 | 0 | 1 | 1 | 0 | 0 | ISO-8859-11 Тайский | ||||
1 | 1 | 0 | 1 | 1 | 1 | 0 | 0 | ISO-8859-15 Latin-9 (обновление Latin-1, также называется "Latin-0") | ||||
1 | 1 | 1 | 0 | 0 | 0 | 0 | 0 | ISO/IEC 10646 | ||||
1 | 1 | 1 | 1 | 0 | 0 | 0 | 0 | JIS X 0201-1976 (Японский) | ||||
1 | 1 | 1 | 0 | 1 | 0 | 0 | 0 | JIS X 0208-1997 (Японский) | ||||
1 | 1 | 1 | 1 | 1 | 0 | 0 | 0 | JIS X 0212-1990 (Японский) | ||||
1 | 1 | 1 | 0 | 0 | 1 | 0 | 0 | GB 2312-80 (Китайский) | ||||
1 | 1 | 1 | 1 | 0 | 1 | 0 | 0 | KS C5601-1987 (Корейский) | ||||
1 | 1 | 1 | 0 | 1 | 1 | 0 | 0 | Зарезервировано | ||||
1 | 1 | 1 | 1 | 1 | 1 | 0 | 0 | Зарезервировано | ||||
X | X | X | X | X | X | 0 | 1 | Зарезервировано | ||||
X | X | X | X | X | X | 1 | 0 | Зарезервировано | ||||
X | X | X | X | X | X | 1 | 1 | Зарезервировано (за исключением следующей записи) | ||||
1 | 1 | 1 | 1 | 1 | 1 | 1 | 1 | Специфичен для производителя | ||||
Продолжение таблицы 4
Тег | Длина | Значение (данные параметра) | |||
18 | Двоичное. Функциональные возможности устройства ЭКГ (однобайтовая битовая карта). Эта битовая карта указывает поддерживаемые функции: | ||||
Биты | Содержание | ||||
Сброшен (0) | Установлен (1) | ||||
С 0 по 3 | Зарезервировано | Зарезервировано | |||
4 | Без печати | Может печатать ЭКГ-отчеты | |||
5 | Без анализа | Может интерпретировать ЭКГ | |||
6 | Без хранения | Может хранить записи ЭКГ | |||
7 (MSB) | Без снятия | Может снимать данные ЭКГ | |||
19 | Двоичное. Частота переменного тока сети питания (1 байт) | ||||
Значение | Содержание | ||||
0 | Не указано | ||||
1 | 50 Гц | ||||
2 | 60 Гц | ||||
С 20 по 35 | Зарезервировано для будущего использования | ||||
36 | Двоичное. Длина строки, содержащей номер версии программы анализа. Значение байта 36 должно быть не меньше 1. За байтом 36 должны следовать строки символов. Если та или иная строка символов является пустой, то должно быть указано единственное значение NULL | ||||
С 37 по *** | Строка символов. Номер версии программы анализа. Строка должна завершаться значением NULL | ||||
С *** по *** | Строка символов. Серийный номер устройства снятия. Строка символов должна завершаться значением NULL | ||||
С *** по *** | Строка символов. Идентификатор программного обеспечения системы устройства снятия. Строка символов должна завершаться значением NULL | ||||
С *** по *** | Строка символов. Идентификатор программного обеспечения реализации протокола SCP в устройстве снятия (максимум 24 символа и завершающий NULL). Строка символов должна завершаться значением NULL | ||||
С *** по *** | Строка символов. Производитель устройства снятия. Содержит зарегистрированное торговое наименование производителя. Строка символов должна завершаться значением NULL | ||||
Продолжение таблицы 4
Тег | Длина | Значение (данные параметра) | |
15 | Длина | Идентификатор машины анализирующего устройства (двоичные байты и текстовые символы) Данное поле уникально идентифицирует устройство, анализирующее ЭКГ (если оно отличается от снимающего кардиографа). Формат данного поля идентичен формату, использованному для тега 14 | |
16 | Длина | Описание снявшей медицинской организации (текстовые символы) Данное поле предоставляет текстовое описание медицинской организации, снявшей ЭКГ | |
17 | Длина | Описание анализирующей медицинской организации (текстовые символы) Данное поле предоставляет текстовое описание медицинской организации, в которой был проведен анализ ЭКГ | |
18 | Длина | Описание снявшего отделения (текстовые символы) Данное поле предоставляет текстовое описание отделения, в котором была снята ЭКГ | |
19 | Длина | Описание анализирующего отделения (текстовые символы) Данное поле предоставляет текстовое описание отделения, в котором был проведен анализ ЭКГ | |
20 | Длина | Направивший врач (текстовые символы) Данное поле предоставляет текстовое описание направившего врача | |
21 | Длина | Самый последний подтверждающий врач (текстовые символы) Данное поле предоставляет текстовое описание самого последнего подтверждающего врача | |
22 | Длина | Описание лаборанта (текстовые символы) Данное поле предоставляет текстовое описание лаборанта | |
23 | Длина | Описание помещения (текстовые символы) Данное поле предоставляет текстовое описание помещения, в котором была записана ЭКГ | |
24 | 1 | Код срочности ЭКГ (двоичные значения) | |
Байты | Содержание | ||
1 | Двоичное. Уровень срочности. Значение 0 - это "обычный" уровень, а более высокие значения уровней связаны с повышением срочности, определяемой пользователем. Рекомендуется использовать диапазон кодов от 1 до 10 | ||
25 | 4 | Дата снятия (двоичные значения) Данное поле имеет следующий формат: | |
Байты | Содержание | ||
1, 2 | Двоичное. Год (полное целочисленное обозначение, например, 1990) | ||
3 | Двоичное. Месяц (диапазон от 01 до 12: 01 - Январь). | ||
4 | Двоичное. День (диапазон от 01 до 31) | ||
26 | 3 | Время снятия (двоичные значения) Данное поле имеет следующий формат: | |
Байты | Содержание | ||
1 | Двоичное. Часы (диапазон от 00 до 23). | ||
2 | Двоичное. Минуты (диапазон от 00 до 59). | ||
3 | Двоичное. Секунды (диапазон от 00 до 59). | ||
Время снятия должно быть выражено как местное время в часовом поясе снятия (см. тег 34) | |||
27 | 2 | Фильтр изолинии (двоичные значения) Данное поле содержит "частоту среза" (-3 дБ) высокочастотного фильтра изолинии в единицах (1/100) герц | |
28 | 2 | Низкочастотный фильтр (двоичные значения) Данное поле содержит "частоту среза" (-3 дБ) низкочастотного фильтра в герцах | |
Продолжение таблицы 4
Тег | Длина | Значение (данные параметра) | |||
29 | 1 | Битовая карта фильтра (двоичные значения) Данное поле указывает, использовались ли при обработке ЭКГ другие фильтры, которые не были определены тегами 27 и 28. Эти биты имеют следующее определение: | |||
0 | Режекторный фильтр 60 герц. | ||||
1 | Режекторный фильтр 50 герц. | ||||
2 | Фильтр артефактов. | ||||
3 | Фильтр изолинии (например, адаптивный фильтр или сплайн-фильтр). | ||||
С 4 по 7 | Не определено. | ||||
Если все биты равны нулю, то настройка фильтра не указана | |||||
30 | Длина | Поле произвольного текста (текстовые символы) Данное поле позволяет вносить комментарии, написанные произвольным текстом, передаваемые вместе с ЭКГ | |||
31 | Длина | Порядковый номер (текстовые символы) Порядковый номер ЭКГ | |||
32 | Длина | Коды диагнозов в анамнезе (двоичные значения) Данное поле содержит описание клинических проблем пациента и диагнозов. На количество диагнозов ограничений нет. Каждый диагноз должен быть представлен одним байтом. Байт 1 используется для обозначения применяемой таблицы кодов заболеваний. Если байт 1 не равен нулю, то это означает, что таблица кодов заболеваний не определена. Если этот байт равен нулю (0), то применяется следующий набор кодов: | |||
Значение | Содержание | ||||
0 | Диагнозы или клинические проблемы не указаны. | ||||
1 | Является очевидно здоровым. | ||||
10 | Острый инфаркт миокарда. | ||||
11 | Инфаркт миокарда. | ||||
12 | Предыдущие случаи инфаркта миокарда. | ||||
15 | Ишемическая болезнь сердца. | ||||
18 | Болезнь периферических сосудов. | ||||
20 | Порок сердца синего типа. | ||||
21 | Врожденный порок сердца бледного типа. | ||||
22 | Порок клапана сердца. | ||||
25 | Повышенное кровяное давление. | ||||
27 | Нарушение мозгового кровообращения. | ||||
30 | Кардиомиопатия. | ||||
35 | Перикардит. | ||||
36 | Миокардит. | ||||
40 | Послеоперационное состояние сердца. | ||||
42 | Вживленный кардиостимулятор. | ||||
45 | Эмболия легких. | ||||
50 | Респираторное заболевание. | ||||
55 | Эндокринное заболевание. | ||||
60 | Неврологическое заболевание. | ||||
65 | Алиментарное заболевание. | ||||
70 | Заболевание почек. | ||||
80 | Предоперационное состояние общей хирургии. | ||||
81 | Послеоперационное состояние общей хирургии. | ||||
90 | Общемедицинский. | ||||
100 | Другое. | ||||
С 128 по 255 | Специфичное для производителя. | ||||
Отсутствующие числа в серии от 1 до 100 зарезервированы для будущего расширения некоторых категорий | |||||
33 | 2 | Код конфигурации электродов (двоичные значения) Данное поле используется для идентификации размещения и системы электродов. | |||
Байты | Содержание | ||||
1 | Двоичное. Код, представляющий определения системы размещений электродов для ЭКГ в 12 отведениях (стандартная, Масон-Ликар, Omnitrode и т.п.). | ||||
Значение | Система размещения электродов | ||||
0 | Не указано. | ||||
Примечание - Картирующие устройства, не записывающие информацию о размещении электродов, должны использовать 0. | |||||
Продолжение таблицы 4
Тег | Длина | Значение (данные параметра) | |||||
33 | 2 | 1 | Стандартные положения для 12 отведений: RA, RL, LA и LL размещены на конечностях. V1 - V6 в стандартных положениях на груди. Все электроды размещаются индивидуально. | ||||
2 | RA, RL, LA и LL размещаются на туловище (положения по Масону - Ликару). V1 - V6 в стандартных положениях на груди. Все электроды размещаются индивидуально. | ||||||
3 | RA, RL, LA и LL размещаются на туловище (положения по Масону - Ликару). Электроды конечностей размещаются индивидуально. V1 - V6 размещаются на груди, как часть электродного пояса (V1 - V6 НЕ размещаются индивидуально). | ||||||
4 | RA, RL, LA, LL и V1 - V6 (все электроды) размещаются на груди в одном электродном поясе (как Omnitrode). (Никакие из электродов не размещаются индивидуально). | ||||||
5 | ЭКГ в 12 отведениях получена из отведений Франка XYZ. | ||||||
6 | ЭКГ в 12 отведениях получена из нестандартных отведений. | ||||||
С 7 по 255 | Еще не определены. Зарезервированы для будущего использования. | ||||||
2 | Двоичное. Код, представляющий определения для системы размещений электродов для отведений XYZ, например Франк, Cube, McFee-Parungao, биполярные и т.п. [По вопросам размещения электродов на теле и уравновешивающих резисторов см. главу 1 книги Vectorcardiography (Alberto Benchimol, Williams & Wilkins, Baltimore, 1973).] | ||||||
Значения | Система размещения электродов | ||||||
0 | Не указано. Примечание - Картирующие устройства, не записывающие информацию о размещении электродов, должны использовать 0. | ||||||
1 | Система отведений Франка (Frank, 1959; 13:737). | ||||||
2 | Система отведений McFee-Parungao (см. Benchimol, Vectorcardiography. Williams & Wilkins, Baltimore, 1973, страница 6, рисунок 1.6). | ||||||
3 | Система отведений Cube (Grishman et al, Amer. Heart J. 1951; 41, стр. 483). | ||||||
4 | Система отведений XYZ биполярная нескорректированная (bipolar uncorrected). | ||||||
5 | Система отведений XYZ псевдоортогональная (как используется в холтеровских записях). | ||||||
6 | Отведения XYZ, полученные из стандартной ЭКГ в 12 отведений. | ||||||
С 7 по 255 | Еще не определены. Зарезервированы для будущего использования | ||||||
34 | Длина | Часовой пояс (двоичные байты и текстовые символы) Содержание данного тега идентифицирует глобальный часовой пояс, в котором были собраны данные, тем самым позволяя осуществить преобразование указанного с помощью тегов 25 и 26 времени в любой часовой пояс (например, UTC). Следующие байты параметров данного тега предоставляют три способа указания часового пояса. | |||||
Байт | Название | Тип | Примечания | ||||
1, 2 | Сдвиг | Двоичное со знаком | Часовой пояс, указанный как смещение от UTC в минутах (примечание 1). | ||||
3, 4 | Индекс | Двоичное без знака | Часовой пояс, указанный с помощью отображения, определенного производителем (до тех пор, пока не будет определено согласованное отображение с помощью байтов с 1 по 1000), используя это значение как индекса в следующей справочной таблице (примечание 2). | ||||
Значение | Описание | ||||||
0 | Индекс не используется | ||||||
С 1 по 1000 | Зарезервировано для будущего использования | ||||||
С 1001 по 32 766 | Специфичный для производителя | ||||||
32 766 | Зарезервировано | ||||||
с 5 по *** | Описание | Текстовая строка | Часовой пояс, указанный с помощью строки, завершающейся NULL (примечание 3). | ||||
Окончание таблицы 4
5.5.1 Если этот раздел присутствует, то он должен начинаться с "ID заголовка раздела" в соответствии с 5.2.7.
5.5.2 Схема для сжатия сигнала, представленная ниже, основана на методе кодирования Хаффмана. Данный метод не является единственным возможным, но является рекомендуемым.
5.5.3 Данный раздел записи ЭКГ содержит определение кодовых таблиц Хаффмана, которые использовались для кодирования ЭКГ. Предоставление нескольких таблиц позволяет осуществлять оптимальное кодирование данных (например, для сжатия эталонного цикла и данных ритма, скорее всего, будут использованы разные таблицы). Следует предполагать, что при кодировании данных каждого элемента использовалась таблица N 1 (т.е. первая таблица, определенная в этом разделе 2). Для перехода к другой таблице должны использоваться управляющие коды.
1) Базовое время считываний, определенное в разделе, описывающем закодированные данные (т.е. разделе 5 "Данные эталонного цикла" и разделе 6 "Данные ритма").
2) Базовая амплитуда ЭКГ, как она определена в разделе, описывающем закодированные данные (т.е. в разделе 5 "Данные эталонного цикла" и разделе 6 "Данные ритма").
Соответственно, структура данных, описанная в настоящем пункте, имеет следующий вид:
Байты | Содержание | ||
1, 2 | Число определенных таблиц Хаффмана (если оно равно 19999, то используется таблица по умолчанию, определенная в C.3.7.6). | ||
3, 4 | Число кодовых структур в таблице N 1. | ||
С 5 по *** | Структуры, определяющие каждый код в таблице N 1. Каждая из структур имеет следующий формат: | ||
1 байт | Число битов в префиксе. | ||
1 байт | Число битов во всем коде. | ||
1 байт | Режим переключения таблицы. | ||
Значение | Содержание | ||
0 | Переключиться на другую таблицу Хаффмана. | ||
1 | Кодирование Хаффмана, если число битов в префиксе равно числу битов во всем коде. | ||
1 | Исходные данные, если число битов в префиксе меньше числа битов во всем коде. | ||
2 байта | Базовое значение, представленное базовым кодом [в единицах множителя величины амплитуды (AVM)]. | ||
4 байта | Базовый код - первый бит в коде, представленный младшим значащим битом 4-байтовой области. | ||
*** + 1, *** + 2 | Число структур в таблице N 2. | ||
С *** + 3 по *** и т.д. | Структуры, представляющие таблицу N 2. | ||
Коды Хаффмана были определены, чтобы разрешить отдельной структуре, описанной выше, задавать серии последовательных значений амплитуды. Упомянутый выше "префикс" является общим для всех кодов, описывающих последовательные значения - оставшееся битовое поле изменяется на один младший значащий бит (LSB) при его приращении в указанном диапазоне.
Пример байтовой структуры кода Хаффмана для этого случая показан в таблице 5.
Таблица 5
Пример байтовой структуры (код Хаффмана)
MSB | LSB | |||||||
Принятый байт 1 | P1 | P2 | P3 | P4 | C1 | C2 | C3 | C4 |
Принятый байт 2 | C5 | C6 | P5 | P6 | P7 | C7 | C8 | C9 |
Принятый байт 3 | C10 | C11 | P8 | P9 | P10 | C12 | C13 | C14 |
И т.д. | ... | ... | ... | ... | ... | ... | ... | ... |
Примечание - Данный пример представляет следующие закодированные значения:
P1 P2 P3 P4 C1 C2 C3 C4 C5 C6
4-битовый префикс для общей длины кода 10.
P5 P6 P7 C7 C8 C9 C10 C11
3-битовый префикс для общей длины кода 8.
P8 P9 P10 C12 C13 C14
3-битовый префикс для общей длины кода 6.
Следует учесть, что "выбор" битов в заданном байте осуществляется от старшего значащего к младшему значащему и что обработка байтов осуществляется в том порядке, в котором они были получены.
Управляющие коды, т.е. коды, которые диктуют смену таблицы Хаффмана, должны включать в себя нулевое значение (0) "переключателя режима таблицы". "Базовое значение" должно в таком случае содержать номер таблицы, на которую необходимо переключиться.
Обзор данных этого раздела представлен на рисунке 5.
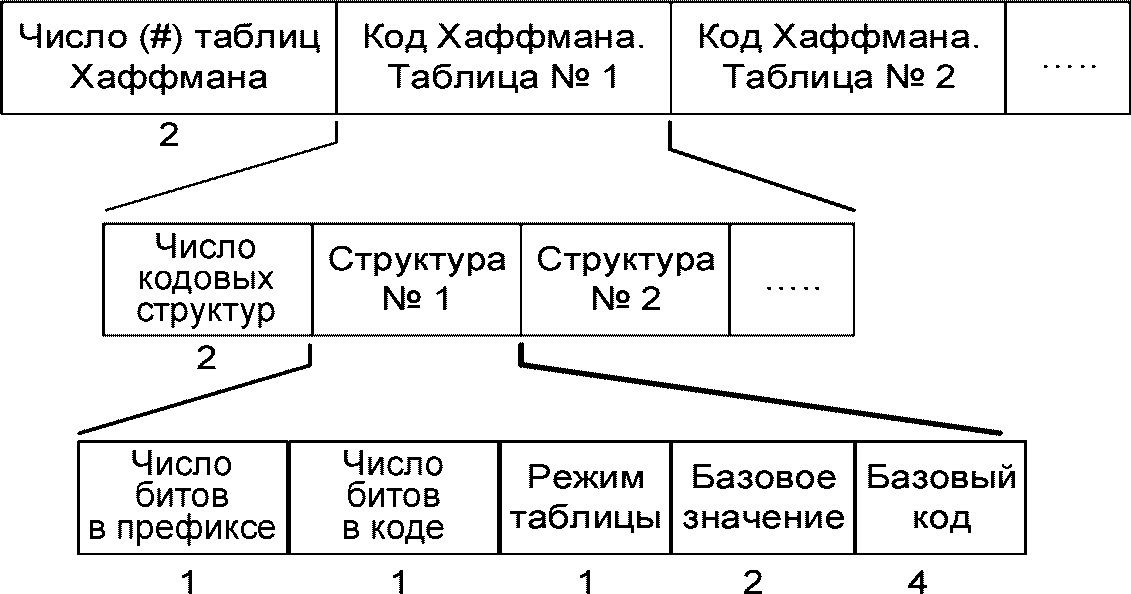
Рисунок 5 - Обзор структуры раздела таблиц Хаффмана
5.6.1 Данный раздел определяет отведения, которые передаются вместе с некоторой общей административной информацией.
5.6.2 Если данный раздел присутствует, то он должен начинаться с "ID заголовка раздела" в соответствии с 5.2.7.
Байты | Содержание | |
1 | Число включенных отведений. | |
2 | Байт флага: | |
Бит 0 (LSB) | Установлен = вычитание эталонного цикла используется для сжатия. Сброшен = вычитание эталонного цикла не используется для сжатия. | |
Бит 1 | Зарезервированный. | |
Бит 2 | Установлен = все отведения записываются одновременно. Сброшен = не все отведения записываются одновременно. | |
Биты с 3 по 7 | Число одновременно записываемых отведений. | |
с 3 по 11 | Подробное описание первого отведения (см. 5.6.4). | |
с 12 по 20 и т.д. | Подробное описание второго отведения (см. 5.6.4) | |
Если не все отведения записываются одновременно, то эти отведения должны быть представлены в группах, соответствующих тем отведениям, что записаны одновременно.
Пример - Тройки отведений записываются одновременно: например, первая тройка отведений I, aVF, V2; вторая тройка отведений X, Y, Z и т.д. Детальная информация об отведениях должна быть приведена в описанном выше порядке: отведение I в первом сегменте (с 3 по 11), отведение aVF во втором сегменте (с 12 по 20), отведение V2 в третьем сегменте (с 21 по 29), отведение X в четвертом сегменте (с 30 по 38) и т.д.
Для каждого отведения передается следующая детальная информация:
Байты | Содержание |
С 1 по 4 | Номер начального считывания (без знака). |
С 5 по 8 | Номер последнего считывания (без знака). |
9 | Идентификация отведения. Следует использовать схему нумерации, приведенную в таблице 6. |
Таблица 6
Коды идентификации отведений
Название в SCP-ECG | Код SCP-ECG | Описание | VITAL[12] Ref ID MDC_ECG_LEAD_xxx |
0 | Неспецифицированное отведение | MDC_ECG_LEAD_CONFIG | |
I | 1 | Отведение I | MDC_ECG_LEAD_I |
II | 2 | Отведение II | MDC_ECG_LEAD_II |
V1 | 3 | V1 | MDC_ECG_LEAD_V1 |
V2 | 4 | V2 | MDC_ECG_LEAD_V2 |
V3 | 5 | V3 | MDC_ECG_LEAD_V3 |
V4 | 6 | V4 | MDC_ECG_LEAD_V4 |
V5 | 7 | V5 | MDC_ECG_LEAD_V5 |
V6 | 8 | V6 | MDC_ECG_LEAD_V6 |
V7 | 9 | V7 | MDC_ECG_LEAD_V7 |
V2R <a> | 10 | V2R | MDC_ECG_LEAD_V2R |
V3R | 11 | V3R | MDC_ECG_LEAD_V3R |
V4R | 12 | V4R | MDC_ECG_LEAD_V4R |
V5R | 13 | V5R | MDC_ECG_LEAD_V5R |
V6R | 14 | V6R | MDC_ECG_LEAD_V6R |
V7R | 15 | V7R | MDC_ECG_LEAD_V7R |
X | 16 | X <b> | MDC_ECG_LEAD_X |
Y | 17 | Y <b> | MDC_ECG_LEAD_Y |
Z | 18 | Z <b> | MDC_ECG_LEAD_Z |
CC5 <c> | 19 | CC5, для позиций V5 и V5R | MDC_ECG_LEAD_CC5 |
CM5 | 20 | CM5, для позиции V5 | MDC_ECG_LEAD_CM5 |
LA | 21 | Левая рука | MDC_ECG_LEAD_LA |
RA | 22 | Правая рука | MDC_ECG_LEAD_RA |
LL | 23 | Левая нога | MDC_ECG_LEAD_LL |
fI <d> | 24 | fI | MDC_ECG_LEAD_fI |
fE | 25 | fE | MDC_ECG_LEAD_fE |
fC | 26 | fC | MDC_ECG_LEAD_fC |
fA | 27 | fA | MDC_ECG_LEAD_fA |
fM | 28 | fM | MDC_ECG_LEAD_fM |
fF | 29 | fF | MDC_ECG_LEAD_fF |
fH | 30 | fH | MDC_ECG_LEAD_fH |
dI | 31 | Производное отведение I | MDC_ECG_LEAD_dI |
dII | 32 | Производное отведение II | MDC_ECG_LEAD_dII |
dV1 | 33 | Производное отведение V1 | MDC_ECG_LEAD_dV1 |
dV2 | 34 | Производное отведение V2 | MDC_ECG_LEAD_dV2 |
dV3 | 35 | Производное отведение V3 | MDC_ECG_LEAD_dV3 |
dV4 | 36 | Производное отведение V4 | MDC_ECG_LEAD_dV4 |
dV5 | 37 | Производное отведение V5 | MDC_ECG_LEAD_dV5 |
dV6 | 38 | Производное отведение V6 | MDC_ECG_LEAD_dV6 |
dV7 | 39 | Производное отведение V7 | |
dV2R | 40 | Производное отведение V2R | |
dV3R | 41 | Производное отведение V3R | |
dV4R | 42 | Производное отведение V4R | |
dV5R | 43 | Производное отведение V5R | |
dV6R | 44 | Производное отведение V6R | |
dV7R | 45 | Производное отведение V7R | |
dX | 46 | Производное отведение X | |
dY | 47 | Производное отведение Y | |
dZ | 48 | Производное отведение Z | |
dCC5 | 49 | Производное отведение CC5 | |
dCM5 | 50 | Производное отведение CM5 | |
dLA | 51 | Производное отведение LA | |
dRA | 52 | Производное отведение RA | |
dLL | 53 | Производное отведение LL | |
dfI | 54 | Производное отведение fI | |
dfE | 55 | Производное отведение fE | |
dfC | 56 | Производное отведение fC | |
dfA | 57 | Производное отведение fA | |
dfM | 58 | Производное отведение fM | |
dfF | 59 | Производное отведение fF | |
dfH | 60 | Производное отведение fH | |
III | 61 | Отведение III | MDC_ECG_LEAD_III |
aVR | 62 | aVR, усиленное отведение от правой руки | MDC_ECG_LEAD_AVR |
aVL | 63 | aVL, усиленное отведение от левой руки | MDC_ECG_LEAD_AVL |
aVF | 64 | aVF, усиленное отведение от левой ноги | MDC_ECG_LEAD_AVF |
aVRneg | 65 | aVRneg | MDC_ECG_LEAD_AVRneg |
V8 | 66 | V8 | MDC_ECG_LEAD_V8 |
V9 | 67 | V9 | MDC_ECG_LEAD_V9 |
V8R | 68 | V8R | MDC_ECG_LEAD_V8R |
V9R | 69 | V9R | MDC_ECG_LEAD_V9R |
D | 70 | D (по Небу - dorsalis) | MDC_ECG_LEAD_D |
A | 71 | A (по Небу - anterior) | MDC_ECG_LEAD_A |
J | 72 | J (по Небу - inferior) | MDC_ECG_LEAD_J |
Defib | 73 | Отведение дефибриллятора: передне-боковое | MDC_ECG_LEAD_DEFIB |
Extern | 74 | Отведение внешнего кардиостимулятора: передне-заднее | MDC_ECG_LEAD_EXTERN |
A1 | 75 | A1 (вспомогательное униполярное отведение #1) | MDC_ECG_LEAD_A1 |
A2 | 76 | A2 (вспомогательное униполярное отведение #2) | MDC_ECG_LEAD_A2 |
A3 | 77 | A3 (вспомогательное униполярное отведение #3) | MDC_ECG_LEAD_A3 |
A4 | 78 | A4 (вспомогательное униполярное отведение #4) | MDC_ECG_LEAD_A4 |
dV8 | 79 | Производное отведение V8 | |
dV9 | 80 | Производное отведение V9 | |
dV8R | 81 | Производное отведение V8R | |
dV9R | 82 | Производное отведение V9R | |
dD | 83 | Производное отведение D (по Небу - dorsalis) | |
dA | 84 | Производное отведение A (по Небу - anterior) | |
dJ | 85 | Производное отведение J (по Небу - inferior) | |
Chest | 86 | Грудное отведение | MDC_ECG_LEAD_C |
V | 87 | Прекордиальное отведение | MDC_ECG_LEAD_V |
VR | 88 | VR, не усиленное, вектор RA | MDC_ECG_LEAD_VR |
VL | 89 | VL, не усиленное, вектор LA | MDC_ECG_LEAD_VL |
VF | 90 | VF, не усиленное, вектор LL | MDC_ECG_LEAD_VF |
MCL | 91 | Модифицированное грудное отведение (индифферентный электрод на левой руке) | MDC_ECG_LEAD_MCL |
MCL1 | 92 | MCL, в позиции V1 | MDC_ECG_LEAD_MCL1 |
MCL2 | 93 | MCL, в позиции V2 | MDC_ECG_LEAD_MCL2 |
MCL3 | 94 | MCL, в позиции V3 | MDC_ECG_LEAD_MCL3 |
MCL4 | 95 | MCL, в позиции V4 | MDC_ECG_LEAD_MCL4 |
MCL5 | 96 | MCL, в позиции V5 | MDC_ECG_LEAD_MCL5 |
MCL6 | 97 | MCL, в позиции V6 | MDC_ECG_LEAD_MCL6 |
CC | 98 | Грудное отведение (симметричное размещение) | MDC_ECG_LEAD_CC |
CC1 | 99 | CC1, в позициях V1 и V1R | MDC_ECG_LEAD_CC1 |
CC2 | 100 | CC2, в позициях V2 и V2R | MDC_ECG_LEAD_CC2 |
CC3 | 101 | CC3, в позициях V3 и V3R | MDC_ECG_LEAD_CC3 |
CC4 | 102 | CC4, в позициях V4 и V4R | MDC_ECG_LEAD_CC4 |
CC6 | 103 | CC6, в позициях V6 и V6R | MDC_ECG_LEAD_CC6 |
CC7 | 104 | CC7, в позициях V7 и V8R | MDC_ECG_LEAD_CC7 |
CM | 105 | Грудинные отведения | MDC_ECG_LEAD_CM |
CM1 | 106 | CM1, в позиции V1 | MDC_ECG_LEAD_CM1 |
CM2 | 107 | CM2, в позиции V2 | MDC_ECG_LEAD_CM2 |
CM3 | 108 | CM3, в позиции V3 | MDC_ECG_LEAD_CM3 |
CM4 | 109 | CM4, в позиции V4 | MDC_ECG_LEAD_CM4 |
CM6 | 110 | CM6, в позиции V6 | MDC_ECG_LEAD_CM6 |
dIII | 111 | Производное отведение III | MDC_ECG_LEAD_dIII |
daVR | 112 | Производное отведение aVR | MDC_ECG_LEAD_daVR |
daVL | 113 | Производное отведение aVL | MDC_ECG_LEAD_daVL |
daVF | 114 | Производное отведение aVF | MDC_ECG_LEAD_daVF |
daVRneg | 115 | Производное отведение aVRneg | |
dChest | 116 | Производное отведение Chest | |
dV | 117 | Производное отведение V | |
dVR | 118 | Производное отведение VR | |
dVL | 119 | Производное отведение VL | |
dVF | 120 | Производное отведение VF | |
CM7 | 121 | CM7, в позиции V7 | MDC_ECG_LEAD_CM7 |
CH5 | 122 | CH5 | MDC_ECG_LEAD_CH5 |
CS5 | 123 | Отрицательное: правая подключичная ямка | MDC_ECG_LEAD_CS5 |
CB5 | 124 | Отрицательное: нижний угол правой лопатки | MDC_ECG_LEAD_CB5 |
CR5 | 125 | CR5 | MDC_ECG_LEAD_CR5 |
ML | 126 | ML, модифицированное стандартное отведение, ~ отведение II | MDC_ECG_LEAD_ML |
AB1 | 127 | AB1 (вспомогательное биполярное отведение #1) | MDC_ECG_LEAD_AB1 |
AB2 | 128 | AB2 (вспомогательное биполярное отведение #2) | MDC_ECG_LEAD_AB2 |
AB3 | 129 | AB3 (вспомогательное биполярное отведение #3) | MDC_ECG_LEAD_AB3 |
AB4 | 130 | AB4 (вспомогательное биполярное отведение #4) | MDC_ECG_LEAD_AB4 |
ES | 131 | EASITM ES <e> | MDC_ECG_LEAD_ES |
AS | 132 | EASI AS | MDC_ECG_LEAD_AS |
AI | 133 | EASI AI | MDC_ECG_LEAD_AI |
S | 134 | EASI верхнее грудинное отведение | MDC_ECG_LEAD_S |
dDefib | 135 | Производное отведение Defib: Отведение дефибриллятора: передне-боковое | |
dExtern | 136 | Производное отведение Extern: отведение внешнего кардиостимулятора передне-заднее | |
dA1 | 137 | Производное отведение A1 (вспомогательное униполярное отведение #1) | |
dA2 | 138 | Производное отведение A2 (вспомогательное униполярное отведение #2) | |
dA3 | 139 | Производное отведение A3 (вспомогательное униполярное отведение #3) | |
dA4 | 140 | Производное отведение A4 (вспомогательное униполярное отведение #4) | |
dMCL1 | 141 | Производное отведение MCL1: MCL, в позиции V1 | |
dMCL2 | 142 | Производное отведение MCL2: MCL, в позиции V2 | |
dMCL3 | 143 | Производное отведение MCL3: MCL, в позиции V3 | |
dMCL4 | 144 | Производное отведение MCL4: MCL, в позиции V4 | |
dMCL5 | 145 | Производное отведение MCL5: MCL, в позиции V5 | |
dMCL6 | 146 | Производное отведение MCL6: MCL, в позиции V6 | |
RL | 147 | Правая нога | MDC_ECG_LEAD_RL |
CV5RL | 148 | Собачье, в пятом межреберье над грудиной справа, в самой изогнутой части реберного хряща | MDC_ECG_LEAD_CV5RL |
CV6LL | 149 | Собачье, в шестом межреберье над грудиной слева, в самой изогнутой части реберного хряща | MDC_ECG_LEAD_CV6LL |
CV6LU | 150 | Собачье, в шестом межреберье на уровне реберно-хрящевых соединений слева | MDC_ECG_LEAD_CV6LU |
V10 | 151 | Собачье, над остистым отростком седьмого грудного позвонка | MDC_ECG_LEAD_V10 |
dMCL | 152 | Производное отведение MCL. Модифицированное грудное отведение (индифферентный электрод на левой руке) | |
dCC | 153 | Производное отведение CC. Грудное отведение (симметричная позиция) | |
dCC1 | 154 | Производное отведение CC1, в позициях V1 и V1R | |
dCC2 | 155 | Производное отведение CC2, в позициях V2 и V2R | |
dCC3 | 156 | Производное отведение CC3, в позициях V3 и V3R | |
dCC4 | 157 | Производное отведение CC4, в позициях V4 и V4R | |
dCC6 | 158 | Производное отведение CC6, в позициях V6 и V6R | |
dCC7 | 159 | Производное отведение CC7, в позициях V7 и V8R | |
dCM | 160 | Производное отведение CM, грудное-грудинное | |
dCM1 | 161 | Производное отведение CM1, в позиции V1 | |
dCM2 | 162 | Производное отведение CM2, в позиции V2 | |
dCM3 | 163 | Производное отведение CM3, в позиции V3 | |
dCM4 | 164 | Производное отведение CM4, в позиции V4 | |
dCM6 | 165 | Производное отведение CM6, в позиции V6 | |
dCM7 | 166 | Производное отведение CM7, в позиции V7 | |
dCH5 | 167 | Производное отведение CH5 | |
dCS5 | 168 | Производное отведение CS5: отрицательное: правая подключичная ямка | |
dCB5 | 169 | Производное отведение CB5: отрицательное: нижний угол правой лопатки | |
dCR5 | 170 | Производное отведение CR5 | |
dML | 171 | Производное отведение ML, модифицированное стандартное отведение, ~ отведение II | |
dAB1 | 172 | Производное отведение AB1 (вспомогательное биполярное отведение #1) | |
dAB2 | 173 | Производное отведение AB2 (вспомогательное биполярное отведение #2) | |
dAB3 | 174 | Производное отведение AB3 (вспомогательное биполярное отведение #3) | |
dAB4 | 175 | Производное отведение AB4 (вспомогательное биполярное отведение #4) | |
dES | 176 | Производное отведение ES. EASI <e> ES | |
dAS | 177 | Производное отведение AS. EASI AS | |
dAI | 178 | Производное отведение AI. EASI AI | |
dS | 179 | Производное отведение S. EASI верхнее грудинное отведение | |
dRL | 180 | Производное отведение RL: правая нога | |
dCV5RL | 181 | Производное отведение CV5RL. Собачье, в пятом межреберье над грудиной справа, в самой изогнутой части реберного хряща | |
dCV6LL | 182 | Производное отведение CV6LL. Собачье, в шестом межреберье над грудиной слева, в самой изогнутой части реберного хряща | |
dCV6LU | 183 | Производное отведение CV6LU. Собачье, в шестом межреберье на уровне реберно-хрящевых соединений слева | |
dV10 | 184 | Производное отведение V10. Собачье, над остистым отростком седьмого грудного позвонка | |
С 185 по 199 | Зарезервировано для будущих расширений | ||
С 200 по 255 | Специфично для производителя | ||
<a> V2R идентично отведению V1. Подобным же образом, отведение V1R (не приведено в таблице отведений) идентично отведению V2. <b> Отведения X, Y и Z могут записываться с помощью ортогональной системы, например, системы отведений Франка или McFee и т.п. <c> Биполярные отведения CM5, CH5, CS5, CC5, CB5, CR5 используемые вместе с нагрузочной ЭКГ. Macfarlane, Том 1, страница 323 [CX5?]. <e> Торговая марка EASITM, правообладателем которой является Philips. Изобретатель доктор Гордон Довер (Gordon Dower). Отведения: S, верхнее грудинное положение; E, нижнее грудинное положение (отведение Франка fE); A, в левой подмышечной линии над V6 (отведение Франка fA); I, в правой подмышечной линии над V6R (отведение Франка fI). Примечания 1 Схемы нумерации отведений могут быть расширены в будущих ревизиях протокола. | |||
5.6.4 Нумерация считываний должна начинаться с номера считываний 1 и ссылаться на все одновременно записываемые отведения. Чтобы преобразовать эти значения в единицы времени, следует учитывать частоту считываний соответствующего раздела данных (см. 5.8.3).
Например, если восемь отведений (I, II, V1 - V6) записываются одновременно в течение 10 сек. с частотой 500 считываний в секунду и хранятся таким же образом, то каждое отведение начинается со считывания 1 и заканчивается считыванием 5000.
Если отведения записываются в группах по три отведения в каждой, например, в течение 2,5 сек. с частотой 500 считываний в секунду, то отведения I, II и III начинаются со считывания 1 и заканчиваются считыванием 1250, а отведения aVR, aVL и aVF начинаются со считывания 1251.
5.6.5 Обзор данных этого раздела представлен на рисунке 6.
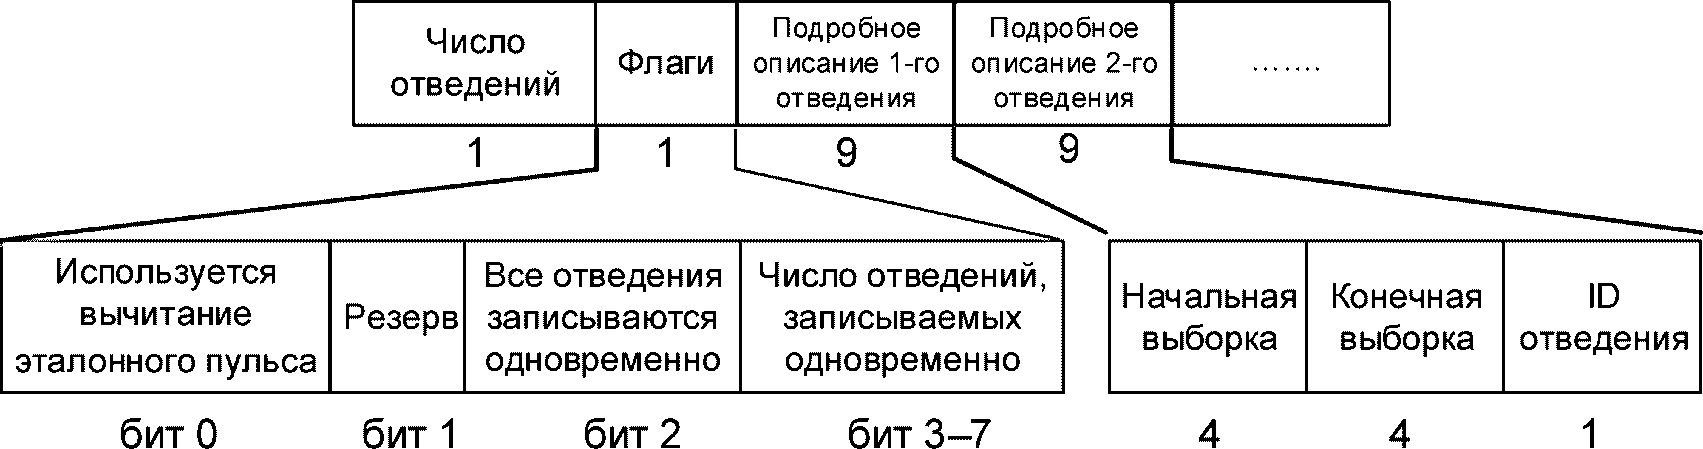
Рисунок 6 - Обзор части данных раздела определения
отведения ЭКГ
5.7.1 Если этот раздел присутствует, то он определяет местоположения и ширину различных комплексов QRS. Определение эталонного цикла, типов цикла и значимости эталонного цикла типа 0 см. в 5.1.11. Подробное описание общего процесса см. в приложении C.
5.7.2 Раздел должен начинаться с "ID заголовка раздела" в соответствии с 5.2.7.
5.7.3 Область заголовка данных раздела определяет конкретные величины, общие для всех отведений эталонного цикла типа 0. Остальные данные обозначают тип эталонного цикла и местоположение каждого комплекса QRS по отношению к "остаточному" сигналу. Область заголовка данных раздела имеет следующее содержание:
Байты | Содержание |
1, 2 | Длина данных эталонного цикла типа 0 в миллисекундах. Примечание - Число считываний N вычисляется в результате деления длины L эталонного цикла (в миллисекундах) на интервал времени между считываниями SI (в микросекундах, см. 5.9.3, байты 3, 4) по формуле 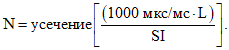 Производитель должен присвоить такую длину (в байтах от 1 до 2), чтобы при использовании этой формулы получилось требуемое число считываний эталонного цикла. Например, 1000 мс данных при 2000 мкс между считываниями дает N, равное 500 считываниям. |
3, 4 | Номер считывания (целое без знака), соответствующего опорной точке QRS-комплекса, относительно начала эталонного цикла типа 0. В приложении C эта точка сокращенно называется fcM. Первое считывание имеет номер 1. |
5, 6 | Общее число QRS-комплексов во всей записи ЭКГ. |
5.7.4 Приведенная ниже информация о местоположении зон вычитания эталонного цикла хранится в блоках по 14 байтов для каждого QRS-комплекса. Общее число блоков равно числу QRS-комплексов. Оно хранится в байтах с 5 по 6 области заголовка, см. 5.7.3.
Байты | Содержание |
1, 2 | Тип цикла первого QRS (определение "типа цикла" см. в 5.1.11). |
С 3 по 6 | Номер считывания <1> (целое без знака) остаточных данных, указывающий начало вычитания/сложения эталонного цикла 0 для первого QRS-комплекса, если комплекс имеет тип 0, иначе нулевое значение (0) <2>, <3>. |
--------------------------------
<1> Все номера считываний в данном разделе ссылаются на исходные считывания, сделанные перед обработкой для прореживания и/или сжатия. Первое считывание исходных данных нумеруется числом 1.
<2> Если байты 1, 2 указывают на эталонный цикл типа 0, то байты с 3 по 6 и с 11 по 14 выделяют область вокруг QRS-комплекса для вычитания или добавления эталонного цикла типа 0 в соответствии с указаниями и иллюстрациями, приведенными в приложении C. Границы этой области в приложении C сокращенно называются SB(k) и SE(k) соответственно.
<3> Если байты 1, 2 указывают на эталонный цикл не нулевого типа, то вычитание эталонного цикла не используется, в таком случае байты с 3 по 6 и с 11 по 14 содержат 0 (нуль).
С 7 по 10 | Номер считывания <1> (целое без знака) остаточных данных, указывающий опорную точку 1-го QRS-комплекса <2>. В приложении C данное местоположение сокращенно называется fc(1). |
С 11 по 14 | |
С 15 по 16 и т.д. | Тип цикла 2-го QRS-комплекса. |
5.7.5 Приведенная ниже информация по местоположению защищенных областей (QRS-комплексов) хранится в блоках по 8 байтов на каждый QRS-комплекс. Общее число блоков равно числу QRS-комплексов и хранится в байтах с 5 по 6 области заголовка <2>, см. 5.7.3.
Байты | Содержание |
С 1 по 4 | Номер считывания <1> (целое без знака) остаточных данных, указывающий начало защищенной области 1-го QRS-комплекса. В приложении C данное местоположение сокращенно называется QB(1). |
С 5 по 8 | Номер считывания <1> (целое без знака) остаточных данных, указывающий конец защищенной области 1-го QRS-комплекса. В приложении C данное местоположение сокращенно называется QE(1). |
С 9 по 12 | Номер считывания <1> (целое без знака) остаточных данных, указывающий начало защищенной области 2-го QRS-комплекса. В приложении C данное местоположение сокращенно называется QB(2). |
С 13 по 16 | Номер считывания <1> (целое без знака) остаточных данных, указывающий конец защищенной области 2-го QRS-комплекса. В приложении C данное местоположение сокращенно называется QE(2). |
и т.д. |
--------------------------------
<1> Все номера считываний в данном разделе ссылаются на исходные считывания, сделанные перед обработкой для прореживания и/или сжатия. Первое считывание исходных данных нумеруется числом 1.
<2> Блоки, описанные в 5.7.4 и 5.7.5, могут также использоваться для указания местоположения защищенных зон при использовании бимодального сжатия без вычитания эталонного цикла. В этом случае байты с 3 по 6 и с 11 по 14 блока, описанного в 5.7.4, должны иметь значение 0.
<3> Если байты 1, 2 указывают на эталонный цикл типа 0, то байты с 3 по 6 и с 11 по 14 выделяют область вокруг QRS-комплекса для вычитания или добавления эталонного цикла типа 0 в соответствии с указаниями и иллюстрациями, приведенными в приложении C. Границы этой области в приложении C сокращенно называются SB(k) и SE(k) соответственно.
<4> Если байты 1, 2 указывают на эталонный цикл не нулевого типа, то вычитание эталонного цикла не используется, в таком случае байты с 3 по 6 и с 11 по 14 содержат 0 (нуль).
5.7.6 Обзор данных этого раздела представлен на рисунке 7.
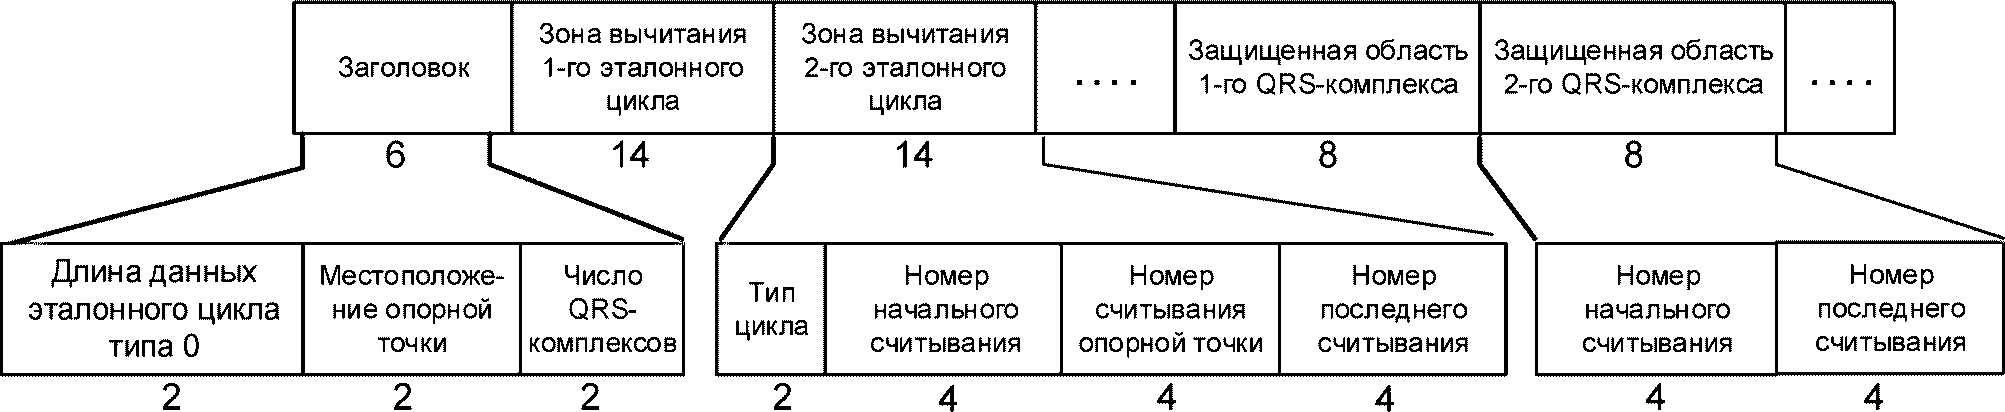
Рисунок 7 - Обзор структуры раздела 4
5.8.1 Данный раздел содержит подробное описание эталонного цикла типа 0. Определение эталонного цикла, типов эталонного цикла и значимости эталонного цикла типа 0 см. в 5.1.11. Детальное описание общего процесса см. в приложении C.
5.8.2 Если этот раздел присутствует, то он должен начинаться с "ID заголовка раздела" в соответствии с 5.2.7.
Байты | Содержание |
1, 2 | Множитель величины амплитуды (AVM). Используется следующим образом: Множитель значения амплитуды выражается в нановольтах (1·10-9 В). Пример - 1250 -> 1 квант амплитуды = 1,250 мкВ. 2441 -> 1 квант амплитуды = 2,441 мкВ. |
3, 4 | Интервал времени между считываниями для данного раздела выражается в микросекундах (1·10-6 с). Пример - 4000 -> 250 считываний/с; 1250 -> 800 считываний/с. |
5 | Данное значение следующим образом идентифицирует кодирование данных считываний: 0 = фактические (разность нулевого порядка) данные, используемые для данных эталонного цикла 0; 1 - данные разности первого порядка, используемые для данных эталонного цикла 0; 2 - данные разности второго порядка, используемые для данных эталонного цикла 0. |
6 | Зарезервировано. |
Примечания
1 Данные разности определяются как: [значение считываний (разность) в момент времени t] - [значение считываний (разность) в момент времени t - 1]. См. таблицу 7.
2 Для первых двух считываний в каждом отведении разности второго порядка в протоколе SCP-ECG не вычисляются. Амплитуды исходных значений этих считываний сохраняются. Значение первого считывания также сохраняется в потоке закодированных данных, использующем разности первого порядка.
3 Пример результатов, закодированных с помощью разностей второго порядка, приведен в таблице 8 для серии из восьми считываний.
4 Пример результатов, закодированных с помощью разностей первого порядка, приведен в таблице 9 для той же серии из восьми считываний.
Таблица 7
Исходные данные | Разности первого порядка | Разности второго порядка |
X(1) | D1(1) = X(1) | D2(1) = X(1) |
X(2) | D1(2) = X(2) - X(1) | D2(2) = X(2) |
X(3) | D1(3) = X(3) - X(2) | D2(3) = D1(3) - D1(2) = X(3) - 2*X(2) + X(1) |
X(4) | D1(4) = X(4) - X(3) | D2(4) = D1(4) - D1(3) = X(4) - 2*X(3) + X(2) |
Таким образом, общая формула для разности первого порядка имеет следующий вид
D1(n) = X(n) - X(n - 1).
Общая формула для разности второго порядка имеет следующий вид
D2(n) = X(n) - 2·X(n - 1) + X(n - 2).
Декодирование данных разности второго порядка выполняется по следующей формуле
X(n) = D2(n) + 2·X(n - 1) - X(n - 2).
Таблица 8
второго порядка
Номер считывания | n | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 |
Значение считывания | X(n) | 10 | 12 | 13 | 15 | 18 | 22 | 20 | 15 |
Разность 2-го порядка | D2(n) | - | - | -1 | 1 | 1 | 1 | -6 | -3 |
Закодированные данные | 10 | 12 | -1 | 1 | 1 | 1 | -6 | -3 |
Таблица 9
первого порядка
Номер считывания | n | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 |
Значение считывания | X(n) | 10 | 12 | 13 | 15 | 18 | 22 | 20 | 15 |
Разность 1-го порядка | D1(n) | - | 2 | 1 | 2 | 3 | 4 | -2 | -5 |
Закодированные данные | 10 | 2 | 1 | 2 | 3 | 4 | -2 | -5 |
5.8.4 Данные раздела содержат длины байтов закодированных отведений. Они имеют следующий формат:
Байты | Содержание |
1, 2 | Число байтов (целое без знака) в сжатых данных эталонного цикла 0 для первого закодированного отведения. |
3, 4 | Число байтов (целое без знака) в сжатых данных эталонного цикла 0 для второго закодированного отведения. |
и т.д. |
5.8.5 Затем следуют закодированные данные эталонного цикла 0. Если раздел 2 присутствует, то данные кодируются как последовательности кодов Хаффмана, взятых из раздела 2. Отведения кодируются в порядке, указанном в разделе 3. Если раздел 2 отсутствует, то данные ЭКГ (разностные или неразностные) должны иметь формат двухбайтовых целых чисел со знаком.
Могут быть применены другие форматы за счет предоставления "фиктивной" таблицы Хаффмана с одной структурой кода. Числу битов префикса должен быть присвоен нуль. Числу битов всего кода должно быть присвоено желаемое число битов в значении считывания.
5.8.6 Обзор данных этого раздела представлен на рисунке 8.
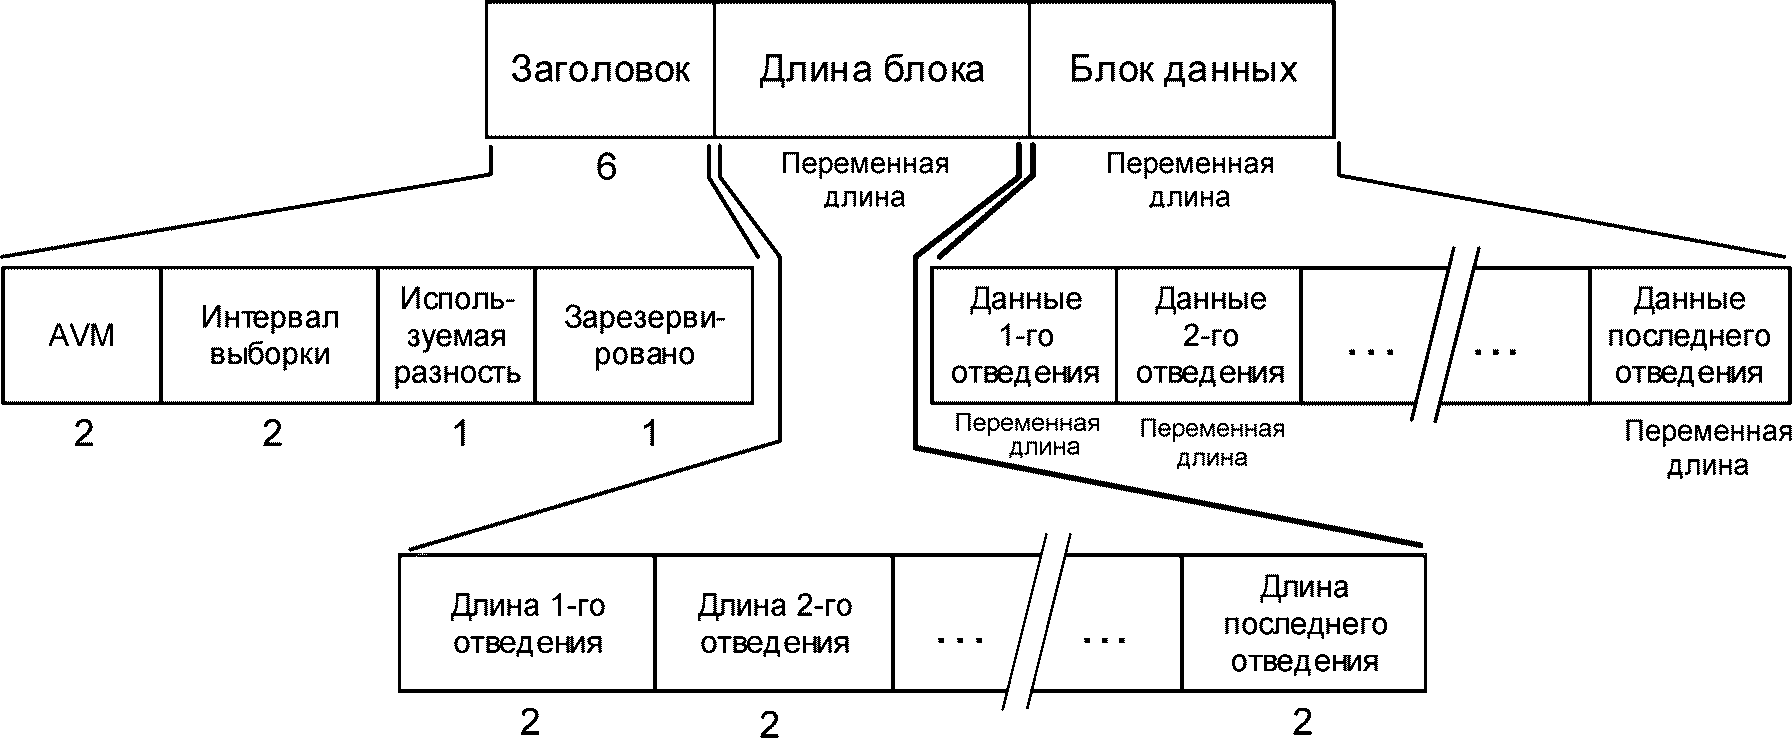
Рисунок 8 - Обзор структуры раздела закодированного
эталонного цикла типа 0
5.9.1 Данный раздел содержит либо:
1) все данные ритма ЭКГ целиком, если не было произведено никаких вычитаний эталонного цикла (см. 5.6.3, байт 2), либо
2) остаточный сигнал после вычитания эталонных циклов.
5.9.2 Если данный раздел присутствует, то он должен начинаться с "ID заголовка раздела" в соответствии с 5.2.7.
Байты | Содержание |
1, 2 | Множитель величины амплитуды (AVM). Используется следующим образом: Множитель величины амплитуды выражен в нановольтах (1·10-9 Вольт). Пример - 1250 -> 1 квант амплитуды = 1,250 мкВ. 2441 -> 1 квант амплитуды = 2,441 мкВ. |
3, 4 | Интервал времени считываний для данного раздела в микросекундах (1·10-6 с). Пример - 4000 -> 250 считываний/с. 1250 -> 800 считываний/с. |
5 | Данное значение следующим образом идентифицирует кодирование данных считываний: 0 - фактические (разность нулевого порядка) данные, используемые для данных ритма; 1 - разности первого порядка, используемые для данных ритма; 2 - разности второго порядка, используемые для данных ритма. |
6 | Данное значение следующим образом идентифицирует сжатие данных ритма: 0 - бимодальное сжатие не используется; 1 - бимодальное сжатие используется. |
Примечание - Если используется бимодальное сжатие, то интервал времени защищенной области считываний соответствует указанному в 5.8.3, но AVM такой, как в байтах 1 и 2 из настоящего пункта. За пределами защищенной области, AVM и интервал времени считываний соответствуют байтам с 1 по 4 из настоящего пункта.
5.9.4 Данные этого раздела содержат длины байтов закодированных отведений, имеющие следующий формат:
Байты | Содержание |
1, 2 | Число байтов (целое без знака) сжатых данных ритма для первого закодированного отведения. |
3, 4 | Число байтов (целое без знака) сжатых данных ритма для второго закодированного отведения. |
5.9.5 Затем следуют данные ритма. Если раздел 2 присутствует, то эти данные кодируются как последовательности кодов Хаффмана, взятых из раздела 2. Отведения кодируются в порядке, указанном в разделе 3. Если раздел 2 отсутствует, то данные ЭКГ (разностные или неразностные) должны иметь формат двухбайтовых целых чисел со знаком.
Могут быть применены другие форматы за счет предоставления "фиктивной" таблицы Хаффмана с одной структурой кода. Числу битов префикса должен быть присвоен нуль. Числу битов всего кода должно быть присвоено желаемое число битов в значении считывания.
5.9.6 Обзор данных этого раздела представлен на рисунке 9.
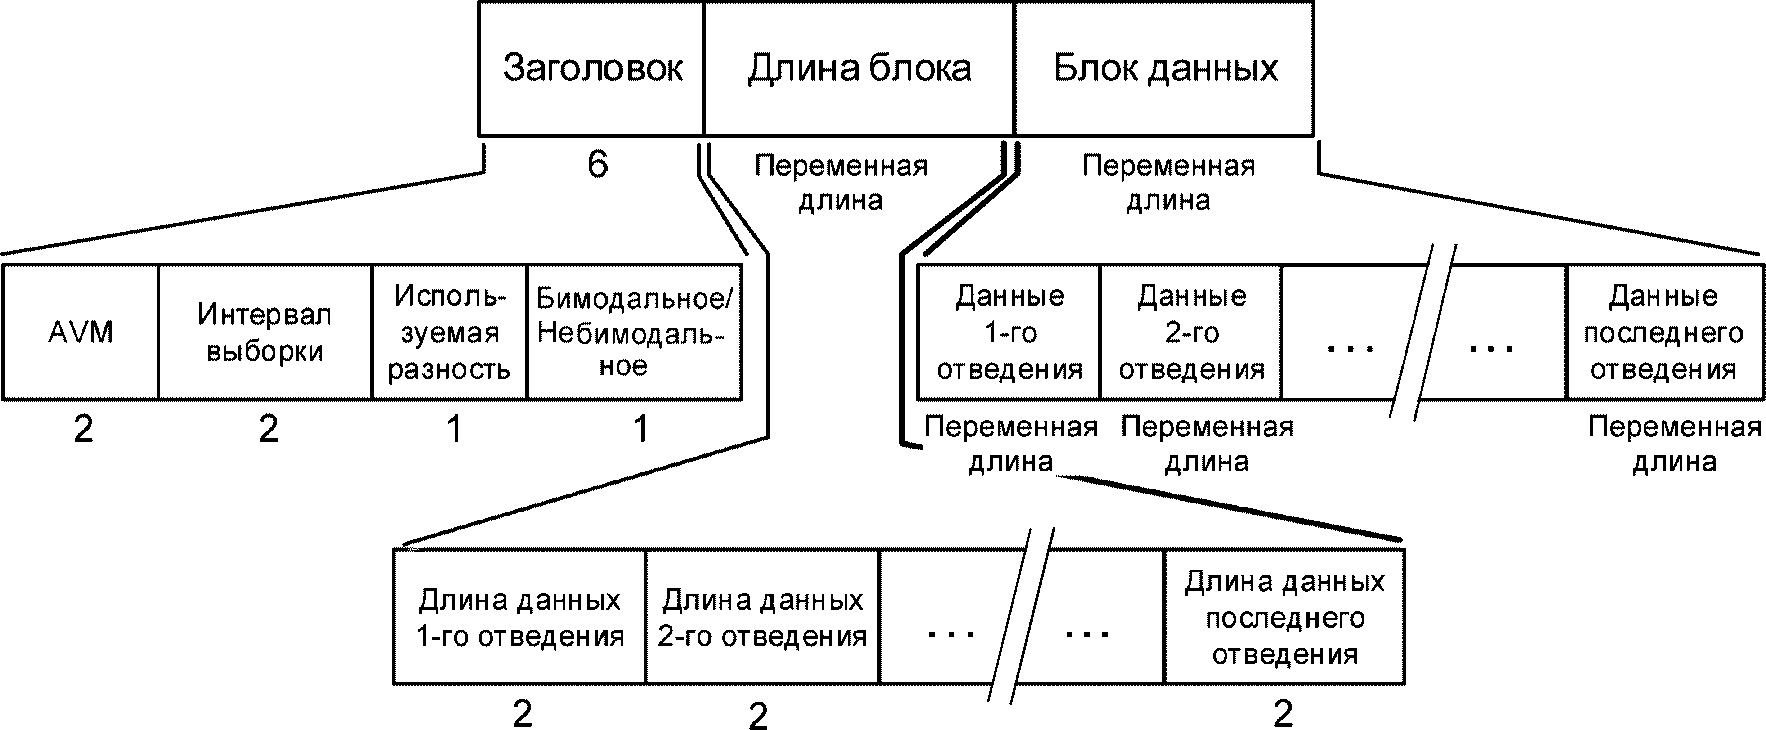
Рисунок 9 - Обзор структуры раздела данных ритма
5.10.1 Общие положения
Данный раздел содержит результаты глобальных измерений для каждого типа эталонного цикла либо для каждого QRS-комплекса в записи, а также список импульсов электрокардиостимулятора в записи. Если измерения предоставлены для каждого QRS-комплекса, то первый блок измерений должен содержать глобальные измерения цикла типа 0. Понятие "глобальный" относится к измерениям, снятым со всех отведений ЭКГ, но не обязательно представляющих более одного отдельного цикла. Обсуждение типов циклов см. в 5.1.11.
5.10.2 ID заголовка раздела
Если раздел присутствует, то должен начинаться с "ID заголовка раздела" в соответствии с 5.2.7.
5.10.3 Данные глобальных измерений электрокардиограммы и данные измерений импульсов электрокардиостимулятора
5.10.3.1 Общие положения
Данные раздела содержат данные глобальных измерений ЭКГ и данные измерений пиковых потенциалов электрокардиостимулятора, если таковые присутствуют. Специальные коды, определенные в проекте CSE, зарезервированы для обозначения следующего:
29999 (десятичное) | Измерение, не вычисляемое программой. |
29998 (десятичное) | Измерение не получено в связи с отказом измерительной программы в обработке отведения. |
19999 (десятичное) | Измерение не получено в связи с отсутствием зубца (например, P-зубца при предсердной фибрилляции). |
Эти коды должны заменять результаты измерений в соответствующих случаях.
Байты | Содержание |
1 | Этот байт содержит число типов эталонных циклов либо число QRS-комплексов + 1 (сравните с байтами 1, 2 в 5.10.3.5). Данный байт ссылается на число хранящихся блоков измерений, в которых первый блок (байты с 7 по 22) всегда содержит измерения для эталонного цикла типа 0. Если данный байт содержит число типов эталонных циклов (т.е. не равен значению, содержащемуся в байтах 1, 2, описанных в 5.10.3.5, увеличенному на 1), то каждый следующий блок содержит глобальные измерения для каждого следующего типа эталонного цикла. Если этот байт содержит число QRS-комплексов + 1, то следующие блоки содержат измерения для каждого следующего индивидуального цикла. |
2 | Число импульсов электрокардиостимулятора, для которых передаются времена их появления. |
3, 4 | Средний интервал RR в миллисекундах по всем QRS-комплексам. |
5, 6 | Средний интервал PP в миллисекундах по всем QRS-комплексам. |
С 7 по 22 | Измерения для эталонного цикла типа 0 (см. 5.10.4). |
С 23 по 38 | Измерения для эталонного цикла типа 1 или для первого QRS-комплекса (см. байт 1). |
и т.д. |
Байты | Содержание |
1, 2 | Время первого импульса в миллисекундах от начала записи ритма (целое без знака). |
3, 4 | Амплитуда первого импульса в микровольтах (1·10-6 В) (целое со знаком). |
5, 6 | Время второго импульса в миллисекундах от начала записи ритма (целое без знака). |
7, 8 | Амплитуда второго импульса в микровольтах (1·10-6 В) (целое со знаком). |
и т.д. |
Время и амплитуда этих импульсов электрокардиостимулятора представляются физической величиной со знаком в диапазонах от 0 до 65535 с и +/- 32767 мВ соответственно.
Разрешение времени для импульсов электрокардиостимулятора должно быть меньше или равно 2 мс.
5.10.3.4 Информация об импульсах электрокардиостимулятора
Для каждого импульса, идентифицированного в 5.10.3.2, байт 2, а также в 5.10.3.3, этот раздел должен содержать один блок из шести байтов, предоставляющий дополнительную информацию об импульсе. Порядок блоков соответствует порядку импульсов, идентифицированных в 5.10.3.3.
Байты | Содержание | |
1 | Тип импульса электрокардиостимулятора #1: | |
0 | Неизвестен. | |
1 | Импульс не вызывает ни P-зубец, ни QRS-комплекс. | |
2 | Импульс вызывает QRS-комплекс. | |
3 | Импульс вызывает P-зубец. | |
С 4 по 127 | Зарезервировано. | |
С 128 по 254 | Специфичны для производителя. | |
255 | Анализ типа импульса не производился. | |
2 | Источник импульса электрокардиостимулятора #1: | |
0 | Неизвестен. | |
1 | Внутренний. | |
2 | Внешний. | |
3 по 255 | Зарезервировано. | |
3, 4 | Индекс QRS-комплекса, вызванного импульсом электрокардиостимулятора #1: | |
0 | Без ссылки. | |
1 | Ссылка на QRS #1 первого QRS-комплекса. | |
2 | Ссылка на QRS #2 второго QRS-комплекса и т.д. | |
5, 6 | Ширина импульса в микросекундах - 0 означает "неизвестна" или "не вычислена" (целое без знака). | |
Данный раздел идентифицирует тип эталонного цикла для каждого комплекса QRS в ЭКГ. Комплексы рассматриваются по порядку. Типы эталонного цикла нумеруются в соответствии с их появлением в разделе данных глобальных измерений ЭКГ (5.10.3.2).
Байты | Содержание |
1, 2 | Число комплексов QRS. |
3 | Тип эталонного цикла первого комплекса QRS (0 - ??). |
4 | Тип эталонного цикла второго комплекса QRS (0 - ??). |
и т.д. |
5.10.3.6 Дополнительные глобальные измерения
Данный раздел предусмотрен для дополнительных измерений сверх тех, что определены в 5.10.3.2. Он размещен здесь, чтобы реализации предыдущих версий протокола оставались работающими.
Байты | Содержание | |
1, 2 | Желудочковый ритм, ударов в минуту (целое без знака). | |
3, 4 | Предсердный ритм, ударов в минуту (целое без знака). | |
5, 6 | Скорректированный сегмент QT (в миллисекундах) (целое без знака). | |
7 | Тип формулы, используемой для коррекции сердечного ритма: | |
0 | Неизвестен или не указан. | |
1 | Bazett. | |
2 | Hodges. | |
С 3 по 127 | Зарезервированы. | |
С 128 по 254 | Специфичны для производителя. | |
255 | Измерение недоступно. | |
8, 9 | Число байтов в последующих отмеченных полях (ноль в случае отсутствия таких полей). | |
С 10 по *** | Тегированные поля, описанные в таблице 10. Допустимы теги от 0 до 254, тег 255 является завершающим. Каждое поле имеет как минимум идентификатор тега (1 байт) и спецификацию длины (1 байт). Длина поля с тегом 255 равна 0. | |
Таблица 10
Тег | Длина | Значение (данные параметров) | |
0 | 5 | Дисперсия интервалов QTe для всех отведений (двоичное) Интервалы QT, измеренные от начала QRS до окончания зубца T, в миллисекундах. В измерении используются все отведения ЭКГ. Допустимые значения от 0 до 254 (миллисекунды); 255 - измерение не проводилось. | |
Байт | Содержание | ||
1 | Дисперсия = максимальный интервал QTe - минимальный интервал QTe. | ||
2 | Корригированная дисперсия сердечного ритма: макс. - мин. | ||
3 | Дисперсия = стандартное отклонение интервалов QTe. | ||
4 | Корригированная дисперсия сердечного ритма: стандартное отклонение. | ||
5 | Формула коррекции сердечного ритма (допустимые значения см. в определении байта 7) | ||
1 | 5 | Дисперсия интервалов QTa для всех отведений (двоичное) Интервалы QT, измеренные от начала QRS до вершины зубца T, в миллисекундах. В измерении используются все отведения ЭКГ. Допустимые значения от 0 до 254 (миллисекунды); 255 - измерение не предоставлено. | |
Байт | Содержание | ||
1 | Дисперсия = максимальный интервал QTa - минимальный интервал QTa. | ||
2 | Корригированная дисперсия сердечного ритма: макс. - мин. | ||
3 | Дисперсия = стандартное отклонение интервалов QTa. | ||
4 | Корригированная дисперсия сердечного ритма: стандартное отклонение. | ||
5 | Формула коррекции сердечного ритма (допустимые значения см. в определении байта 7) | ||
2 | 5 | Прекордиальная дисперсия интервалов QTe (двоичное) Интервалы QT, измеренные от начала QRS до окончания зубца T, в миллисекундах. В измерении используются только прекордиальные отведения ЭКГ. Допустимые значения от 0 до 254 (миллисекунды); 255 - измерение не проводилось. | |
Байт | Содержание | ||
1 | Дисперсия = максимальный интервал QTe - минимальный интервал QTe. | ||
2 | Корригированная дисперсия сердечного ритма: макс. - мин. | ||
3 | Дисперсия = стандартное отклонение интервалов QTe. | ||
4 | Корригированная дисперсия сердечного ритма: стандартное отклонение. | ||
5 | Формула коррекции сердечного ритма (допустимые значения см. в определении байта 7) | ||
3 | 5 | Прекордиальная дисперсия интервалов QTa (двоичное) Интервалы QT, измеренные от начала QRS до вершины зубца T, в миллисекундах. В измерении используются только прекордиальные отведения ЭКГ. Допустимые значения от 0 до 254 (миллисекунды); 255 - измерение не предоставлено. | |
Байт | Содержание | ||
1 | Дисперсия = максимальный интервал QTa - минимальный интервал QTa. | ||
2 | Корригированная дисперсия сердечного ритма: макс. - мин. | ||
3 | Дисперсия = стандартное отклонение интервалов QTa. | ||
4 | Корригированная дисперсия сердечного ритма: стандартное отклонение. | ||
5 | Формула коррекции сердечного ритма (допустимые значения см. в определении байта 7) | ||
С 4 по 254 | (отсутствует) | Зарезервированы | |
255 | 0 | Отсутствует (окончание раздела) | |
5.10.4 Формат блока измерений для каждого типа эталонного цикла или для каждого отдельного комплекса QRS
Байты | Содержание |
1, 2 | Начало P. |
3, 4 | Завершение P. |
5, 6 | Начало QRS. |
7, 8 | Завершение QRS. |
9, 10 | Завершение T. |
11, 12 | Ось P во фронтальной плоскости (в угловых градусах, если не определена, то 999). |
13, 14 | Ось QRS во фронтальной плоскости (в угловых градусах, если не определена, то 999). |
15, 16 | Ось T во фронтальной плоскости (в угловых градусах, если не определена, то 999). |
Примечания
1 Если блок измерений содержит данные эталонного цикла некоторого типа, то времена начала и окончания задаются в миллисекундах от начала эталонного цикла. Если блок измерений содержит данные конкретного цикла, то времена начала и окончания задаются в миллисекундах от начала записи ЭКГ. Длительности зубцов и интервалов могут быть вычислены вычитанием времени начала зубца или интервала из времени окончания.
2 Для осей (P, QRS, T) на фронтальной плоскости используется соглашение, показанное на рисунке 10.
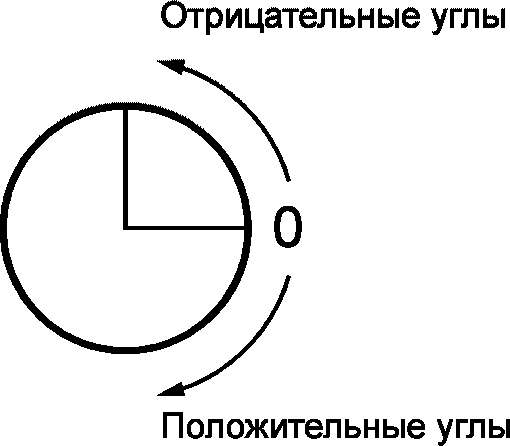
Рисунок 10 - Определение угла
5.10.5 Блок глобальных измерений, специфичный для производителя
Блок переменной длины, содержащий глобальные измерения, специфичные для производителя, может быть добавлен в данный раздел после информации об импульсах электрокардиостимулятора.
Начало блока, специфичного для производителя (считая от начала ID заголовка раздела), должно определяться по информации, приведенной в данных глобальных измерений ЭКГ. Например, если блоки измерений содержат глобальные измерения для каждого типа эталонного цикла, то начало блока, специфичного для производителя, будет равно 16 (см. 5.2.7) + 6 + (число типов эталонного цикла, умноженное на 16) + (число импульсов электрокардиостимулятора, умноженное на 4) + (число импульсов электрокардиостимулятора, умноженное на 6) + (2 + число QRS-комплексов) + (9 + число байтов в тегированных глобальных измерениях) + 1. Конец блока должен предоставляться в ID заголовка раздела с помощью общей длины раздела, включая ID заголовка раздела (см. 5.2.7).
5.10.6 Структура данных глобальных измерений
Структура данных раздела 7, содержащего глобальные измерения, представлена на рисунке 11.
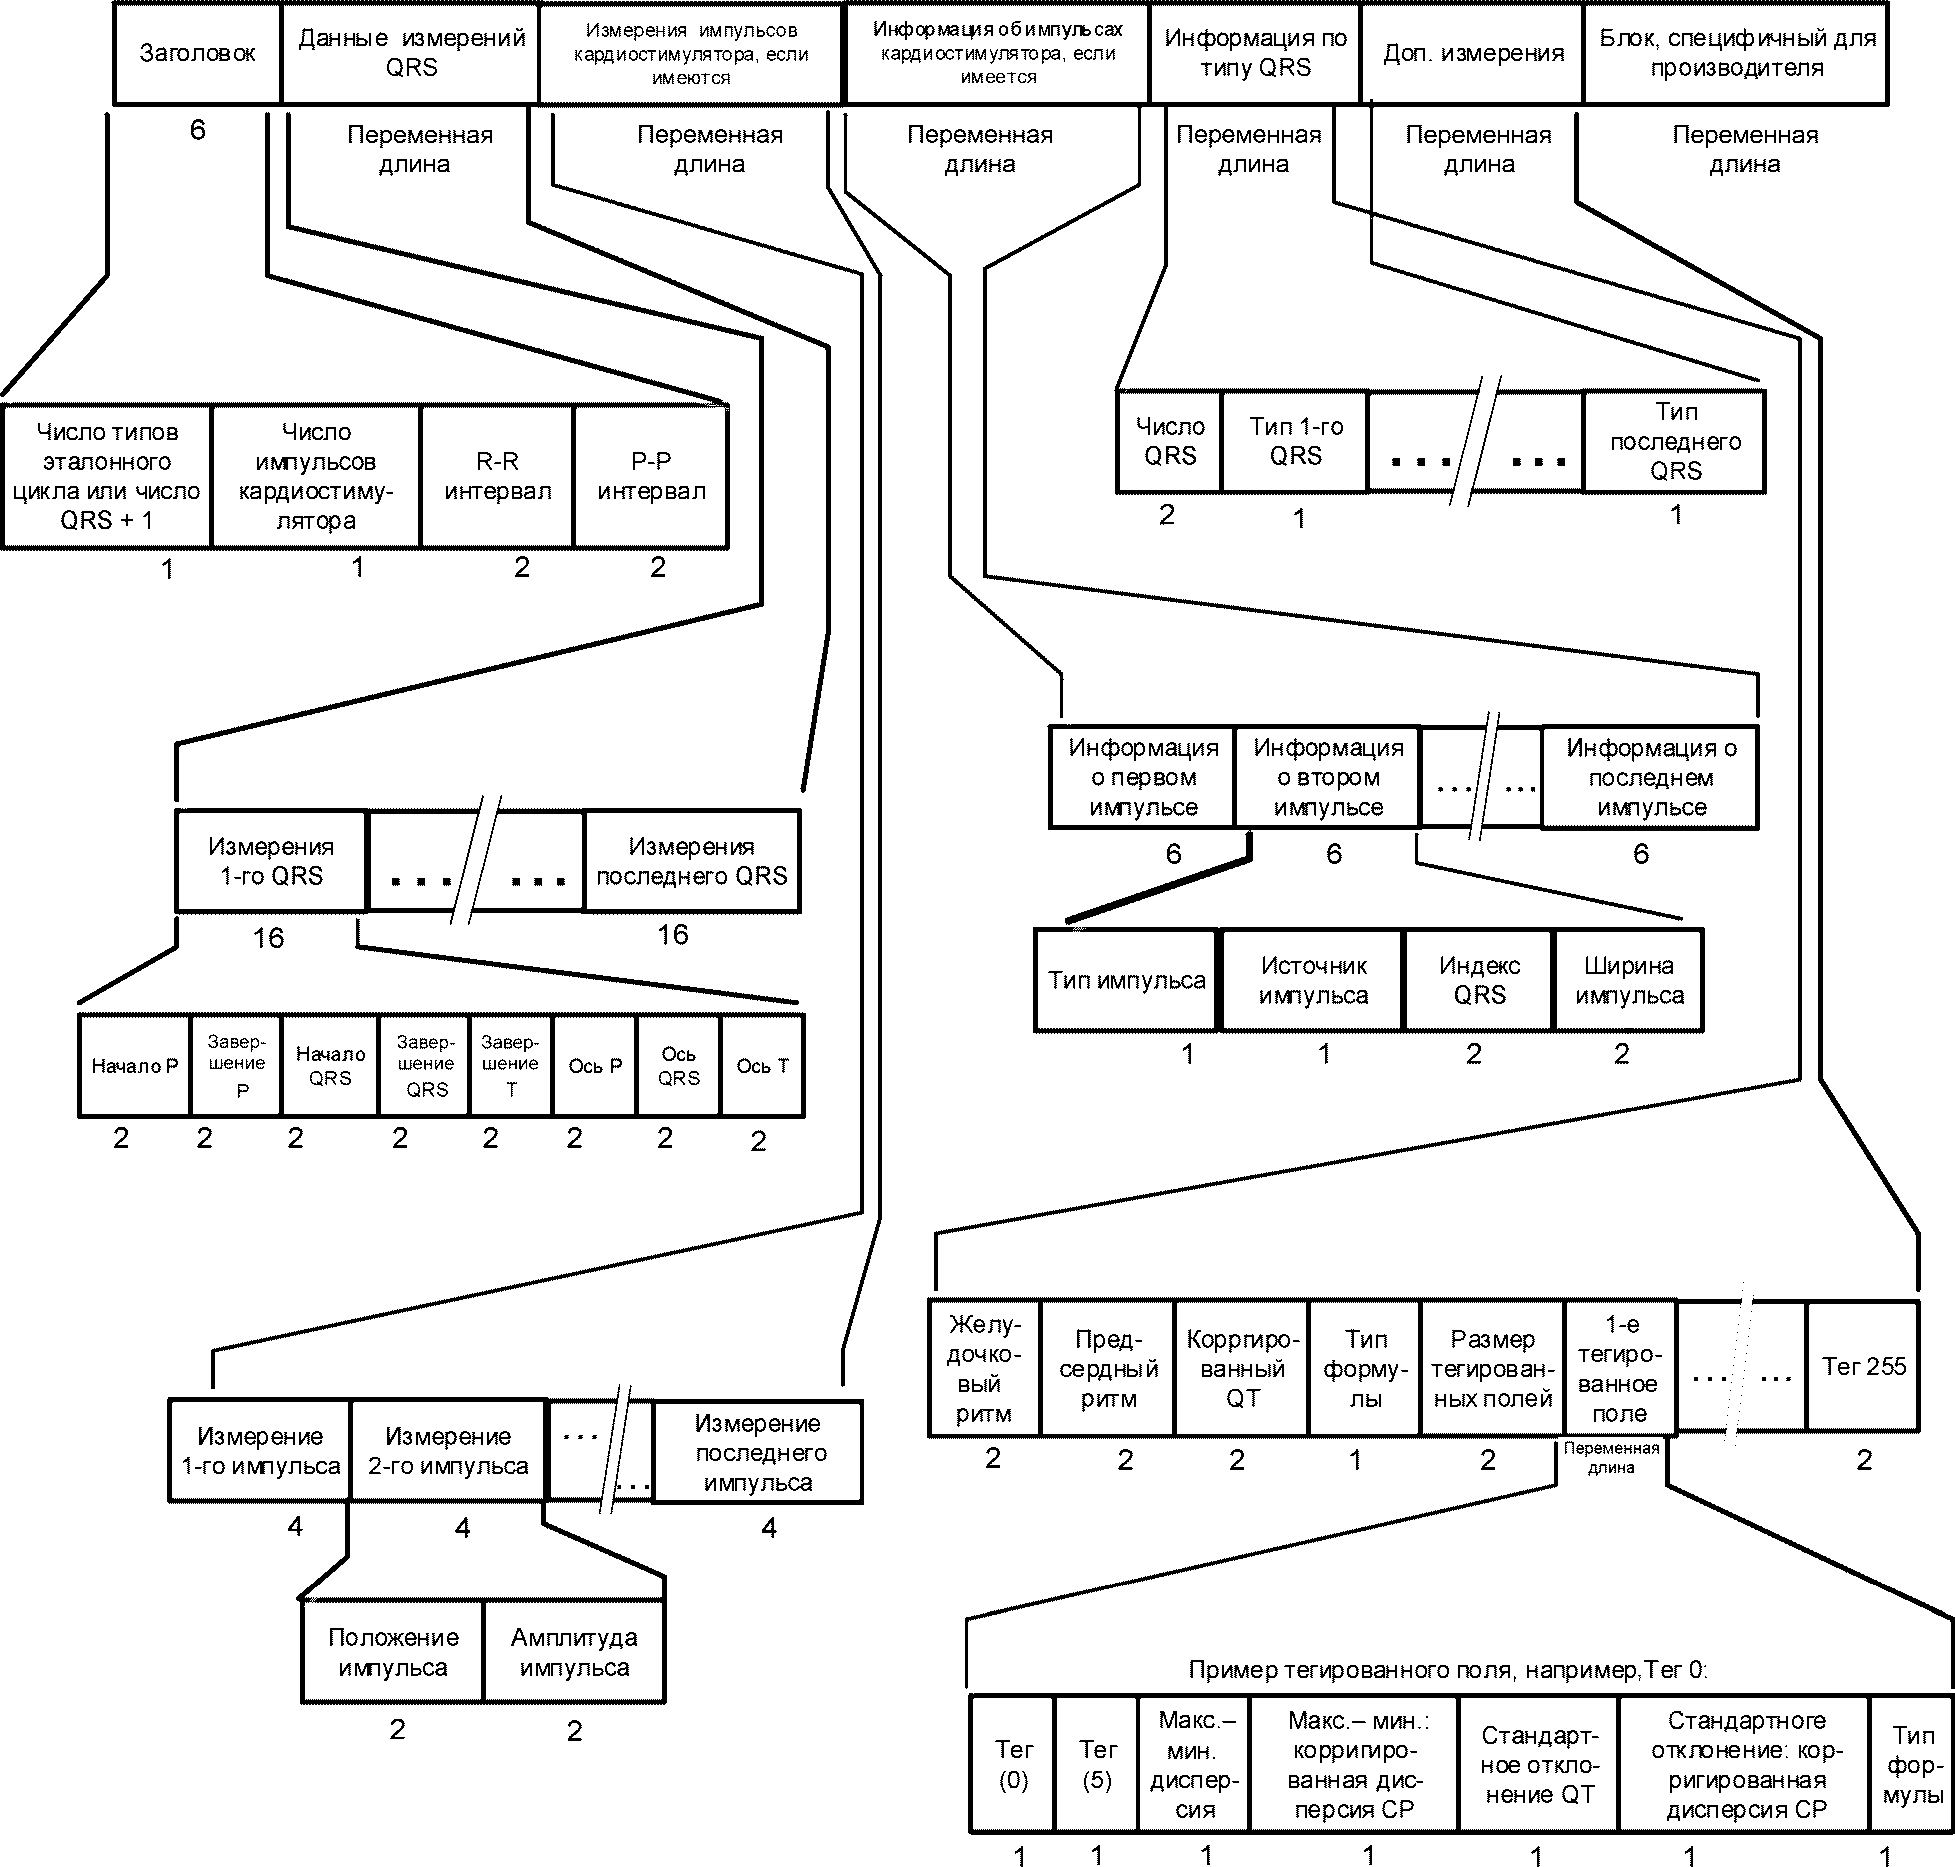
5.11.1 Данный раздел содержит текстовую версию самой поздней диагностической интерпретации ЭКГ.
5.11.2 Если раздел присутствует, то должен начинаться с "ID заголовка раздела" в соответствии с 5.2.7.
5.11.3 Данные этого раздела включают заголовок, за которым следует несколько утверждений.
5.11.4 Заголовок имеет следующую структуру:
Байты | Содержание | |
1 | Двоичное. Подтвержденный/неподтвержденный отчет: | |
Значение | Тип | |
0 | Исходные данные (без расшифровки). | |
1 | Подтвержденный отчет. | |
2 | Расшифровка не подтверждена. | |
2, 3 | Двоичное. Год (полная целочисленная нотация, например, 1990). | |
4 | Двоичное. Месяц (диапазон с 01 по 12; 01 = Январь). | |
5 | Двоичное. День (диапазон с 01 по 31). | |
6 | Двоичное. Часы (диапазон от 00 до 23). | |
7 | Двоичное. Минуты (диапазон от 00 до 59). | |
8 | Двоичное. Секунды (диапазон от 00 до 59). | |
9 | Двоичное. Число утверждений в данном разделе. | |
5.11.5 Данные утверждений
Байты | Содержание |
1 | Двоичное. Порядковый номер утверждения, начиная с 01. |
2, 3 | Двоичное. Длина поля утверждения (число байтов в утверждении, начиная с первого байта и включая завершающий байт NULL). |
С 4 по *** | Тело утверждения: текст, завершающийся байтом NULL. |
5.11.6 В утверждениях не допускаются никакие коды, если они не сопровождаются текстовым описанием.
5.11.7 Структура раздела представлена на рисунке 12.
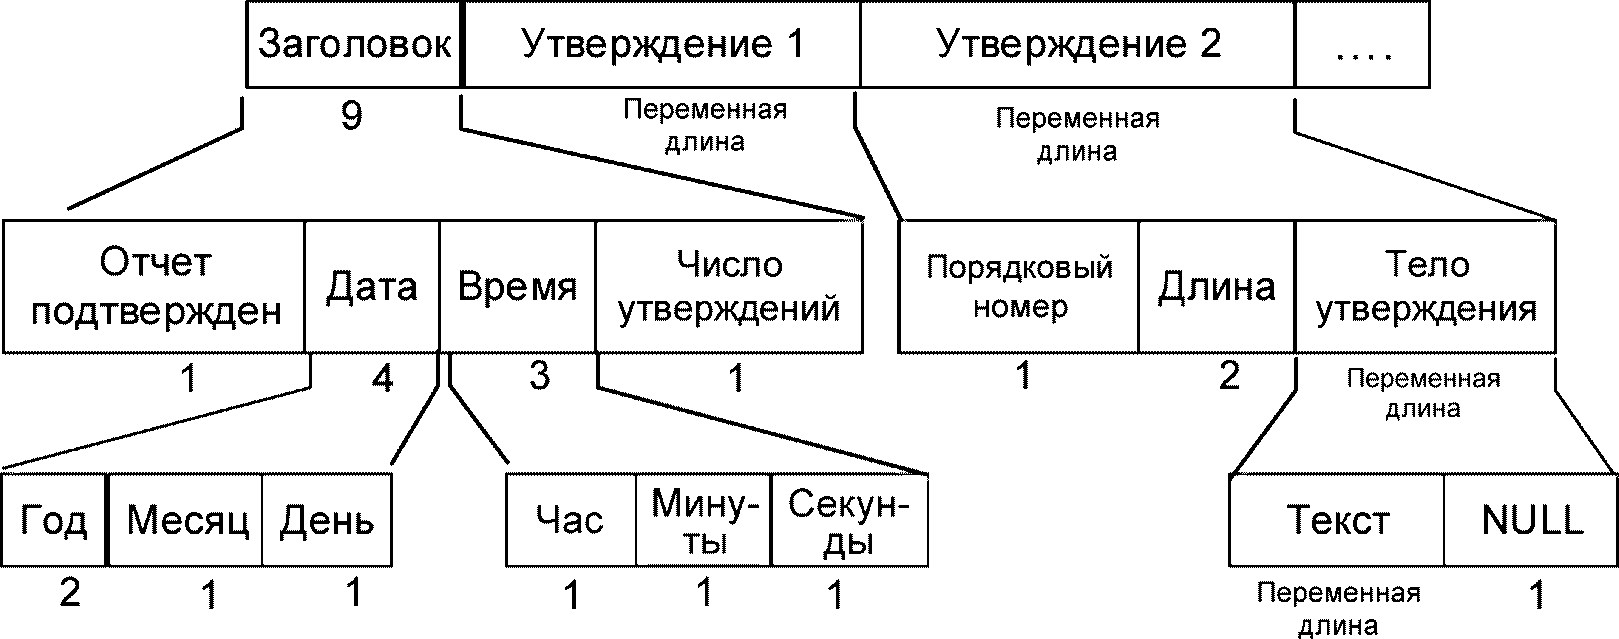
Рисунок 12 - Структура раздела 8
5.12 Хранение интерпретирующих утверждений, специфичных для производителя, и данных, относящихся к цепочке расшифровок. Раздел 9
5.12.1 Данный раздел зарезервирован для диагностических описаний, специфичных для производителя анализирующего устройства, и интерпретируемых цепочек расшифровок. Источник анализирующего устройства, фамилия и имя проводящего расшифровку врача (или наименование устройства) определены в "Разделе заголовка" (раздел 1).
5.12.2 Если раздел присутствует, то он должен начинаться с "ID заголовка раздела" в соответствии с 5.2.7.
5.12.3 Структура и формат данных этого раздела специфичны для производителя.
5.13.1 Данный раздел содержит отдельные измерения каждого записанного отведения. Обязательные измерения и их формат приведены ниже. В нем предусмотрены область, специфичная для производителя, а также управляющие коды особых условий.
5.13.2 Если раздел присутствует, то он должен начинаться с "ID заголовка раздела" в соответствии с 5.2.7.
5.13.3 Данные раздела измерения отведений должны состоять из одной записи для каждого измеряемого отведения. Каждая запись должна состоять из четырех полей:
a) идентификатор отведения (двоичный, два байта). Схему нумерации отведения см. в 5.6.4, байт 9;
b) длина записи в байтах (целое без знака), исключая байты с 1 по 4 (двоичное; 2 байта);
c) до 50 базовых измерений (целые со знаком) (двоичные поля; 2 байта каждое);
d) область измерений, специфичная для производителя, начиная с байта 105 и до конца (двоичные). Организация или формат этой области настоящим документом не регламентируются.
5.13.4 Специальные коды, определенные в проекте CSE, зарезервированы для обозначения следующего:
29999 (десятичное) | Измерение, не вычисляемое программой. |
29998 (десятичное) | Измерение не получено в связи с отказом измерительной программы в обработке отведения. |
19999 (десятичное) | Измерение не получено в связи с отсутствием зубца (например, P-зубца при предсердной фибрилляции). |
Заголовок данных этого раздела содержит число отведений, для которых передается блок измерений (двоичное, 2 байта). За ним следуют два байта информации, специфичной для производителя.
5.13.5 Каждый блок измерений отведения должен иметь следующий состав:
Байты | Содержание |
1, 2 | Идентификатор отведения. |
3, 4 | Длина записи. |
5, 6 | Длительность P, мс (общая длительность, включая компоненты P+ и P-). |
7, 8 | Интервал PR, мс. |
9, 10 | Длительность QRS-комплекса, мс. |
11, 12 | Интервал QT, мс. |
13, 14 | Длительность Q, мс. |
15, 16 | Длительность R, мс. |
17, 18 | Длительность S, мс. |
19, 20 | Длительность R', мс. |
21, 22 | Длительность S', мс. |
23, 24 | Амплитуда Q, мкВ. |
25, 26 | Амплитуда R, мкВ. |
27, 28 | Амплитуда S, мкВ. |
29, 30 | Амплитуда R', мкВ. |
31, 32 | Амплитуда S', мкВ. |
33, 34 | Амплитуда точки J, мкВ (амплитуда точки J = амплитуда окончания QRS). |
35, 36 | Амплитуда P(+), мкВ. |
37, 38 | Амплитуда P(-), мкВ. |
39, 40 | Амплитуда T(+), мкВ. |
41, 42 | Амплитуда T(-), мкВ. |
43, 44 | Наклон ST сегмента, мкВ/с. |
45, 46 | Описание морфологии зубца P, в соответствии с приведенным ниже определением. |
47, 48 | Описание морфологии зубца T, в соответствии с приведенным ниже определением. |
49, 50 | Изоэлектрический сегмент перед началом QRS, в мс (сегмент I). |
51, 52 | Изоэлектрический сегмент после окончания QRS, в мс (сегмент K). |
Примечание - Определение изоэлектрических сегментов I и K см. в European Heart Journal 1985, том 6, стр. 815 - 825. Кратко говоря, "I" является интервалом между глобальным началом QRS, полученным из всех одновременно записанных отведений, и началом QRS в конкретном отведении. Аналогично, "K" является временем между окончанием QRS в определенном отведении и глобальным окончанием QRS.
53, 54 | Внутреннее отклонение электрокардиограммы, в мс. |
55, 56 | Код качества, отражающий условия записи ЭКГ, в соответствии с приведенным ниже определением. |
57, 58 | Амплитуда ST в точке J плюс 20 мс. |
59, 60 | Амплитуда ST в точке J плюс 60 мс. |
61, 62 | Амплитуда ST в точке J плюс 80 мс. |
63, 64 | Амплитуда ST в точке J плюс 1/16 среднего интервала R - R. |
65, 66 | Амплитуда ST в точке J плюс 1/8 среднего интервала R - R. |
67, 104 | Зарезервированы для будущего использования. |
С 105 по *** | Блок результатов измерений, специфичных для производителя. |
Все измерения должны быть выражены целочисленными значениями со знаком. Амплитуды зубцов Q, S, S', T(-) и P(-) должны быть выражены отрицательными целочисленными значениями. То же относится к амплитуде точек J, J + 20, J + 60 и J + 80, когда они отрицательные. Обратите внимание, что точка J (J) совпадает с окончанием комплекса QRS.
Байты с 67 по 104 должны иметь значение 0 и передаваться, если раздел содержит блок, специфичный для производителя.
5.13.5.1 Коды описания морфологии P и T (байты с 45 по 48) определены следующим образом:
Значение | Содержание |
0 | Неизвестно. |
1 | Положительный  . |
2 | Отрицательный  . |
3 | Положительный/отрицательный  . |
4 | Отрицательный/положительный  . |
5 | Положительный/отрицательный/положительный  . |
6 | Отрицательное/положительное/отрицательное  . |
7 | Зазубренный в форме M  . |
8 | Зазубренный в форме W  . |
5.13.5.2 Код качества (байты 55, 56) определен следующим образом:
Два двоичных байта на отведение, состоящие из 8 двухбитовых полей. Каждое поле характеризует уровень шума одного из четырех классов.
Младший значащий бит байта 55 определен как бит 0. Старший значащий бит байта 56 определен как бит 15.
Биты | Содержание | Уровень | Класс |
0, 1 | Шум сети переменного тока (основной). | 0 | Отсутствует/нет. |
2, 3 | Выход за пределы. | 1 | Умеренный/да. |
4, 5 | Дрейф. | 2 | Существенный. |
6, 7 | Дрожание или мышечный артефакт. | 3 | Неизвестно. |
8, 9 | Всплески или внезапные скачки. | ||
10, 11 | Электрод отсутствует или отключен. | ||
12, 13 | Электрокардиостимулятор. | ||
14, 15 | Переставленное отведение. |
5.13.5.3 Структура данных этого раздела представлена на рисунке 13.
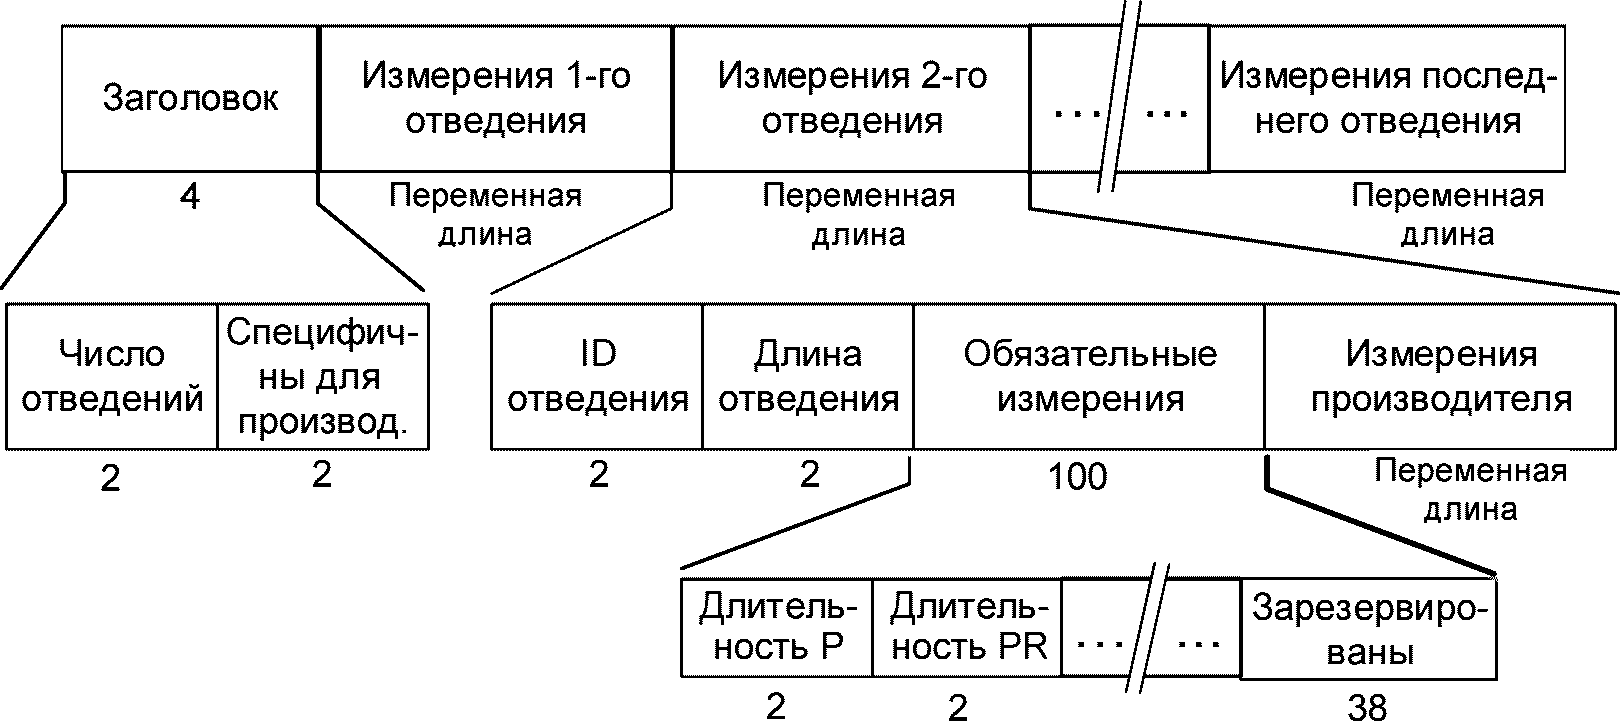
Рисунок 13 - Структура данных раздела блока
измерений отведений
5.14.1 Настоящий раздел содержит данные самой последней интерпретации и расшифровки, закодированные в соответствии с Универсальными кодами утверждений и правилами кодирования, определенными в приложении F. Данные, содержащиеся в этом разделе, должны быть согласованы с данными, передаваемыми в разделах 8 и 9.
5.14.2 Если этот раздел присутствует, то он должен начинаться с "ID заголовка раздела" в соответствии с 5.2.7.
5.14.3 Определение структуры и формата
Данные должны храниться по принципу "утверждение за утверждением". Существует три возможных типа утверждений:
1) универсальные коды интерпретации (в соответствии с приложением F);
2) полный текст (как используется в разделе 8);
3) логика утверждений (идентифицирующая логические связи между утверждениями).
Для хранения трех типов утверждений определены три отдельных поля утверждений.
Только одному полю типа "Логика утверждений" разрешается идентифицировать логические связи между утверждениями других типов. Если раздел не содержит поле типа "Логика утверждений", то предполагается, что все утверждения равным образом действительны и не имеют "специальных" связей друг с другом помимо того, что объявлено в утверждении. Число полей типов "Универсальные коды интерпретации" и "Полный текст" не ограничивается.
5.14.4 Организация данных этого раздела представлена в 5.14.5, а ее объяснение дано ниже.
5.14.4.1 Заголовок
Байты | Содержание | |
1 | Двоичное. Подтвержденный/неподтвержденный отчет: | |
Значение | Тип | |
0 | Исходные данные (без расшифровки). | |
1 | Подтвержденный отчет. | |
2 | Расшифровка не подтверждена. | |
2, 3 | Двоичное. Год (полная целочисленная нотация, например, 1990). | |
4 | Двоичное. Месяц (диапазон с 01 по 12; 01 = Январь). | |
5 | Двоичное. День (диапазон с 01 по 31). | |
6 | Двоичное. Часы (диапазон от 00 до 23). | |
7 | Двоичное. Минуты (диапазон от 00 до 59). | |
8 | Двоичное. Секунды (диапазон от 00 до 59). | |
9 | Двоичное. Число утверждений в данном разделе. | |
5.14.4.2 Данные утверждения
Байты | Содержание | ||
1 | Двоичное. Порядковый номер утверждения, начиная с 1. Каждому утверждению присвоен порядковый номер, чтобы их можно было легко связать с помощью логических операторов типа 3. | ||
2, 3 | Двоичное. Длина поля утверждения (число байтов в утверждении, начиная с первого байта и включая завершающий байт NULL). | ||
С 4 по *** | Поле утверждения: | ||
Байт | Содержание | ||
1 | Двоичное. Тип поля утверждения: | ||
Значение | Тип | ||
1 | Тип кодированного утверждения, взятый из Универсальных кодов интерпретации. | ||
2 | Тип полного текста, как используется в разделе 8. | ||
3 | Тип логики утверждения в соответствии с приведенным ниже описанием. | ||
Со 2 по *** | Данные, зависящие от типа поля. Завершаются значением NULL (0). | ||
5.14.4.3 Тип утверждения
Тип 1 | Данный тип должен содержать одно кодированное утверждение, за которым необязательно следует один или несколько модификаторов в соответствии с Универсальными кодами интерпретации. Каждый элемент (кодированное утверждение или модификатор) должен занимать один блок данных, завершающийся значением NULL (0). Блоки данных имеют переменную длину, и число блоков не ограничено. Единственным ограничением является суммарная длина всех блоков, которая не должна превышать 65 535 байтов. |
Тип 2 | Данный тип имеет единственный блок данных, содержащий только текстовые символы, и завершается значением NULL (0). |
Тип 3 | Данный тип имеет единственный блок данных, содержащий только текстовые символы, и завершается значением NULL (0). Содержание данного поля идентифицируют логические связи между утверждениями с помощью логических операторов, применяемых к утверждениям, идентифицируемым своими порядковыми номерами. |
Пример - выражение "(1 + 2); 3", где "+" = "ИЛИ", ";" = "И", а скобки "(...)" указывают приоритет, читается как "(утверждение N 1 ИЛИ утверждение N 2) И утверждение N 3.
См. рисунок 14.
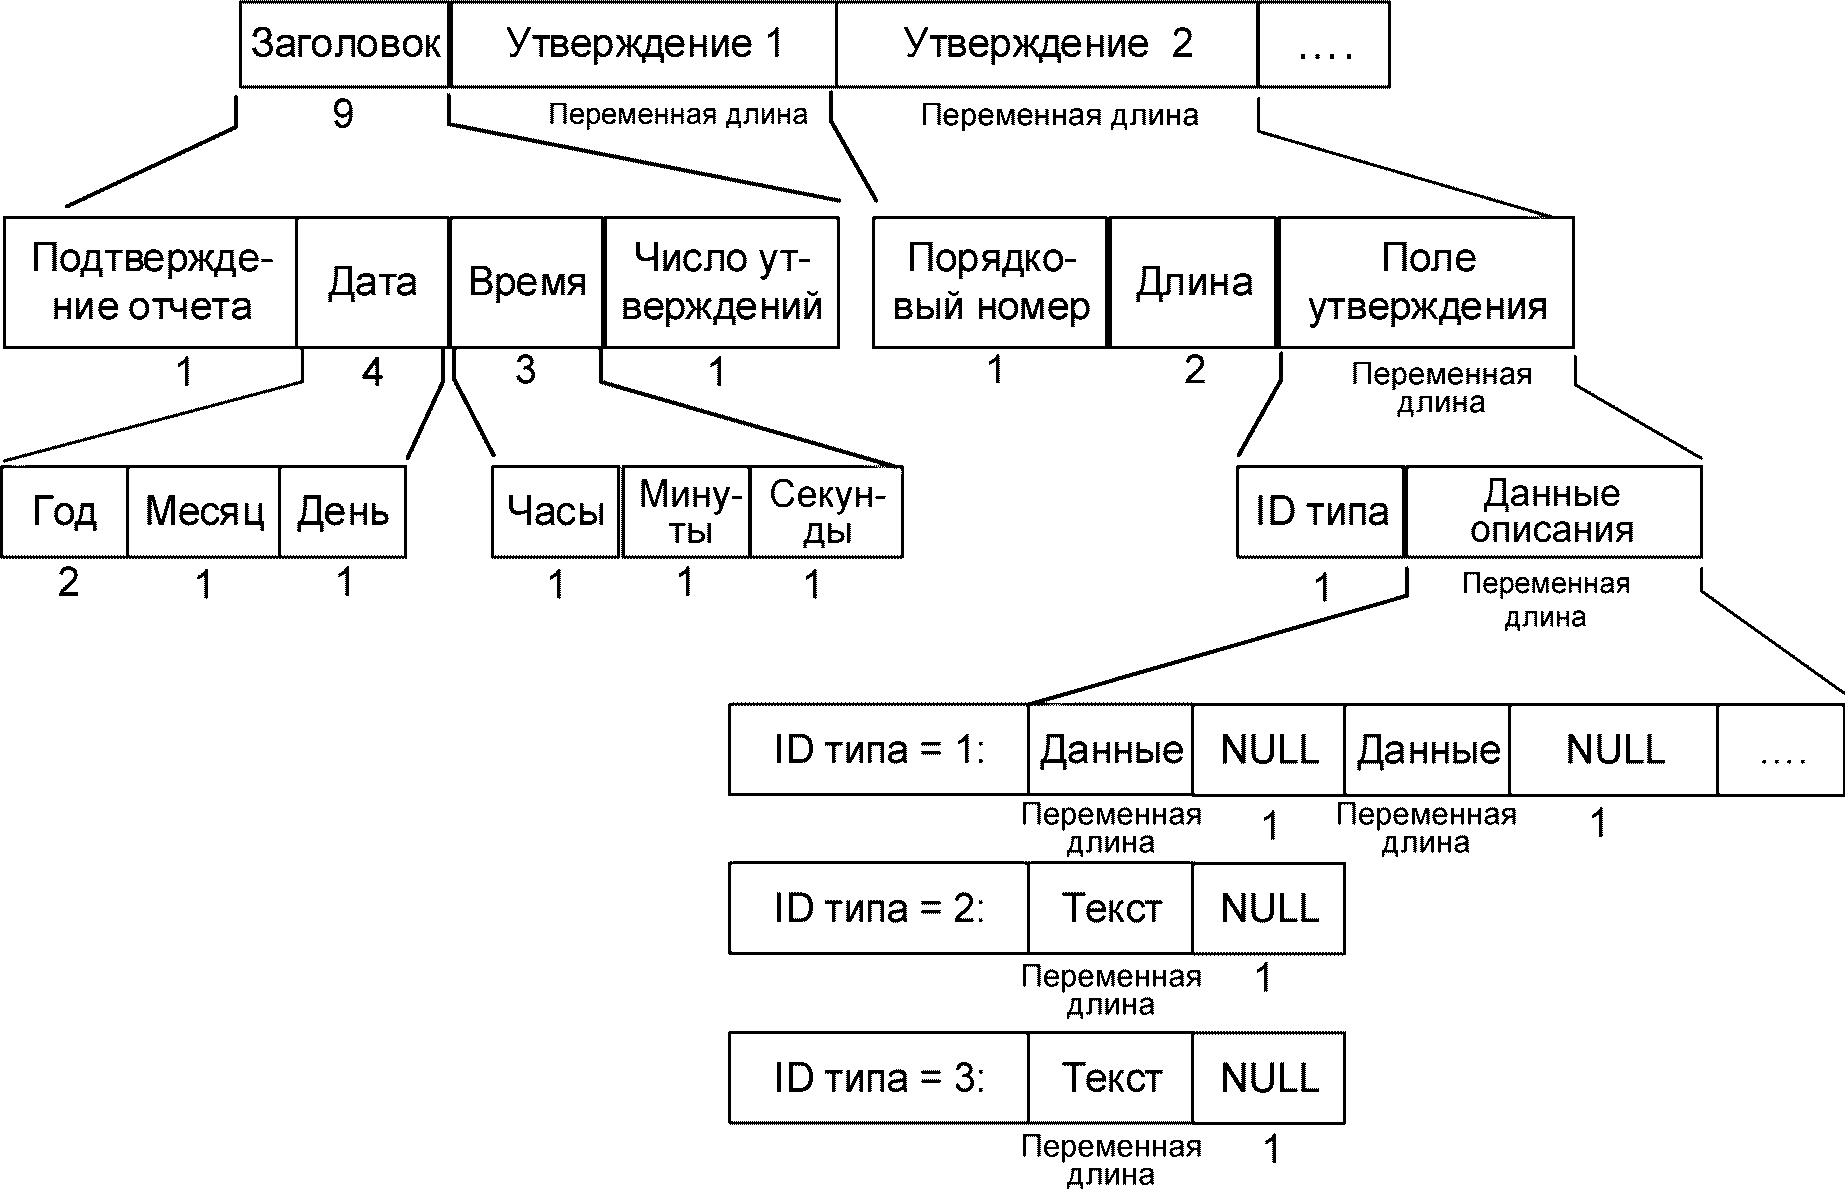
Рисунок 14 - Структура данных раздела 11
Как описано в разделе 1, ЭКГ применяется в повседневной клинической практике, когда пациент находится в спокойном состоянии, получает дозированные физические нагрузки, ведет обычную повседневную деятельность в течение длительного времени, например при амбулаторном мониторинге (так называемым холтеровским мониторингом), или находится в палате интенсивной терапии для контроля нарушения сердечного ритма. Рекомендации по сжатию данных записей ЭКГ на протяжении длительных периодов времени были исключены из настоящего стандарта. Спецификации кодирования и сжатия, описанные в настоящем стандарте, ограничиваются обычным снятием электрокардиограммы пациента в состоянии покоя.
Записи ЭКГ в состоянии покоя, как правило, имеют длину 10 сек. При оцифровке этих данных с точностью, рекомендованной Международными комитетом по электрокардиографии организация AHA, AAMI, CSE и другими, а именно 500 считываний/с и максимум 5 мкВ/LSB для каждого отведения ЭКГ, в секунду формируется 1000 байтов данных, в которых на каждое считывание отводится 16 битов. Таким образом, данные стандартной 10-секундной ЭКГ в 12 отведениях занимают 80 000 байтов (в этом случае избыточность отведений от конечностей, которые можно реконструировать из отведений I и II, уже была устранена).
Хотя эти объемы данных существенно меньше тех, что возникают при медицинской визуализации, электрокардиография дает большое количество цифровых данных по сравнению с другими медицинскими данными, например, с историей болезни пациента, кодами диагнозов и биомедицинскими лабораторными данными. Хотя современные технологии значительно повысили доступный объем хранения данных и скорость их передачи, снижение объема данных по-прежнему остается желательным (и даже экономически необходимым), в особенности при передаче этих данных по обычной телефонной сети.
В действительности существует два веских основания сжатия цифровых данных ЭКГ:
1) снизить требования к (магнитному) хранилищу медицинских баз данных и больничных информационных систем;
2) сократить время (и затраты на телефонную связь) передачи данных ЭКГ.
Хотя семантика диагностической информации ЭКГ теоретически может храниться в нескольких байтах, постоянно необходимы повторные анализы сделанных записей и сравнение новых записей с предыдущими, в особенности для кардиологических пациентов. Небольшие изменения морфологии ЭКГ могут служить чувствительными индикаторами протекания заболевания. Их можно распознать с помощью сравнения последовательного ряда записей ЭКГ, но если вместо записей хранятся только текстовые результаты анализа основных особенностей ЭКГ, эта возможность может быть потеряна.
За последние десятилетия были разработаны разные алгоритмы сжатия ЭКГ. Сжатие ЭКГ, за исключением специфичных ситуаций, когда применялось только сокращение избыточности, всегда сопровождалось некоторым ухудшением исходной записи. Так как стандарты точности, форматов данных или методов сжатия отсутствуют, то сжатые данные ЭКГ могут подвергаться повторному анализу и сравнению только в рамках систем обработки одного производителя. Также невозможен обмен сжатыми данными между системами разных производителей. Кроме того, отсутствует количественная информация о ухудшении данных, вызванных процедурами сжатия и реконструкции сжатых данных.
Главной целью и достижением, достигнутым в ходе осуществления направления Workpackage 2 в рамках Проекта SCP-ECG предварительных программ AIM (1989 - 1990) Европейского сообщества, было определение и согласование пределов точности и спецификаций сжатия данных ЭКГ, а также определение такого кодирования данных, при котором сжатые ЭКГ можно было бы передавать и повторно анализировать в системах разных производителей. Рекомендации, полученные в результате реализации этого направления, сформировали основу настоящего стандарта.
Можно идентифицировать следующие принципы, применяемые к сжатию данных ЭКГ:
1) сокращение избыточности в рамках цифровой записи (обратимое сжатие данных);
2) ограничение полосы пропускания и снижение частоты считываний;
3) сокращение информации с помощью необратимого сжатия данных, при котором могут задаваться, а могут и не задаваться пределы точности.
В ходе проекта SCP-ECG был подготовлен обзор различных алгоритмов, разработанных за последние 20 лет, для сжатия ЭКГ, снятых у пациента в состоянии покоя, а также холтеровских ЭКГ. Важный вклад в сжатие данных ЭКГ можно найти в работах, приведенных в библиографии.
Ниже приведены основные заключения, сделанные в этом обзоре:
1) сокращение избыточности является единственным методом избежать ухудшения сигнала. Сокращение избыточности приводит к коэффициентам сжатия в диапазоне от 2 до 5;
2) другие схемы сжатия позволяют получить коэффициент сжатия от 5 до 12;
3) меры искажения реконструкции сигнала, как правило, приводятся в единицах среднеквадратичной амплитуды RMS (root mean square). Однако показатели RMS являются усредненными и даже при малых величинах RMS может возникнуть непредвиденно большое число абсолютных искажений важных частей сигнала;
4) проверка схем сжатия всегда должна включать в себя анализ ошибок в абсолютной амплитуде, так как они могут превышать показатели RMS в 10 - 20 раз;
5) применялись также различные преобразования сигнала (дискретное преобразование Фурье, преобразование Карунена-Лоэва (Karhunen-Loeve), преобразование Уолша). Полученный диапазон коэффициентов сжатия составил от 6 до 12. Однако для этих методов точность восстановления задается только в RMS. Опубликованные результаты указывают на то, что сжатие с помощью таких преобразований может использоваться для сокращения данных одного типичного цикла ЭКГ, но не для сжатия всей записи ЭКГ;
6) измеримость минимальных зубцов и воспроизводимость зазубрин/волн соединения определяет возможное сжатие ЭКГ. В настоящий момент согласно рекомендациям CSE требуется минимальная измеримость элементов до 20 мкВ/6 мс. В отчетах отмечались клинически значимые зазубрины длиной 4 мс. Однако в результате недавних экспериментов требования к минимальной длительности элементов сигнала по практическим причинам были доведены до 10 мс. При частоте 500 считываний/с более короткие элементы в действительности не могут быть надежно измерены;
7) стандартизация сжатия данных ЭКГ требует:
a) гармонизации спецификаций аппаратного обеспечения, шума усилителя, диапазона входного напряжения, точности аналого-цифрового преобразования, значения LSB и т.п.;
b) определения пределов воспроизводимости и максимальной устойчивости к ошибкам.
6.4.1 Предложенное решение по сжатию
За исключением сокращения избыточности, любое сжатие приводит к сокращению разрешения сигнала. Тем не менее, с практической точки зрения, не каждый мкВ разрешения и не каждый бит разрешения являются значимыми. Более важно то, что измерения, полученные при адекватных параметрах разрешения времени и амплитуды, соответствуют друг другу перед сжатием и после него.
Поэтому исследователями некоторых компаний была разработана схема сжатия, в которой эталонный цикл обрабатывается с помощью исходных данных и хранится или передается таким образом, чтобы повторная обработка обеспечила такие же результаты измерения, как и прежде. Этого можно достигнуть с помощью:
a) сжатия, использующего только сокращение избыточности;
b) передачей указателей (точек идентификации зубцов), позволяющих повторное измерение, на основании тех же ссылок.
За исключением эталонного цикла остаточная запись хранится и передается. Остаточная запись формируется путем вычитания эталонного цикла из исходной записи сигнала ЭКГ в каждой локации цикла. Остаточная запись пропускается через низкочастотный фильтр, обрезается, и частота считываний сокращается. Из этой записи первые или вторые разности амплитуды кодируются методом Хаффмана и хранятся или передаются. Воссоздание записи ЭКГ для просмотра возможно с помощью добавления эталонного цикла в остаточную запись в соответствующих местах циклов. Данный метод позволяет получить общие коэффициенты сжатия до 20 раз.
Подробный анализ данной схемы сжатия в проекте SCP-ECG показал, что в реконструированной записи могут возникать относительно большие ошибки в QRS-комплексе. Эти ошибки возникают в результате низкочастотной фильтрации. В частности, разделы QRS в остаточной записи содержат высокочастотные компоненты, которые удаляются после низкочастотной фильтрации, огрубления и сокращения частоты считываний, осуществляемых методами, предложенными и используемыми в некоторых коммерческих программах.
Поэтому в проекте SCP-ECG был разработан метод, применяющий, по сути, ту же самую схему сжатия, но при этом защищающий раздел QRS от низкочастотной фильтрации и сокращения частоты считываний. Таким образом, сохраняются все детали комплекса QRS-T, на основании которых должен быть выведен основной морфологический диагноз. В остаточной записи, необходимой для реконструкции записи ЭКГ, на основании которой должен быть сделан диагноз ритма, при применении схемы сжатия, разработанной в SCP-ECG, могут быть обнаружены только едва заметные человеческому глазу изменения. Эти изменения не влияют на диагноз ритма исследуемых случаев.
Основным преимуществом новой схемы сжатия является защита существенных деталей чувствительных разделов данных QRS и возможность значительного улучшения общей точности. Подробное описание методологии приведено в приложении C вместе с числовыми примерами.
6.4.2 Методология тестирования предложенных решений
Для исследования поведения этого и других разных алгоритмов сжатия первым использовался набор (тестовый набор номер 1), состоящий из 11 ЭКГ, взятых из базы данных CSE, предназначенной для оценки точности распознавания зубцов. Эти ЭКГ были выбраны в соответствии с ритмом (синусовый ритм, фибрилляция предсердий, трепетание предсердий), наличием "нормальных" циклов и экстрасистол, с различной морфологией QRS, включая обычный инфаркт, инфаркт миокарда, гипертрофию левого желудочка и другие. Они представляют различные типы сигналов ЭКГ и содержат низкие и высокие уровни низкой частоты (изолинии) и высокочастотного шума (частота сканирования, мышечный тремор). Основные наблюдения могут быть произведены на основании этого набора данных. Для получения статистически значимых данных был разработан второй набор (тестовый набор номер 2), состоящий из 89 + 19 ЭКГ из диагностических исследований CSE. Эти данные были выбраны в соответствии с распределением амплитуд, которые должны быть кратными 1 мкВ. Они также состоят из случаев с нормальным и нарушенным ритмом, экстрасистолами, а также с нормальной и патологической морфологией QRS.
В некоторых ситуациях полезно использовать искусственные сигналы (например, симулирующих трепетание предсердий) и нескольких искусственных ЭКГ с нормальной морфологией P-QRS-T. Во избежание неправдоподобных результатов, связанных с краями сигнала и т.п., было предусмотрено, что первые и вторые производные всех отведений являются непрерывными. Преимущество синтезированных сигналов заключается в том, что истинные амплитуды и интервалы известны, а результаты экспериментов сжатия не скрываются за последствиями удаления шума или его воспроизведения.
В приложении C представлен набор тестовых ЭКГ, с помощью которого в соответствии с требованиями, описанными в настоящем стандарте, может быть выполнено тестирование соответствия и оценивание на наличие ошибок в алгоритмах сжатия ЭКГ.
6.5.1 Общие положения
На основании результатов исследований, проведенных в рамках проекта SCP-ECG, в качестве стандарта для цифрового кодирования и сжатия ЭКГ были выбраны описанные ниже дискретизация и пределы искажений.
6.5.2 Категории схем сжатия
Можно идентифицировать три основные категории сжатия информации ЭКГ:
категория A | - | из исходной записи ЭКГ должен храниться или передаваться только набор параметров измерений и диагностических утверждений; |
категория B | - | хранится/передается набор измерений, диагностических утверждений и эталонный цикл, а также остаточная запись, из которых может быть реконструирована исходная запись ЭКГ с определенными искажениями; |
категория C | - | хранится/передается набор измерений и диагностических утверждений, а также сжатая исходная ЭКГ с сокращенной избыточностью. Кроме этого, эталонный цикл (в качестве результата обработки) также может быть сжат, храниться или передаваться. |
6.5.3.1 Способ сжатия данных оставлен на усмотрение производителей. Однако в том случае, когда применяется вычитание эталонного цикла, должны передаваться эталонный цикл типа 0 и остаточная запись. Ошибки реконструкции в единицах RMS и в абсолютных величинах должны верифицироваться на тестовом наборе SCP. Меры искажений должны вычисляться от начала первого вычитания до конца последнего вычитания. Для сжатия, при котором только исключается избыточность, ошибки реконструкции (в единицах RMS и абсолютных величинах, за исключением ошибок дискретизации) должны равняться 0 при оцифровке с частотой 500 считываний/с и дискретизацией 5 мкВ/LSB.
6.5.3.2 Если для сжатия данных используется вычитание эталонного цикла, то все отведения записи ЭКГ должны записываться одновременно.
6.5.3.3 Дискретизация: SR >= 500 считываний/с; LSB <= 5 мкВ.
6.5.3.4 Эталонный цикл: SR >= 500 считываний/с; LSB <= 5 мкВ.
6.5.3.5 Остаточная запись: ошибка усечения <= +/- 15 мкВ.
6.5.3.6 Остаточная запись: интервал между считываниями <= 8 мс.
6.5.3.7 Ошибка реконструкции: RMS <= 10 мкВ.
6.5.3.8 Абсолютная ошибка: <= 100 мкВ в одном считывании за пределами P-QRS-T.
6.5.3.9 Абсолютная ошибка внутри QRS: <= 15 мкВ в отдельном считывании.
(обязательное)
В МНОГОЯЗЫЧНОЙ СРЕДЕ
A.1 Общие положения
В настоящем приложении рассмотрен метод кодирования текстовых полей в SCP-ECG. Он взят из стандартов ИСО/МЭК, описывающих использование нескольких наборов символов. Для лучшего понимания настоящего приложения необходимо ознакомиться со структурой и правилами расширения 8-битового кода ИСО, представленных в ИСО/МЭК 4873 и ИСО/МЭК 2022.
Несколько наборов символов требуется не только в случае японского языка, но также для европейских языков, использующих символы, не входящие в ASCII (например,  в немецком языке,
 во французском,
 в шведском и т.п.). Таким образом, использование расширенных наборов символов должно обеспечить международное принятие протокола SCP-ECG.
в немецком языке, во французском, в шведском и т.п.). Таким образом, использование расширенных наборов символов должно обеспечить международное принятие протокола SCP-ECG.Строка символов, включающая неизвестные наборы символов, может привести к серьезным проблемам в идентификации пациентов в некоторых машинах. Поэтому в данном приложении должен быть также описан метод обработки не поддерживаемых наборов символов.
A.2 Область применения
К полям протокола SCP-ECG, перечисленным в таблице A.1, должно быть применено кодирование текста.
Таблица A.1
Поля протокола SCP-ECG
Раздел | Тег | Содержание |
1 | 0 | Фамилия |
1 | 1 | Имя |
1 | 2 | Идентификатор пациента |
1 | 3 | Вторая фамилия |
1 | 10 | Лекарственные средства |
1 | 13 | Диагноз или указание направления к специалисту |
1 | 14 | Идентификационный номер снимающего устройства |
1 | 15 | Идентификационный номер анализирующего устройства |
1 | 16 | Описание организации, в которой выполнено снятие |
1 | 17 | Описание организации, в которой выполнен анализ |
1 | 18 | Описание отделения, в котором выполнено снятие |
1 | 19 | Описание отделения, в котором выполнен анализ |
1 | 20 | Направивший врач |
1 | 21 | Самый последний подтверждающий врач |
1 | 22 | Описание лаборанта |
1 | 23 | Описание помещения |
1 | 30 | Поле свободного текста |
1 | 31 | Порядковый номер ЭКГ |
1 | 32 | Коды диагнозов в истории |
1 | 33 | Код конфигурации электрода |
1 | 34 | Часовой пояс |
1 | 35 | Анамнез заболевания свободным текстом |
8 + 11 | - | Диагностический отчет свободным текстом |
9 | - | Информация отчета, специфичная для производителя |
Данное кодирование предназначено в качестве формата обмена, а не внутреннего представления. Ожидается (но не требуется), что каждая компьютерная система ЭКГ должна преобразовывать данный формат в некоторое внутреннее представление для обработки и визуализации, а для обмена данными преобразовывать внутреннее представление в данный формат.
A.3 Ссылки и определения
A.3.1 Ссылки
См. раздел 2, а также следующие источники:
ИСО/МЭК 2375, Информационные технологии. Процедура регистрации управляющих последовательностей и наборов кодированных символов (ISO/IEC 2375, Information technology - Procedure for registration of escape sequences and coded character sets)
ИСО/МЭК 6429:1992, Информационные технологии. Функции управления для наборов кодированных символов (ISO/IEC 6429:1992, Information technology - Control functions for coded character sets)
ИСО/МЭК 8859-2:1999, Информационные технологии. 8-битовые однобайтовые наборы кодированных графических знаков. Часть 2. Латинский алфавит N 2 (ISO/IEC 8859-2:1999, Information technology - 8-bit single-byte coded graphic character sets - Part 2: Latin alphabet No. 2)
JIS X 0202, Методики расширения кода для использования с кодом для обмена информацией; Японский промышленный стандарт (JIS) [JIS X 0202, Code Extension Techniques for Use with the Code for Information Interchange; Japanese Industrial Standard (JIS)]
SCHEIFLER R.W. Compound Text Encoding version 1.1, MIT X Consortium Standard
A.3.2 Термины и определения
Для целей настоящего приложения следующие определения были взяты из ИСО/МЭК 4873 и JIS C 6228, который 1 марта 1987 г. был переименован в JIS X 0202.
В соответствии с настоящим стандартом набор символов Latin-1, определенный в ИСО/МЭК 8859-1, должен использоваться по умолчанию.
A.3.2.1 кодированный набор символов, код (coded character set, code): Набор однозначных правил, определяющий набор символов и связь один-к-одному между каждым символом набора и его кодированным представлением с помощью одного или нескольких сочетаний битов.
A.3.2.2 управляющий символ (control character): Функция управления, кодированное представление которой состоит из комбинации значений одного бита.
A.3.2.3 графический символ (graphic character): Символ, не являющийся функцией управления, обладающий визуальным представлением, как правило, написанным от руки, напечатанным или отображенным, который также обладает кодированным представлением, состоящим из одной или нескольких комбинаций битов.
A.3.2.4 функция управления (control function): Действие, влияющее на запись, обработку, передачу или интерпретацию данных, которое также обладает кодированным представлением, состоящим из одной или нескольких комбинаций битов.
A.3.2.5 спецификация формата (format effector): Символ, управляющий организацией и расположением информации в устройствах визуализации символов, например, устройствах печати и отображения.
A.3.2.6 назначать (to designate): Идентифицировать набор символов, которые необходимо представить заранее определенным образом в некоторых случаях сразу, а в других при появлении следующей функции управления.
A.3.2.7 вызывать (to invoke): Обеспечить представление назначенного набора символов с помощью заранее определенных комбинаций битов там, где эти комбинации битов возникают, и до тех пор, пока не появится соответствующая функция расширения.
A.3.2.8 представлять (to represent):
a) использовать заранее определенную комбинацию битов, назначающую символ из назначенного и вызванного набора символов, или
b) использовать управляющую последовательность со значением дополнительной управляющей функции.
A.4 Значения
Значения байтов представлены в настоящем приложении как два десятичных числа в форме столбец/строка в соответствии со стандартами ИСО/МЭК. Это означает, что значение может быть вычислено как (столбец*16) + строка; например, 01/11 соответствует значению 27 (1B hex).
Пространство кодирования байтов разделено на четыре диапазона (см. рисунок A.1):
C0 | байты с 00/00 по 01/15; |
GL | байты с 02/00 по 07/15; |
C1 | байты с 08/00 по 09/15; |
GR | байты с 10/00 по 15/15. |
Диапазоны C0 и C1 являются наборами "управляющих символов", в то время как GL и GR являются наборами "графических символов". В диапазоне GL байт 02/00 всегда определяется как пробел (SPACE), а байт 07/15 (обычно команда удаления DELETE) никогда не используется.
Массив из столбцов 16 на 16, пронумерованных от 00 до 15, и строк, пронумерованных от 0 до 15, содержит 256 позиций кодов. Столбцы массива с 00 по 07 содержат 128 позиций символов, которые находятся в отношении один к одному с символами 7-битового набора. Их кодированное представление является таким же, как в 7-битовой среде с добавлением восьмого бита, равного НУЛЮ. Столбцы с 08 по 15 содержат дополнительные 128 позиций. Восьмой бит их кодового представления является ЕДИНИЦЕЙ. Столбцы с 08 по 09 используются для обозначения управляющих символов, а столбцы с 10 по 15 - для обозначения графических символов, за исключением позиций 10/0 и 15/15.
Кодовая 8-битовая таблица может быть расширена за счет различных средств расширения, одним из которых является применение соответствующей управляющей последовательности, как показано в A.6.2.
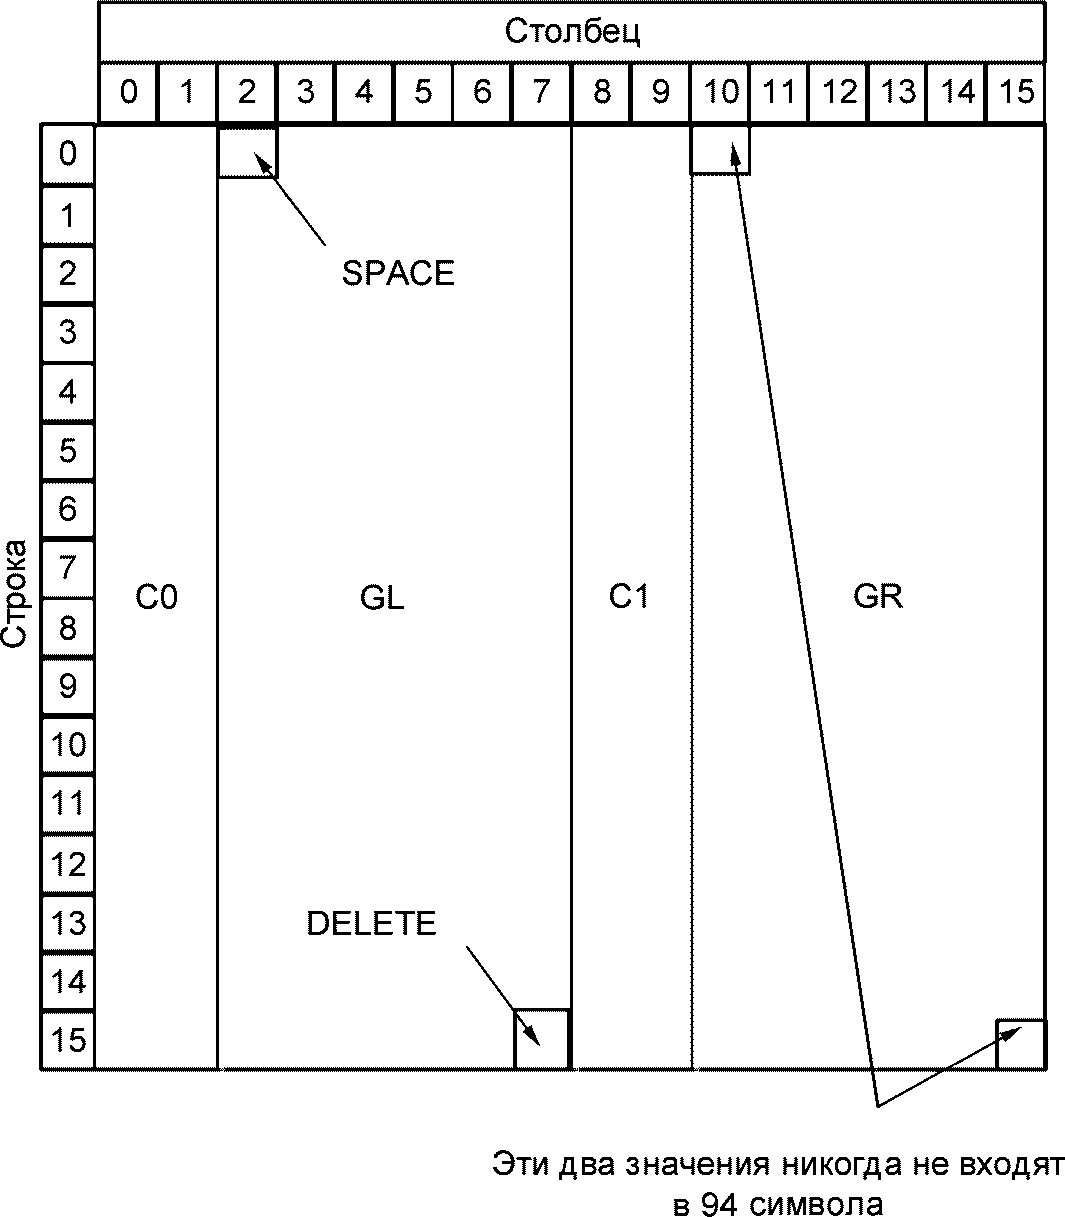
A.5 Управляющие символы
Определение каждого управляющего символа взято из ИСО/МЭК 646 и ИСО/МЭК 4873.
Как показано в таблице A.2, в SCP-ECG для кодирования свободного текста должно использоваться только подмножество управляющих символов C0. Не должны использоваться никакие значения из управляющего набора C1.
При обмене данными текстовых строк (например, определенных в разделах 8, 10 и 11) может потребоваться некоторая информация по их формату. Для этой цели должны использоваться символы форматирования (перечисленные в таблице A.2), но их использование должно быть сведено к минимуму, так как некоторые машины могут неправильно их обрабатывать.
Таблица A.2
Категория | Обозначение | Название | Кодированное представление |
Символ форматирования | BS | BACKSPACE (возврат) | 00/08 |
Символ форматирования | HT | HORIZONTAL TAB (горизонтальная табуляция) | 00/09 |
Символ форматирования | LF | LINE FEED (перевод строки) | 00/10 |
Символ форматирования | VT | VERTICAL TAB (вертикальная табуляция) | 00/11 |
Символ форматирования | FF | FORM FEED (перевод страницы) | 00/12 |
Символ форматирования | CR | CARRIAGE RETURN (возврат каретки) | 00/13 |
Расширение кода | ESC | ESCAPE (выход) | 01/11 |
1) BS
Возврат может использоваться для формирования составных символов с помощью наложения знаков (ИСО/МЭК 646 позволяет осуществлять представление такого рода). Тем не менее некоторые машины не имеют возможности наложения знаков, поэтому для представления составных символов лучше использовать адекватные наборы символов (например, ИСО/МЭК 8859-1).
2) HT, VT
Спецификация настроек ширины табуляции не является частью данного предложения.
3) CR
Возврат каретки также может использоваться для образования составных символов. То же самое можно сказать о BACKSPACE.
4) LF
Некоторые машины (например, работающие с операционной системой UNIX) могут интерпретировать перевод строки (00/10) как переход на начало новой строки (NEWLINE). Это можно интерпретировать как использование (нерекомендуемого) режима NEW LINE, описанного в E.1.3 в ИСО/МЭК 6429:1992.
В настоящем приложении символ форматирования NEWLINE представлен парой CR + LF. Поэтому при использовании описанной выше среды ожидается, что эта пара преобразуется во внутреннее представление (т.е. CR + LF преобразуется в LF).
Нулевой байт (NULL) используется в протоколе SCP-ECG в качестве признака завершения строки. Но он не является частью этой строки. Это соответствует ИСО/МЭК 646 и ИСО/МЭК 4873.
A.6 Кодирование набора символов
A.6.1 Общий принцип многоязычного кодирования текста
Для реализации многоязычной среды необходимо средство переключения разных наборов символов в текстовой строке. Некоторые графические символы обладают различным визуальным представлением, но имеют один код, например, строчная "a" с тильдой, определенная в ИСО/МЭК 8859-1, и строчная "a" с бревисом, определенная в ИСО/МЭК 8859-2, имеют один код, а именно 14/03. Кроме того, существуют некоторые многобайтовые наборы символов, например японский Кандзи и китайский Ханьцзы, содержащие тысячи символов, кодирование которых одним байтом невозможно.
ИСО/МЭК 2022 определяет способы расширения кода (см. рисунок A.2), делая возможным использование нескольких наборов графических символов в текстовой строке, обеспечивая тем самым многоязычную среду. В ИСО/МЭК 2022 расширение кода реализуется отображением желаемого набора графических символов на кодовое пространство, используя следующие два шага:
1) желаемый набор графических символов назначается как одно из множеств G0, G1, G2 или G3; это выполняется с помощью управляющих последовательностей;
2) назначенный набор (G0, G1, G2 или G3) отображается в пространстве кодирования с 02/00 по 07/15 или 10/00 по 15/15; это выполняется с помощью функций переключения регистра.
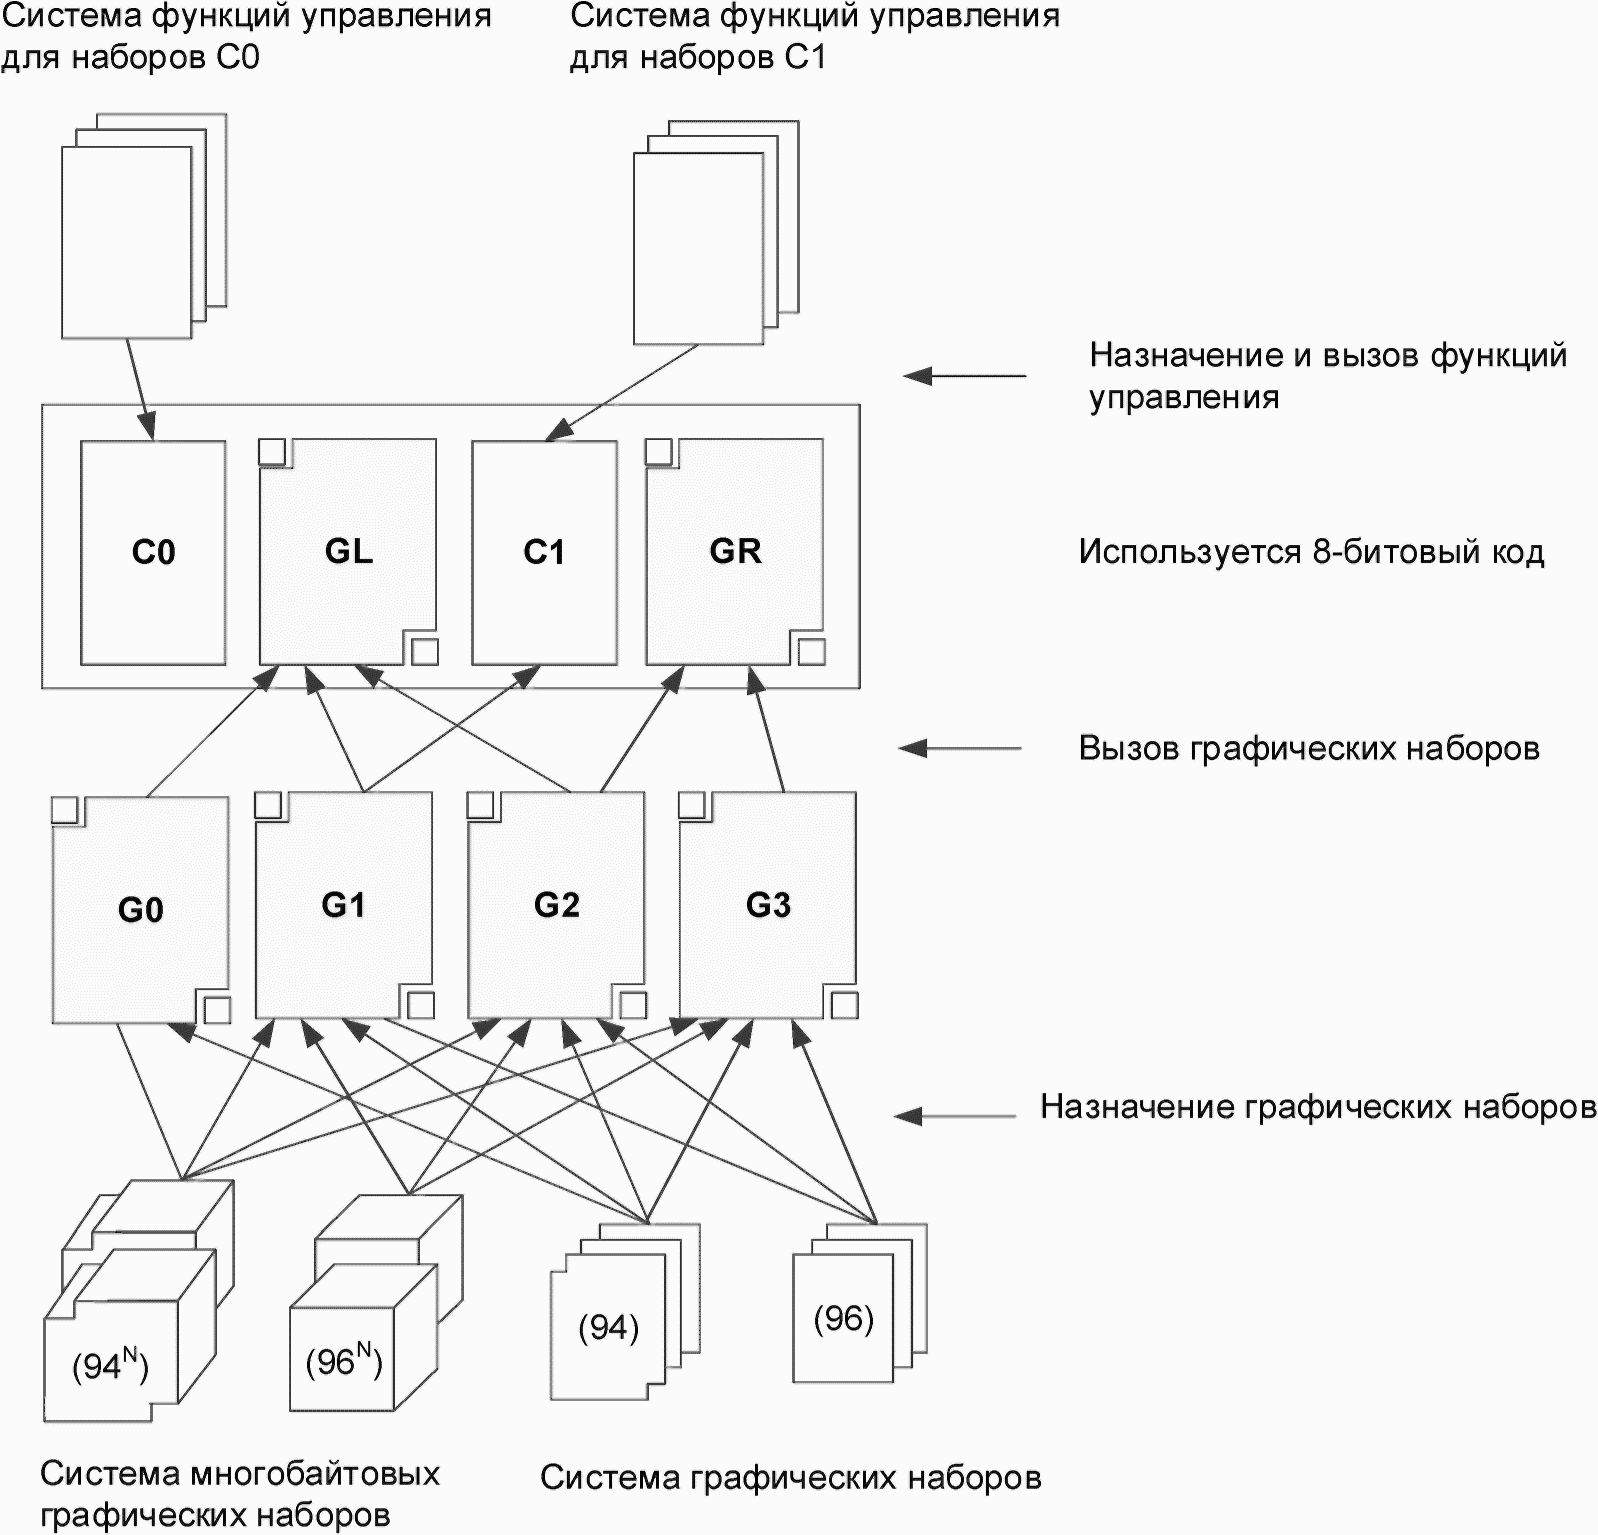
A.6.2.1 Следует использовать только 8-битовую среду, а также всегда применять G0 для GL и G1 для GR (см. рисунок A.3). Такой подход реализуется за счет объявления необходимых средств расширения в соответствии с разделом 9 в ИСО/МЭК 2022:1994. В этом случае назначение также служит вызовом, поэтому необходимость в явном вызове отсутствует.
Набор из 96 символов может быть назначен/вызван только в диапазон GR. Это связано с тем, что код 02/00 назначен пробелу (SPACE), а код 07/15 - удалению (DELETE), поэтому диапазон GL может содержать только 94 символа в диапазоне кодов от 02/01 до 07/14. Диапазон GR может содержать 96 символов с кодами от 00/00 до 15/15. Поэтому в диапазон GR могут быть вызваны как наборы из 94 символов, так и наборы из 96 символов.
В наборе из 94 символов никакие символы не должны размещаться в позициях 02/00, 07/15, 10/00 и 15/15, в то время как в наборе из 96 символов эти позиции могут содержать символы. Трехмерный блок на рисунке A.3 представляет многобайтовый набор символов. Набор из 94N символов использует N (N > 1) байтов для каждого символа, как показано на рисунке A.3.
A.6.2.2 По умолчанию набор GL соответствует левой половине таблицы ИСО/МЭК 8859-1. Это равносильно кодировке ASCII (ANSI X3.4-1968).
A.6.2.3 По умолчанию набор GR соответствует правой половине таблицы ИСО/МЭК 8859-1. Эти спецификации определяют набор символов по умолчанию, который может использоваться без управляющей последовательности в соответствии с указанным в 6.4 "Начальным назначением и вызовом" в ИСО/МЭК 2022. Подмножество ИСО/МЭК 2022 для SCP-ECG показано на рисунке A.3.
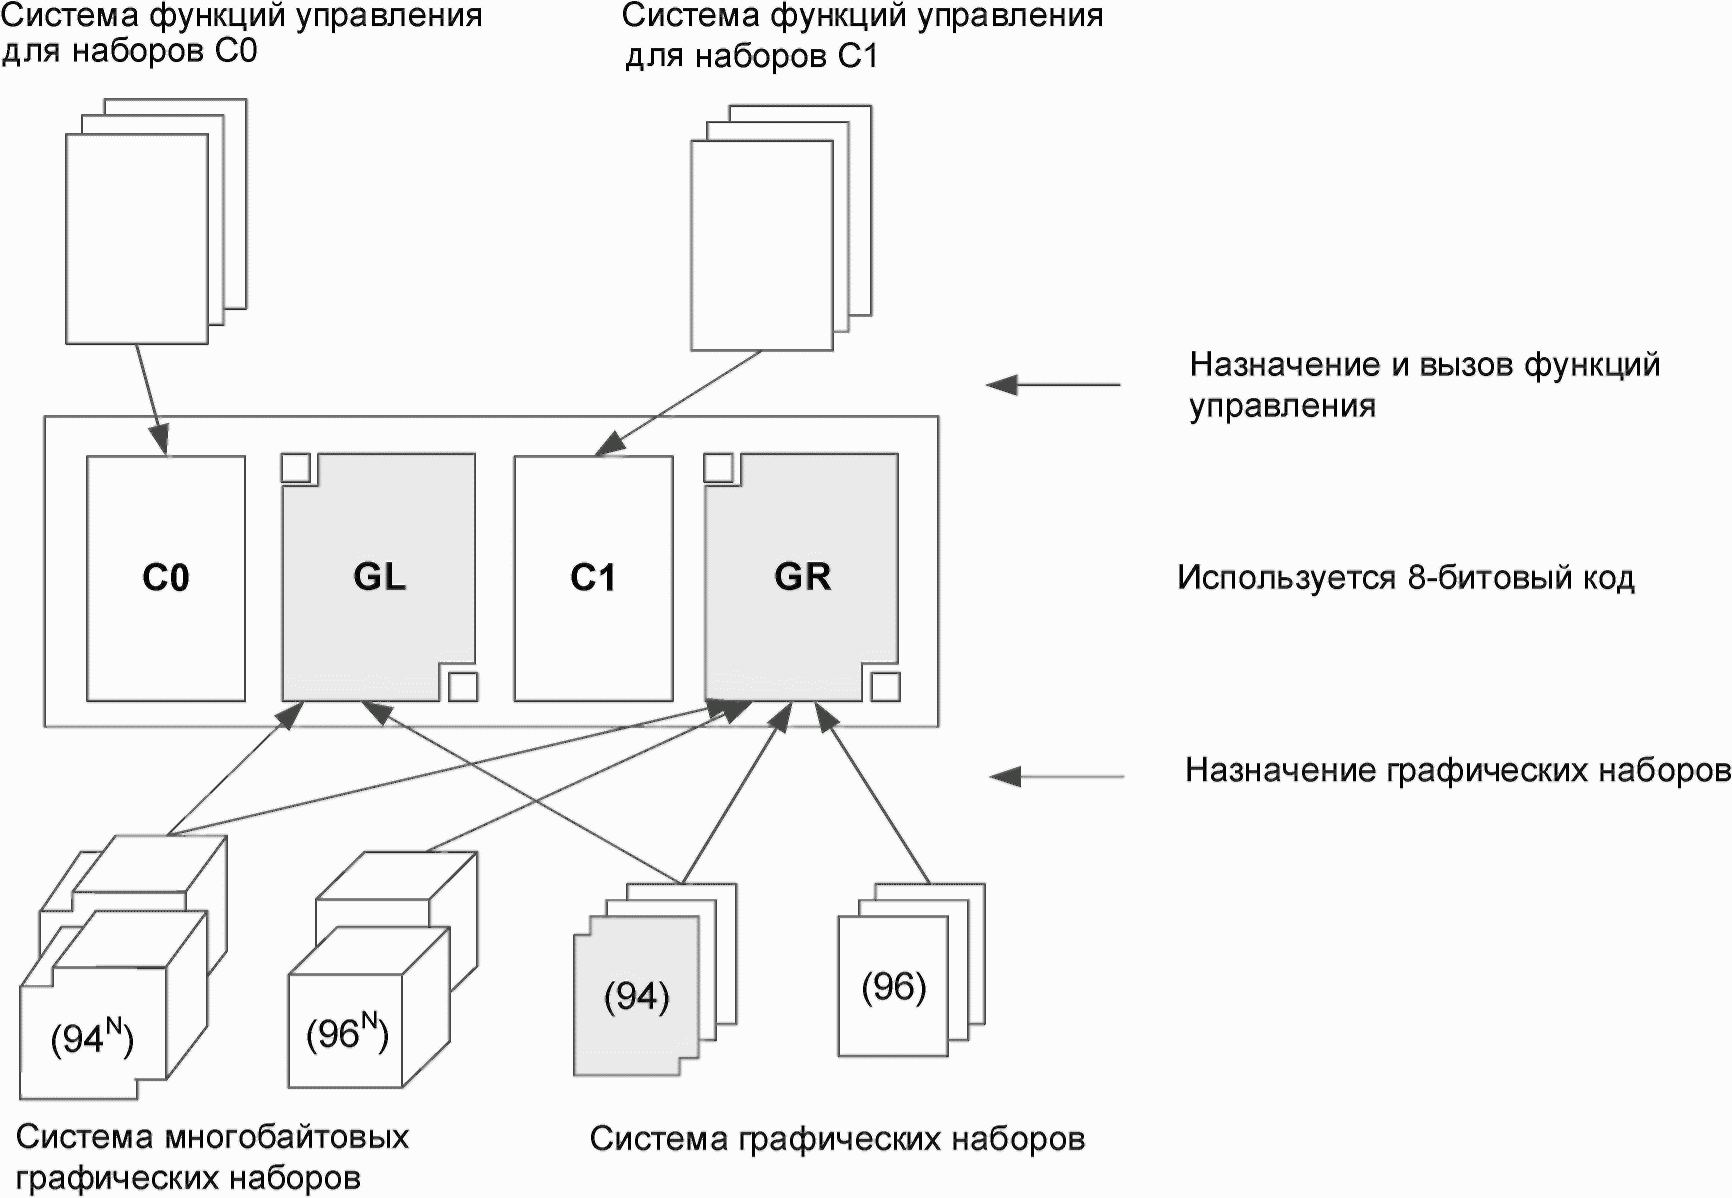
(подмножество ИСО/МЭК 2022)
A.6.2.4 Подразумеваемое начальное состояние в ИСО/МЭК 2022 определено последовательностью, показанной в таблице A.3.
Таблица A.3
Подразумеваемое начальное состояние в ИСО/МЭК 2022
Управляющая последовательность | Описание |
ESC 02/00 04/03 | G0 и G1 только в 8-битовой среде. Назначение также служит вызовом |
ESC 02/00 04/07 | В 8-битовой среде, C1 представлено в 8 битах |
ESC 02/00 04/09 | Наборы графических символов могут содержать 94 или 96 символов |
ESC 02/00 04/11 | Используется 8-битовый код |
ESC 02/08 04/02 | Назначение ASCII в G0 |
ESC 02/13 04/01 | Назначение правой части ИСО Latin-1 в G1 |
ESC 02/01 04/00 | Назначение ИСО/МЭК 646 в C0 |
Набор символов по умолчанию для SCP-ECG показан на рисунке A.4.
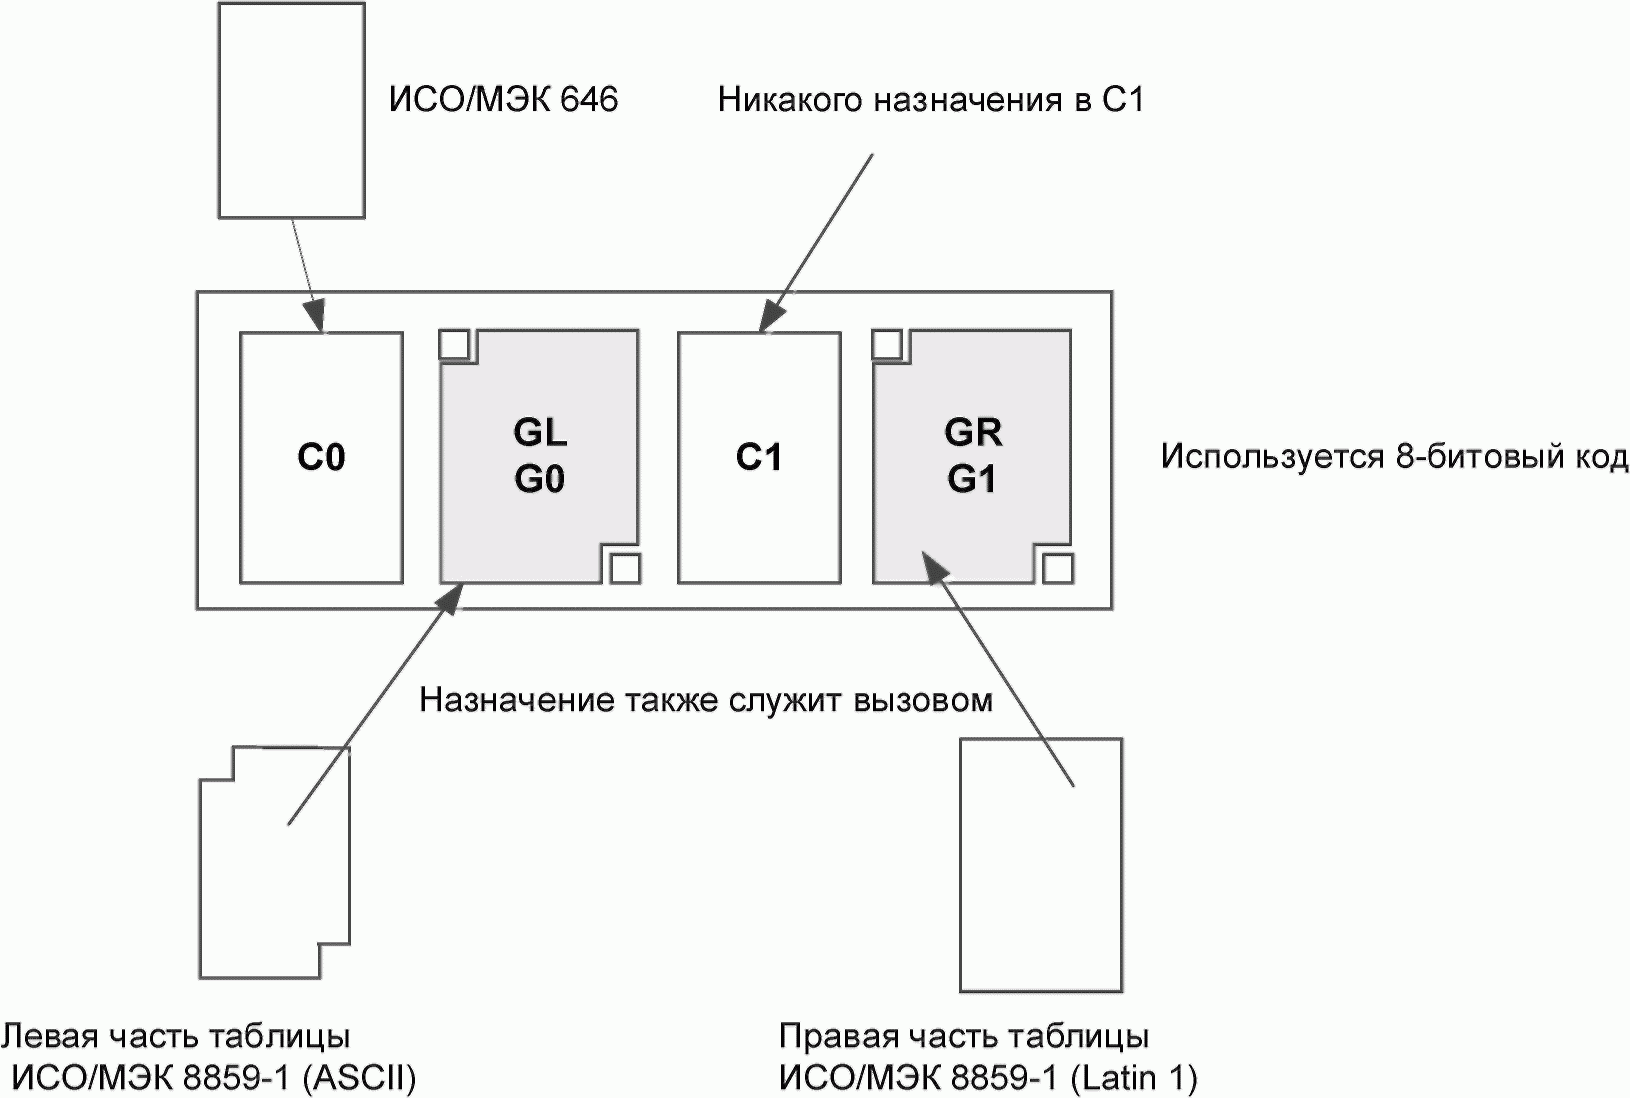
Рисунок A.4 - Набор символов по умолчанию для SCP-ECG
A.6.3 Расширение набора символов
A.6.3.1 На рисунке A.5 показана структура поля строки, закодированного в соответствии с ИСО/МЭК 2022. Текстовая строка с таким кодированием содержит символы управляющей последовательности или функции переключения регистра, а также объявление средств расширения в начале строки.
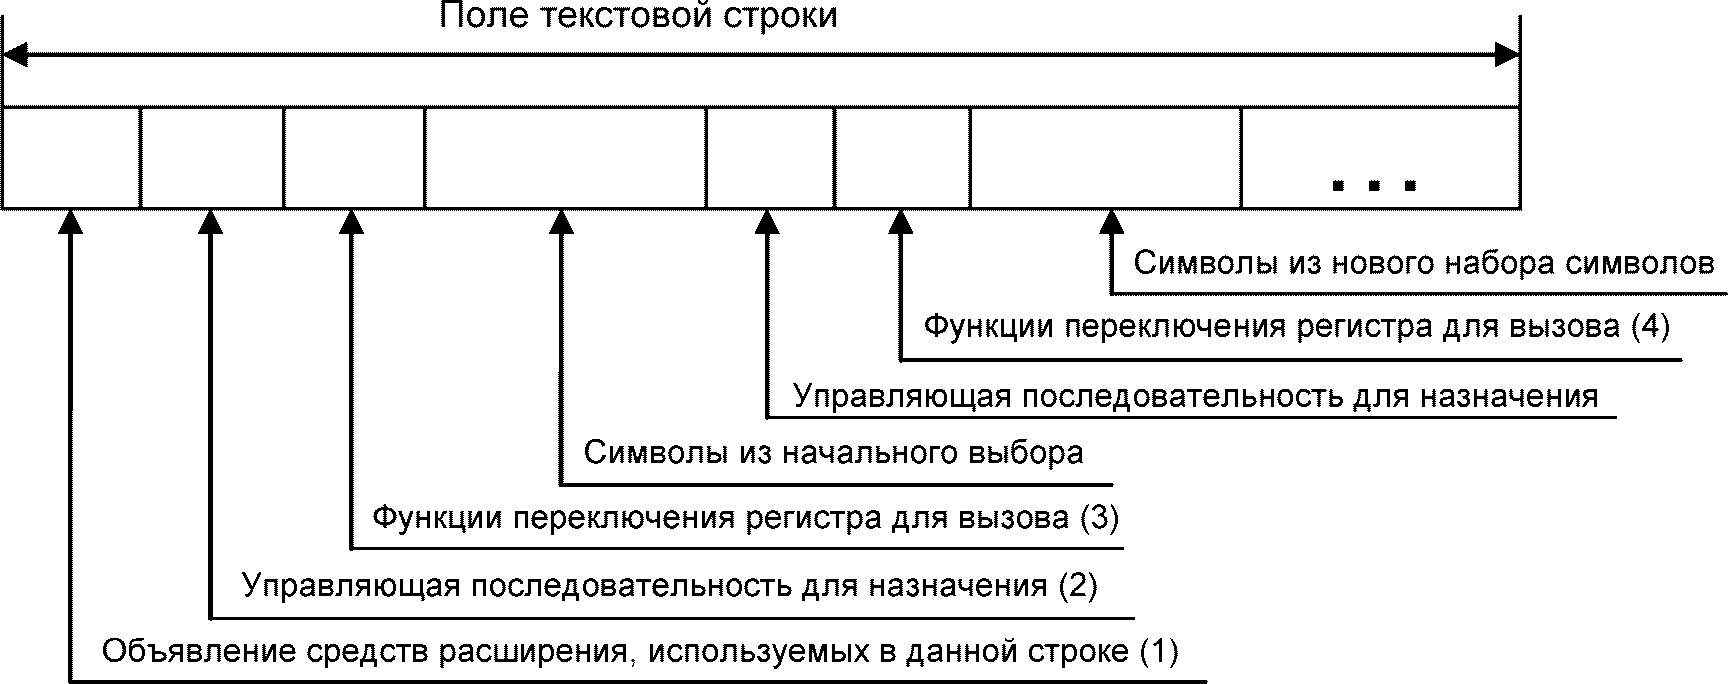
A.6.3.2 Метод ИСО/МЭК 2022 является гибким и эффективным, но его полная реализация может быть очень сложной для протокола SCP-ECG. Некоторые управляющие последовательности, функции переключения регистра и объявления могут быть опущены в соответствии с настоящим стандартом.
Чтобы опустить некоторые управляющие последовательности и предложить более простой метод многоязычного кодирования, применяются следующие правила:
1) объявления (1), показанные на рисунке A.5, должны быть опущены по соглашению между обменивающимися сторонами о средствах расширения;
2) функции переключения регистра (3) и (4) должны быть опущены с помощью управляющих последовательностей, которые назначают, а также вызывают G0 и G1 в GL и GR соответственно, как это определено последовательностью "ESC 02/00 04/03";
3) управляющая последовательность (2) опускается с помощью следующей начальной установки по умолчанию:
- назначить ASCII (левая часть таблицы ИСО/МЭК 8859-1) в G0, а также вызвать ее в GL,
- назначить Latin-1 (правая часть ИСО/МЭК 8859-1) в G1, а также вызвать ее в GR,
- назначить ИСО/МЭК 646 в C0,
- никаких назначений в C1.
Если используется только набор ИСО/МЭК 8859-1, то в текстовой строке не должны присутствовать никакие управляющие последовательности. Это обычная 8-битовая текстовая строка в кодировке ASCII. Если в строке требуется другой набор символов, то для переключения набора символов необходимо указать перед ним управляющую последовательность.
Формат текстового поля с несколькими наборами символов приведен в таблице A.4.
Таблица A.4
Формат кодированной текстовой строки в SCP-ECG
Символы из набора символов по умолчанию | Управляющая последовательность | Символы из нового набора символов | Управляющая последовательность для смены набора символов | - |
Каждая передаваемая строка должна начинаться с набора символов по умолчанию. Новое поле или завершающий NULL должны осуществлять сброс к набору символов по умолчанию.
A.6.3.3 Формат управляющей последовательности для набора символов расширения
ESC {I} F:
- "ESC" является символом начала управляющей последовательности. Он имеет кодовое представление 01/11.
- "{I}" означает один или несколько "промежуточных символов", которые находятся в диапазоне 02/00 - 02/15. Он задает функцию управляющей последовательности.
- "F" означает "финальный символ", который всегда находится в диапазоне 04/00 - 07/14. Финальные символы зарегистрированы международным регистрирующим органом. Некоторые из финальных символов перечислены в A.6.4.
A.6.3.4 Чтобы указать, что другой набор символов является GL-набором, используется одна из следующих управляющих последовательностей:
ESC 02/08 F | Набор из 94 символов; |
ESC 02/04 02/08 F | Набор из 94N символов; |
ESC 02/04 F | Некоторый специальный набор из 94N символов. |
В последовательности "ESC 02/04 F" могут использоваться финальные символы 04/01 и 04/02. Это исключение взято из 6.3.9, ИСО/МЭК 2022:1994. Последовательность "ESC 02/04 04/02" для набора японских символов широко используется в Японии.
A.6.3.5 Чтобы указать, что другой набор символов является GR-набором, используется одна из следующих управляющих последовательностей:
ESC 02/09 F | Набор из 94 символов; |
ESC 02/13 F | Набор из 96 символов; |
ESC 02/04 02/09 F | Набор из 94N символов. |
A.6.3.6 Разрешены промежуточные символы 02/00, 02/01, 02/04, 02/09 и 02/13. Следующие промежуточные символы не разрешены в SCP-ECG:
02/02, 02/03, 02/05, 02/06, 02/07, 02/10, 02/11, 02/12, 02/14 и 02/15.
A.6.3.7 Финальные символы для частного кодирования (в диапазоне от 03/00 до 03/15) не разрешены в SCP-ECG.
A.6.3.8 Другие управляющие последовательности, описанные в ИСО/МЭК 2022, не должны использоваться для SCP-ECG.
A.6.3.9 Набор из 94N символов использует для каждого символа N байтов (N > 1). Значение N получено из значения столбца финального символа F, указанного выше:
столбец 04 | 2 байта; |
столбец 05 | 2 байта; |
столбец 06 | 3 байта; |
столбец 07 | 4 или более байтов. |
В кодировании 94N значения байтов 02/00 и 07/15 (в GL), а также 10/00 и 15/15 (в GR) никогда не используются (определения столбцов взяты из ИСО/МЭК 2022).
В SCP-ECG должны использоваться только международные зарегистрированные финальные символы. Некоторые из финальных символов, которые могут использоваться, показаны в таблице A.5.
Наборы, перечисленные как "Левая половина...", всегда должны определяться как GL. Наборы, перечисленные как "Правая половина...", всегда должны определяться как GR. Другие наборы могут определяться как GL, так и GR.
Если финальные коды 04/01, 04/02 и 04/03 используются в форме "ESC 02/04 F", то они всегда определены как GR.
Таблица A.5
F | 94/96 | Описание |
04/02 | 94 | 7-битовая графика ASCII (ANSI X3.4-1968). Левая половина наборов ИСО/МЭК 8859 |
04/09 | 94 | Правая половина JIS X 0201-1976 (подтверждена в 1984 году) 8-битовый код алфавитно-цифровой Катаканы |
04/10 | 94 | Левая половина JIS X 0201-1976 (подтверждена в 1984 году) 8-битовый код алфавитно-цифровой Катаканы |
04/01 | 96 | Правая половина ИСО/МЭК 8859-1, латинский алфавит N 1 |
04/02 | 96 | Правая половина ИСО/МЭК 8859-2, латинский алфавит N 2 |
04/03 | 96 | Правая половина ИСО/МЭК 8859-3, латинский алфавит N 3 |
04/04 | 96 | Правая половина ИСО/МЭК 8859-4, латинский алфавит N 4 |
04/06 | 96 | Правая половина ИСО/МЭК 8859-7, латинский/греческий алфавит |
04/07 | 96 | Правая половина ИСО/МЭК 8859-6, латинский/арабский алфавит |
04/08 | 96 | Правая половина ИСО/МЭК 8859-8, латинский/еврейский алфавит |
04/12 | 96 | Правая половина ИСО/МЭК 8859-5, латинский алфавит/кириллица N 1 |
04/13 | 96 | Правая половина ИСО/МЭК 8859-9, латинский алфавит N 5 |
04/01 | 942 | GB2312-1980, Ханьцзы Китая (КНР) |
04/02 | 942 | JIS X 0203-1983, набор японских графических символов |
04/03 | 942 | KS C5601-1987, набор корейских графических символов |
A.7 Код языка
Поле "Код языка" раздела 2 в протоколе SCP-ECG используется для идентификации класса используемого набора символов. Это поле кодируется в соответствии с таблицей A.6.
Таблица A.6
Код языка
Значение | Описание |
Бит 0 сброшен в 0 | Используется только кодировка ASCII |
Бит 0 установлен в 1 | Использует набор символов, не связанный с кодировкой ASCII (включает правую половину ИСО/МЭК 8859-1) |
Бит 1 сброшен в 0 | Используется только ИСО/МЭК 8859-1 |
Бит 1 установлен в 1 | Используются наборы символов, отличные от ИСО/МЭК 8859-1 |
Бит 2 сброшен в 0 | Многобайтовый набор символов не используется |
Бит 2 установлен в 1 | Используется многобайтовый набор символов |
Биты с 3 по 7 | Всегда сбрасываются в 0 |
Следует учитывать, что при использовании правой половины ИСО/МЭК 8859-1 бит 0 должен иметь значение 1. В этом случае в строке не должны появляться никакие управляющие последовательности.
A.8 Метод обработки не поддерживаемых наборов символов
A.8.1 Общие положения
Использование в строке не поддерживаемых наборов символов может привести к серьезным проблемам при идентификации пациента. Ниже описан метод обработки не поддерживаемых наборов символов. Предполагается, что существует система, которая может отобразить/напечатать все символы.
A.8.2 Машина, использующая ИСО/МЭК 8859-1
Все символы диапазонов GR и GL, которые не поддаются обработке, следует распечатывать, отображать и вводить следующим образом:
- заменить все символы "\" (05/02) на два символа "\\";
- заменить символ перехода (escape) (01/11), предшествующий неизвестным управляющим последовательностям, на четыре символа "\033". Следует учесть, что известные управляющие последовательности должны обрабатываться надлежащим образом.
A.8.2.1 Машина, использующая ASCII
Все символы диапазонов GR и GL, которые не поддаются обработке, следует распечатывать, отображать и вводить следующим образом:
- заменить все символы "\" (05/02) на два символа "\\";
- заменить символ перехода (escape) (01/11), предшествующий неизвестным управляющим последовательностям, на четыре символа "\033" (следует учесть, что известные управляющие последовательности должны обрабатываться надлежащим образом);
- заменить символы диапазона GR на четыре символа "\nnn", где "nnn" - трехзначное восьмеричное представление каждого байта.
Проверка кода языка является полезной практикой для данного метода. Тем не менее синтаксический разбор текстовой строки по-прежнему необходим, так как в одной строке могут быть как поддерживаемые, так и неподдерживаемые наборы символов.
Примечание - Это предложение не определяет действия для случаев переполнения полей отображения, печати или ввода.
A.9 Краткое изложение управляющих последовательностей, описанных в данном приложении для кодирования произвольного текста в SCP-ECG
В начале обмена информацией может потребоваться объявление средств расширения кода, использованных в последующих данных. Если подобное объявление должно быть вложено в кодированную символьную информацию, то следует использовать один или несколько классов трехсимвольных управляющих последовательностей ESC 02/00 F. В зависимости от соглашения между обменивающимися сторонами подобное объявление может быть опущено.
Не перечисленные в таблице A.7 управляющие последовательности не должны использоваться в текстовых полях. "Объявитель" не должен явно отображаться в этом поле.
Таблица A.7
Управляющие последовательности
Управляющая последовательность | Описание | Примечание |
ESC 02/00 04/03 | Диапазоны G0 и G1 используются только в 8-битовой среде; назначение также служит вызовом | Объявитель <a> |
ESC 02/00 04/07 | В 8-битовой среде коды диапазона C1 представлены в 8 битах | Объявитель <a> |
ESC 02/00 04/09 | Наборы графических символов могут содержать 94 или 96 символов | Объявитель <a> |
ESC 02/00 04/11 | Используется 8-битовый код | Объявитель <a> |
ESC 02/08 04/02 | Назначить левую половину ASCII ИСО/МЭК 8895-1 в диапазон G0 | По умолчанию |
ESC 02/13 04/01 | Назначить правую половину ИСО/МЭК 8895-1 Latin-1 в диапазон G1 | По умолчанию |
ESC 02/01 04/00 | Назначить ИСО/МЭК 646 в диапазон C0 | По умолчанию |
ESC 02/08 F | Назначить набор из 94 символа в диапазон G0 | |
ESC 02/04 02/08 F | Назначить набор из 94N символов в диапазон G0 | |
ESC 02/04 F | Назначить набор некоторых специальных символов 94N в диапазон G0 | |
ESC 02/09 F | Назначить набор из 94 символов в диапазон G1 | |
ESC 02/13 F | Назначить набор из 96 символов в диапазон G1 | |
ESC 02/04 02/09 F | Назначить набор из 94N символов в диапазон G1 | |
<a> Финальные символы (04/03, 04/07, 04/09, 04/11) объявляют фактически используемое расширение кода, отсюда происходят понятия "объявитель", а также "объявляющая последовательность". Финальный символ объявляющей последовательности указывает средства представления графических наборов и некоторых наборов управления в 7-битовой и 8-битовой средах. | ||
A.10 Примеры кодированных текстовых строк
Ниже приведены некоторые примеры закодированных строк. Показано также представление в неподдерживающей среде.
Примеры
1 Строка ИСО/МЭК 8859-1: | |
текст: |  |
кодовое представление: | 14/04 14/07 14/05 |
в неподдерживаемой среде: | \344\347\345 |
2 Смесь ASCII и строки на японском Кандзи (JIS X 0208): | |
текст: |  |
кодовое представление: | как показано в таблице A.8. |
Таблица A.8
Кодовое представление
Кодирование символа | Комментарии |
06/01 | Символ "a" |
06/02 | Символ "b" |
06/03 | Символ "c" |
01/11 02/04 04/02 | Управляющая последовательность для перехода на Кандзи |
04/06 07/12 | Первый символ показанной выше строки на Кандзи  |
04/11 05/12 | Второй символ показанной выше строки на Кандзи  |
03/08 06/12 | Третий символ показанной выше строки на Кандзи  |
01/11 02/08 04/02 | Управляющая последовательность для перехода на ASCII |
03/01 | Символ "1" |
03/02 | Символ "2" |
03/03 | Символ "3" |
(обязательное)
B.1 Общие сведения
Стандарт SCP-ECG определяет средства, с помощью которых устройства и системы ЭКГ могут обмениваться информацией. Категории формата данных, определенные в настоящем приложении, предоставляют пользователям и производителям устройств и/или систем ЭКГ достаточно простую кодификацию функций и информационного содержания, связанного с SCP-ECG, которые могут быть предоставлены конкретным устройством. Способы кодирования данных ЭКГ точно определены, но при этом являются гибкими. При реализации настоящего стандарта производитель может ограничиться некоторым подмножеством всех возможных способов кодирования данных ЭКГ. Поэтому в разделе B.3 определена процедура тестирования, которое должны пройти производители, объявляющие соответствие SCP-ECG. В связи с гибкостью, допускаемой в информационном содержании и кодировании, пользователь/покупатель должен определить, насколько устройство и/или система пригодны для конкретного применения.
Производители, объявляющие соответствие своих устройств и/или систем стандарту SCP-ECG, должны следовать спецификациям и определениям, приведенным в настоящем приложении. Формат данных включает в себя элементы, указанные в разделах 5 и 6 настоящего стандарта (и в приложениях, на которые они ссылаются). Соответствие поддержки коммуникаций не является обязательной частью настоящего стандарта. Если обмен записями ЭКГ между двумя разными устройствами картирования и/или системами выполняется по каналам последовательной передачи данных (прямое подключение по кабелю или через модем), то возможным решением может служить использование функций передачи сообщений запросов, указанных в приложении D, и транспорта данных, описанного в приложении E. Если используются различные средства обеспечения коммуникаций (например, Bluetooth, беспроводное соединение, ЛВС и т.п.), то сообщения запросов и транспорт данных должны быть точно описаны в стиле приложений D и E. Эти описания должны быть сделаны свободно доступными, чтобы потенциальные пользователи/покупатели устройства картирования или системы могли получать их по запросу.
В настоящее время не существует признанного средства/метода, позволяющего осуществлять проверку соответствия спецификациям настоящего стандарта. В лучшем случае подобное средство было бы полезно производителям в их деятельности по обеспечению совместимости их устройств. За счет гибкости, которую позволяют информационное содержание и кодирование, совместимость между устройствами разных производителей должна определяться для каждого случая, даже если было показано, что оба устройства соответствуют стандарту SCP-ECG. От одной лишь декларации о соответствии настоящему стандарту будет мало пользы пользователю/покупателю. Поэтому декларация о соответствии стандарту SCP-ECG должна сопровождаться декларацией о совместимости с устройством или устройствами другого производителя или производителей, однозначно идентифицированных торговой маркой производителя, описанием модели и идентификатором программного обеспечения, реализующего SCP.
B.2 Спецификация соответствия
B.2.1 Категории форматов данных
В таблице B.1 определены категории форматов данных, которые должны использоваться в декларации о соответствию стандарту SCP-ECG. Информационное содержание, предусмотренное каждой категорией, представлено в графе "Описание содержания". Соответствие предполагает, что данные каждого раздела должны кодироваться, как указано в применимом подразделе раздела 5.
Таблица B.1
Категория | Требуемый раздел данных | |
I | Демографические данные и данные ритма ЭКГ (несжатые или сжатые без потери качества) | |
II | 0, 1, [2] <a>, 3, 4, 5, 6, (7) <b>, (8) <b>, (10) <b> | Демографические данные, данные ритма ЭКГ (несжатые или сжатые без потери качества) и эталонные циклы |
<a> Квадратные скобки [.] указывают на то, что раздел данных 2 необходим, если использовалось кодирование Хаффмана. <b> Круглые скобки (.) указывают на то, что эти разделы данных не обязательны для экспорта. "Импорт" и "Экспорт" определены в B.2.2. | ||
В будущих версиях может быть добавлена дополнительная категория, удовлетворяющая определенным требованиям устройств ЭКГ, используемых в других приложениях (например, в телемедицине или медицинской помощи на дому).
Все устройства, для которых декларировано соответствие стандарту SCP-ECG, должны как минимум импортировать данные, описанные в разделах 0, 1, 3, 6, 7 и 8. Во все категории могут быть добавлены дополнительные разделы (например, 9, 10, 11). Данные, специфичные для производителя, должны (не обязательно) быть включены в определенные в настоящем стандарте поля, байты и блоки данных, специфичные для производителя. Зарезервированные, не указанные и не определенные поля, байты и блоки данных не должны использоваться для данных, специфичных для производителя.
B.2.2.1 Экспорт
Способность сделать запись SCP-ECG, имеющую заданную категорию формата данных, доступной для коммуникационных каналов. В соответствии со спецификацией SCP-ECG запись SCP-ECG создается из необработанных данных ЭКГ, с использованием сжатия, указанного в 6.5.3.
B.2.2.2 Импорт
Способность принимать из коммуникационного канала, извлекать и делать доступной для пользователя информацию из записи SCP-ECG, имеющей заданную категорию формата данных. Импортирующее устройство должно как минимум импортировать данные, описанные в разделах 0, 1, 3, 6, 7 и 8 [например, из стандартного 10-секундного ЭКГ в 12 отведений (кодируются I, II, V1, V2, V3, V4, V5, V6)], и делать извлеченную информацию доступной для пользователя (при этом должны быть выполнены требования 6.5.3).
B.2.2.3 Пересылка
Экспорт ранее импортированной записи в том же формате данных, с модификацией или без модификации отдельных разделов. Записи ЭКГ, хранящиеся в форматах, отличных от SCP, могут быть преобразованы в соответствии с форматом SCP-ECG. Данные сигнала ЭКГ, импортированные в формате SCP ЭКГ, не должны искажаться в процессе сжатия для пересылки.
Целью определения пересылки является сохранение компонентов записи (например, раздела, специфичного для производителя), которые импортирующее устройство неспособно обработать. Требование того, чтобы данные ЭКГ не испытывали дополнительные потери при пересылке, подразумевает либо отправку исходных сжатых данных или дополнительное сжатие без потери качества. Редактирование пользователем демографических данных, измерений и интерпретаций, а также сокращение или потери данных по выбору пользователя, не входят в настоящий стандарт.
B.2.2.4 Коммуникационный канал
Любой механизм, способный передать запись SCP-ECG для внешнего доступа.
Примечание - Примером коммуникационного канала может служить RS-232, используемый для передачи сообщений запросов, описанных в приложении D, с использованием транспорта, описанного в приложении E. Настоящий стандарт не запрещает, но и не поддерживает использование какого-либо другого механизма.
B.2.3 Передача сообщений SCP-ECG/транспортный протокол
Если обмен записями ЭКГ между разными устройствами картирования и/или системами выполнен по каналу последовательной передачи данных (прямое подключение по кабелю или через модем), то возможное решение задачи отправки сообщений запросов можно найти в приложении D, а решение транспорта данных - в приложении E. Для устройства должны быть декларированы поддерживаемые технологии коммуникаций (RS-232, Bluetooth, беспроводное соединение, ЛВС и т.д.), а также утверждение, что информация о коммуникационном протоколе отправки сообщений запросов и транспорте данных может быть получена по запросу. Обычно производитель должен раскрыть информацию о механизме или механизмах, с помощью которых можно получить доступ к файлам данных, форматированных в соответствии со стандартом SCP-ECG.
ИС NORMPROD: примечание. В официальном тексте документа, видимо, допущена опечатка: пункт D.2.2.2 в Приложении D отсутствует. |
Если устройство картирования/система поддерживает коммуникационный протокол RS-232, то декларация "поддерживается отправка сообщений запросов" означает, что имеет место соответствие с приложением D, но при этом используется транспортный протокол, который не определен в настоящем стандарте и который производитель должен раскрыть. Декларация "поддерживаются отправка сообщений запросов и транспортный протокол" означает соответствие приложениям D и E. Если устройство не поддерживает все указанные функции, оно будет считаться соответствующим стандарту, если может отвечать на запросы таким образом, как это описано в настоящем стандарте. Например, если "Запрос списка пациентов" (D.2.2.2) не поддерживается, то на такой запрос можно передать ответ "обработка запроса не поддерживается" [D.2.6, 11)]. Устройство, которое не может возвратить ответ на неподдерживаемый запрос или его ответ отличается от указанного в настоящем стандарте, не будет считаться соответствующим стандарту.
Известно, что существуют другие механизмы для передачи файлов в формате SCP-ECG. Настоящий стандарт не запрещает, но и не поддерживает использование каких-либо других механизмов, отличных от отправки сообщений запросов SCP-ECG и транспортного протокола, определенных в приложениях D и E.
Декларация о соответствии стандарту SCP-ECG должна иметь следующую форму и содержание:
Указанное устройство следующим образом соответствует версии стандарта на SCP-ECG x.x: | |
Устройство | Торговая марка производителя Описание модели Идентификатор программного обеспечения реализации SCP-ECG. |
Экспорт | Категория(ии) формата данных или "не поддерживается". Разделы данных с описанием содержания. Список производителей (и устройств) с указанием категорий и дополнительных разделов, для которых было подтверждено соответствие в области возможностей экспорта (тестированием для каждого устройства), или следующее утверждение: "Список производителей (и устройств) с указанием категорий и дополнительных разделов, для которых было подтверждено соответствие в области возможностей экспорта (тестированием для каждого устройства), можно получить по запросу". |
Импорт | Категория(ии) формата данных или "не поддерживается". Разделы данных с описанием содержания. Список производителей (и устройств) с указанием категорий и необязательных разделов, для которых было подтверждено соответствие импорта стандарту (тестированием каждого устройства), или следующая декларация: "Список производителей (и устройств) с указанием категорий и необязательных разделов, для которых было подтверждено соответствие импорта стандарту (тестированием каждого устройства), можно получить по запросу". |
Пересылка данных | "Поддерживается" или "не поддерживается". |
Коммуникационный канал | |
Поддерживаемый коммуникационный протокол: RS-232. Передача: "Сообщения запросов и транспорт данных не поддерживаются", или "Сообщения запросов поддерживаются", или "Сообщения запросов и транспорт данных поддерживаются". Получение: "Сообщения запросов и транспорт данных не поддерживаются", или "Сообщения запросов поддерживаются", или "Сообщения запросов и транспорт данных поддерживаются". Если поддерживаемый коммуникационный протокол отличается от RS-232 или передача и/или получение отличаются от "Сообщения запросов и транспорт данных поддерживаются", то должно быть добавлено следующее предложение: "Информация о коммуникационном протоколе сообщений запросов и транспорта данных может быть получена по запросу" или "Механизм(ы) доступа к файлам данных, форматированных в соответствии со стандартом SCP-ECG, можно получить по запросу". В случае декларации "Сообщения запросов и транспорт данных поддерживаются" для передачи и/или получения должны быть добавлены список производителей (и устройств), для которых подтверждена совместимость с уровнем обмена сообщениями/транспорта SCP (путем тестирования) или следующая декларация: "Список производителей (и устройств), для которых подтверждена совместимость с уровнем обмена сообщениями/транспорта SCP-ECG (путем тестирования), можно получить по запросу". | |
B.2.5 Гипотетические примеры
B.2.5.1 Кардиограф
Декларация о соответствии стандарту SCP-ECG версии 2.x | |
Устройство | MyECG Company Модель Top1 Реализация SCP-ECG MyECG SCP версия 2. |
Экспорт | Категория формата данных II. Разделы данных 0, 1, 2, 3, 4, 5, 6, 7, 8, 10, содержащие демографические данные, данные ритма ЭКГ, эталонные циклы, глобальные измерения, измерения отведений и интерпретацию. Совместимость экспорта для категории II была подтверждена посредством тестирования: - Xzq Manufacturing, Inc. Модели LB1577, LB1755 и ZM922 (SCP-ECG версия 1.3, версия реализации программного обеспечения 6.1); - BestECG, LTD. Модель PQRST2 (SCP-ECG версия 1.3, версия реализации программного обеспечения 3.0). |
Импорт | Категория формата данных I: Разделы данных 0, 1, 2, 3, 6, 7, 8, 10, содержащие демографические данные, данные ритма ЭКГ, глобальные измерения, измерения отведений и интерпретацию. Категория формата данных II: Разделы данных 0, 1, 2, 3, 4, 5, 6, 7, 8, 10, содержащие демографические данные, данные ритма ЭКГ, эталонный цикл, глобальные измерения, измерения отведений и интерпретацию. Список производителей (и устройств) с указанием категорий и необязательных разделов, для которых было подтверждено соответствие импорта стандарту (тестированием каждого устройства) можно получить по запросу. |
B.2.5.2 Система управления
Декларация о соответствии стандарту SCP-ECG версии 2.x | |
Устройство: | MyECG Company Модель Top2 Реализация SCP_ECG версии MyECG SCP версия 2. |
Экспорт | Не поддерживается. |
Импорт: | Категория формата данных I: Разделы данных 0, 1, 2, 3, 6, 7, 8, 10, содержащие демографические данные, данные ритма ЭКГ, глобальные измерения, измерения отведений и интерпретацию. Категория формата данных II: Разделы данных 0, 1, 2, 3, 4, 5, 6, 7, 8, 10, содержащие демографические данные, данные ритма ЭКГ, эталонные циклы, глобальные измерения, измерения отведений и интерпретации. Список производителей (и устройств) с указанием категорий и необязательных разделов, для которых было подтверждено соответствие импорта стандарту (тестированием каждого устройства), можно получить по запросу. |
B.2.5.3 Дефибриллятор, ЭКГ в 12 отведений
Декларация о соответствии стандарту SCP-ECG версия 2.x | |
Устройство: | MyECG Company Модель Top3 Реализация SCP_ЭКГ версии MyECG SCP версия 2. |
Экспорт | Не поддерживается. |
Импорт: | Категория формата данных I: Разделы данных 0, 1, 2, 3, 6, содержащие демографические данные и данные ритма ЭКГ. Совместимость экспорта для категории I была подтверждена посредством тестирования: - Xzq Manufacturing, Inc. Модели LB1577, LB1755 и ZM922 (SCPECG версия 1.3, версия реализации программного обеспечения 6.1); - BestECG, LTD. Модель PQRST2 (SCP-ECG версия 1.3, версия реализации программного обеспечения 3.0). |
B.3.1 Обзор
Тестирование/подтверждение соответствия/совместимости формата данных стандарту SCP-ECG может быть выполнено отдельными производителями. Требования к тестированию/подтверждению соответствия показаны на рисунке B.1 и подробно рассмотрены в B.3.2. Каждый производитель, декларирующий соответствие экспорта, предоставляет публично доступный и бесплатный пример записей в формате SCP-ECG для каждого устройства, генерирующего ЭКГ, и для каждого заявленного уровня формата данных, а также дополнительные обеспечивающие файлы данных, позволяющие импортирующему производителю подтвердить соответствие точного декодирования записей SCP-ECG. Прочитав файлы производителя A, производитель B может подтвердить, что файлы производителя A могут быть импортированы. Если в декларации о соответствии SCP-ECG производитель B заявляет, что совместимость с A в области импорта была подтверждена, то производитель B в письменной форме оповещает об этом производителя A. Затем производитель A может заявить о подтверждении совместимости с B в области экспорта. Тем самым производители совместно подтверждают совместимость друг с другом.
Подтверждение соответствия импорта может быть представлено диаграммой, показанной на рисунке B.1.
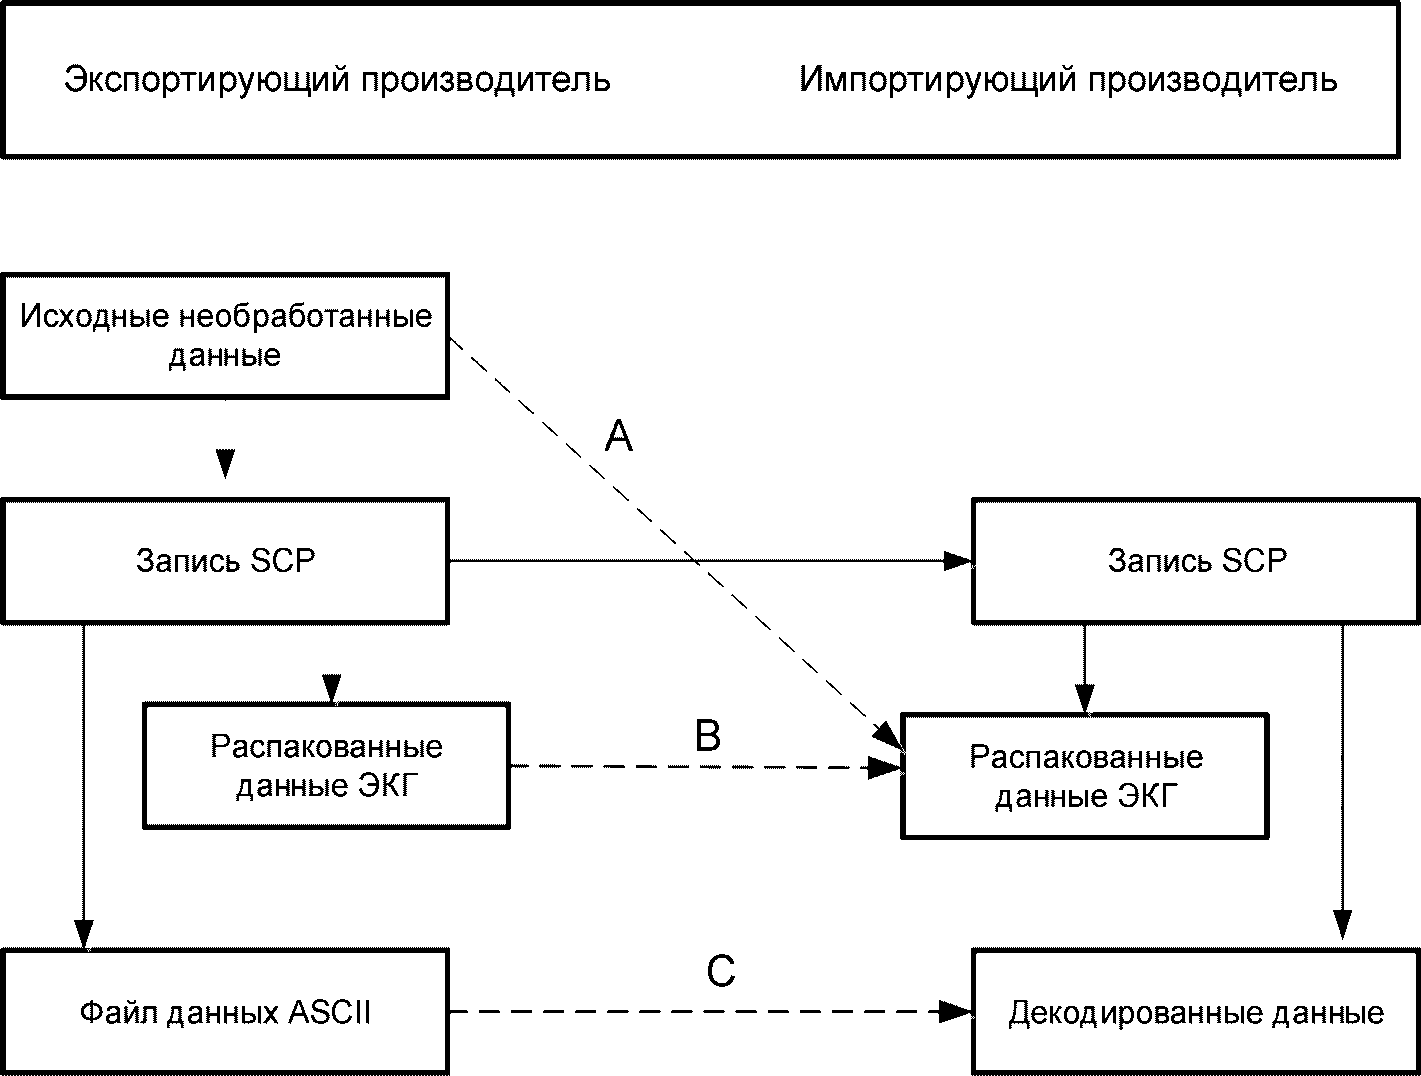
Производитель экспорта должен создать пять типов файлов и сделать их открытыми и общедоступными для каждого предоставленного теста, для каждого типа экспортирующего устройства и для каждого уровня соответствия.
1) двоичный файл в формате SCP-ECG (***.ECG);
2) исходный файл необработанных данных ЭКГ, из которого был получен файл SCP-ECG, в двоичном формате, определенном в B.3.3 (***.EC0);
3) распакованный файл данных ЭКГ из файла SCP-ECG, полученный с помощью процесса распаковки производителя экспорта и имеющий двоичный формат, определенный в B.3.3 (***.EC1);
4) текстовый файл, описанный в B.3.3 и содержащий определения данных в исходном и распакованном двоичных файлах ЭКГ (***.EC2);
5) файл данных ASCII (для данных, не являющихся сигналами), содержащий все демографические данные, измерения и данные интерпретации (***.EC3).
Производитель экспорта должен предоставить тестовые комплекты, состоящие из файлов пяти требуемых типов, как минимум для тех случаев, что указаны в разделе C.5 (и в таблице C.13). Производитель экспорта может также предоставить дополнительные тестовые комплекты, состоящие из файлов требуемых типов. Набор тестовых комплектов, предоставляемых производителем экспорта, должен включать файлы, содержание которых ограничено пределами реализации стандарта производителем экспорта.
Для всех тестовых комплектов, предоставленных производителем экспорта, производитель импорта должен импортировать записи SCP-ECG, а затем подвергнуть их декодированию и распаковке. Для каждого теста распакованные данные ЭКГ должны сравниваться с исходными данными ЭКГ (сравнение "A" на рисунке B.1), а распакованные данные ЭКГ должны соответствовать требованиям к дискретизации и пределам искажений, указанным в 6.5. Сравнение "B" между распакованными данными производителя экспорта и распакованными данными производителя импорта позволяет производителю импорта оценить различия, наблюдаемые в сравнении "A". Сравнение "B" не обязательно.
Для каждого тестового комплекта производитель импорта должен сравнить декодированную демографическую информацию, измерения и данные интерпретации с данными в файле ASCII, предоставленном производителем экспорта (сравнение "C" в диаграмме). Это сравнение должно быть точным для всех полей данных, декодированных производителем импорта.
Производитель может заявить совместимость импорта для каждого устройства производителя и для каждой категории формата данных, которая была подтверждена. Если декларировано соответствие импорта для экспортированных файлов другого производителя, то производитель экспорта должен быть оповещен об этом в письменной форме, и экспортирующий производитель должен иметь возможность декларировать совместимость экспорта между ним и импортирующим производителем.
Каждая тестовая ЭКГ должна быть предоставлена вместе со следующей информацией:
1) текстовый файл (***.EC2), содержащий:
i) описатели данных каждого отведения ЭКГ, разделенные запятой (может быть как больше, так и меньше отведений, чем типичные 8, хранящиеся для ЭКГ в 12 отведениях, снятой в состоянии покоя),
ii) общее число считываний для каждого отведения,
iii) частота считываний (в секунду) или интервал между считываниями (микросекунды),
iv) число нановольт в младшем значащем бите,
2) двоичные файлы (***.EC0, ***EC1) с данными ЭКГ, хранящимися в виде 16-битовых слов со знаком в формате Intel (нижний байт, верхний байт). Последовательность считываний (S1, S2, ..., Sn) для отведений (L1, L2, ..., Lm):
S1L1, S1L2 ... S1Lm, S2L1, S2L2 ... SnL1, SnL2... SnLm
Пример - Приведенный в таблице B.2 пример описывает сигнал, снятый с 8 отведений ЭКГ, идентичный для каждого отведения, с чередующимися считываниями +/- 1,0 мВ на каждое отведение. В данном случае значениям +/- 1000 соответствуют шестнадцатеричные значения 03E8 и FC18.
***.EC2 - Текстовый файл, имеющий следующее содержание:
отведения: I, II, V1, V2, V3, V4, V5, V6;
5000 считываний на отведение; 500 считываний в секунду; 1000 нановольт в младшем значащем бите.
***.EC0 или ***.EC1 - Двоичный файл (в шестнадцатеричном формате для каждого байта).
Таблица B.2
Отведения | ||||||||||
I | II | V1 | V2 | V3 | V4 | V5 | V6 | |||
Байты | 00-0F | E8 03 | E8 03 | E8 03 | E8 03 | E8 03 | E8 03 | E8 03 | E8 03 | Считывание 1 |
10-1F | 18 FC | 18 FC | 18 FC | 18 FC | 18 FC | 18 FC | 18 FC | 18 FC | Считывание 2 | |
20-2F | E8 03 | E8 03 | E8 03 | E8 03 | E8 03 | E8 03 | E8 03 | E8 03 | Считывание 3 | |
30-3F | 18 FC | 18 FC | 18 FC | 18 FC | 18 FC | 18 FC | 18 FC | 18 FC | Считывание 4 | |
40-4F | E8 03 | E8 03 | E8 03 | E8 03 | E8 03 | E8 03 | E8 03 | E8 03 | Считывание 5 | |
50-5F | 18 FC | 18 FC | 18 FC | 18 FC | 18 FC | 18 FC | 18 FC | 18 FC | Считывание 6 | |
В 5.4.5 указано, что байт 16 тега 14 (идентификатор машины снимающего устройства) содержит кодированные категории совместимости. Старшие четыре бита байта 16 должны использоваться для характеристики категории формата данных, а младшие четыре бита того же байта зарезервированы, как это показано в таблице B.3. Хотя конкретное устройство может декларировать множество разных категорий формата данных (B.2.4), старшие четыре бита байта 16 должны указывать категорию формата данных записи, в которую встроен тег.
Таблица B.3
Спецификация 5.4.5, тег 14, байт 16
Спецификация 5.4.5, тег 14, байт 16: | Старшие 4 бита: категория формата данных SCP-ЭКГ (I или II) | Зарезервировано | |||||||
бит | 7 | 6 | 5 | 4 | 3 | 2 | 1 | 0 | |
Старшие 4 бита | Категория I: | 1 | 1 | 0 | 1 | ||||
Совместимость содержания данных | Категория II: | 1 | 1 | 1 | 0 | ||||
Младшие 4 бита: зарезервированы | 0 | 0 | 0 | 0 | |||||
(обязательное)
МЕТОДА СЖАТИЯ СИГНАЛА ЭЛЕКТРОКАРДИОГРАММЫ
C.1 Общие положения
В настоящем приложении представлен общий подход к рекомендуемым методам сжатия данных сигнала SCP-ECG. Принципы методологии сжатия вначале представлены в форме различных диаграмм (раздел C.2). Затем приводится более детальное описание рекомендуемой методологии сжатия и распаковки данных вместе с соответствующими математическими определениями (см. разделы C.3 и C.4). В заключение приведено описание набора тестов для испытания соответствия (см. раздел C.5).
Для оценки ошибок распаковки при применении данных методов сжатия ЭКГ, а также для тестирования абсолютной точности реализации сжатия был разработан общедоступный набор тестов. Он полезен для подтверждения соответствия и тестирования производительности.
a) Выделить опорные точки во всех комплексах ЭКГ, например, время QRSmax или какой-либо иной маркер:
- опорные точки для вычитания эталонного цикла (см. fc1 - fc7 на рисунке C.1).
b) Идентифицировать типы комплексов ЭКГ, например нормальный тип, различные экстрасистолы:
- QRS-тип 0, 1 и т.д.
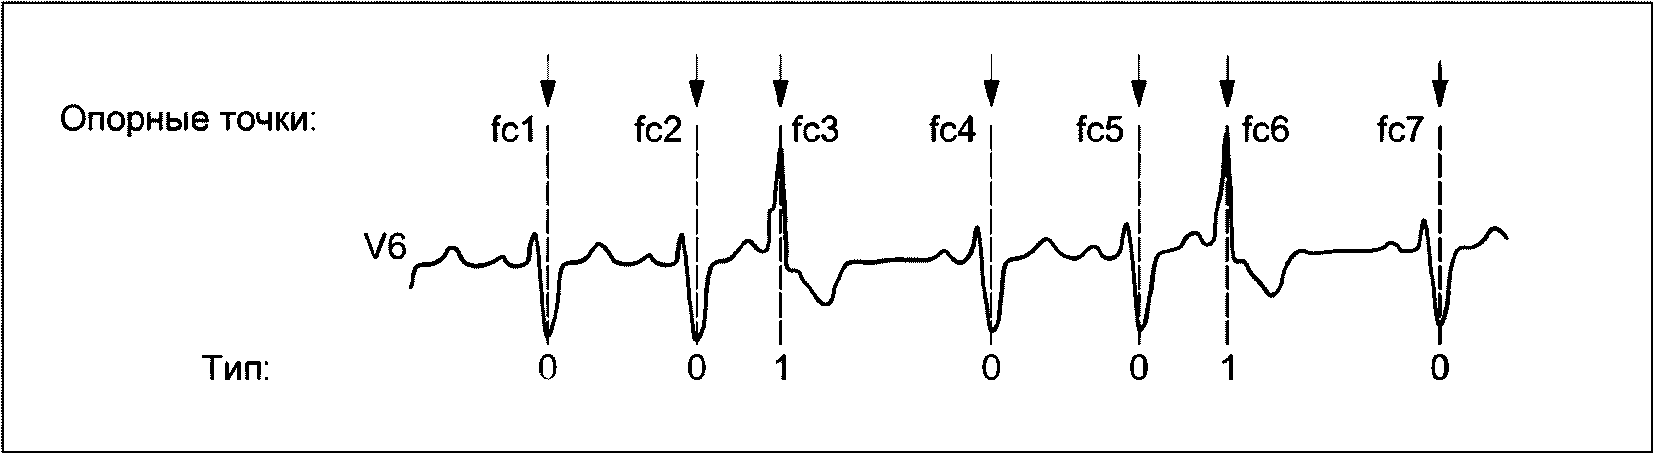
Рисунок C.1 - Пример необработанных данных,
опорных точек и типизации QRS
C.2.2 Эталонный цикл 0
a) Вычислить "Эталонный цикл типа 0", например, репрезентативный усредненный цикл, медианный цикл, модальный цикл.
b) Идентифицировать точки начала и завершения зубцов эталонного цикла 0 (см. рисунок C.2):
- длина вычитаемого эталонного цикла 0;
- указатели на сегменты данных QRS (см. рисунки C.3 и C.4), которые должны быть защищены от фильтрации и прореживания.
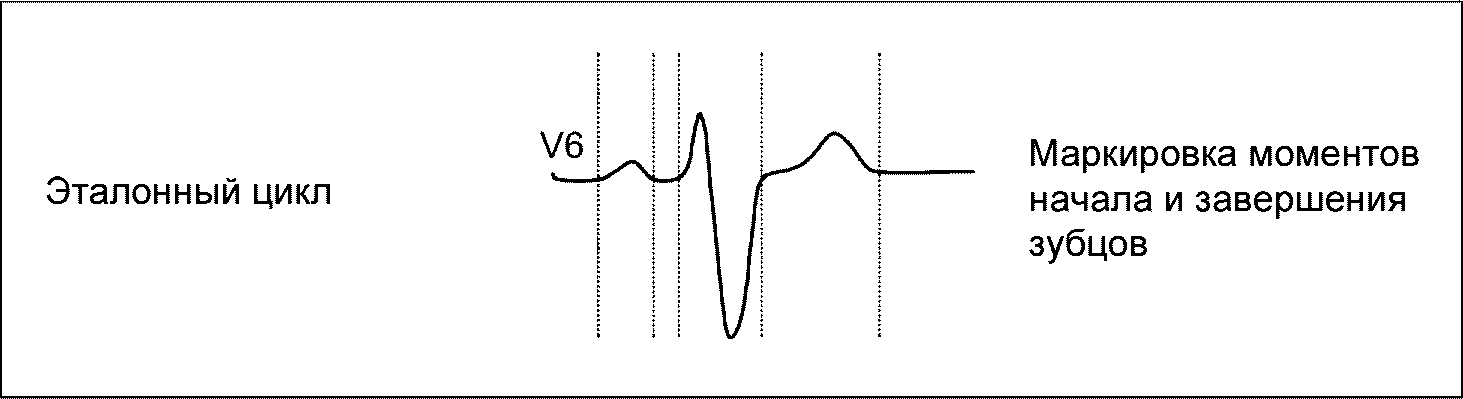
C.2.3 Остаточная запись
Вычесть эталонный цикл типа 0 из всех комплексов ЭКГ типа 0, используя опорные точки (см. рисунок C.3).
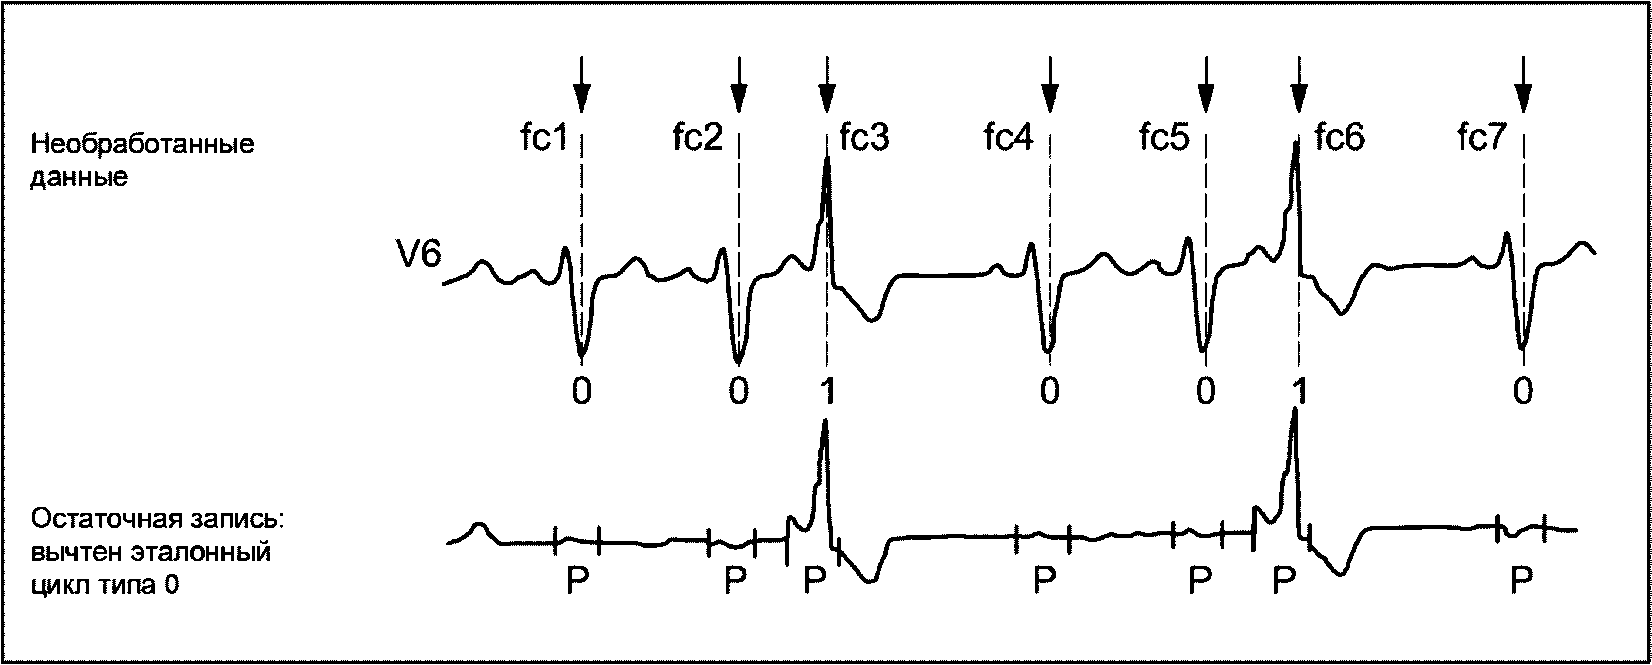
C.2.4 Сжатые данные
a) Низкочастотная фильтрация остаточной записи (исключая защищенные области p).
b) Прореживание считываний от 2 до 8 мс (исключая защищенные области p).
c) Вычисление последовательных разностей второго порядка для всех результирующих данных (см. рисунок C.4).
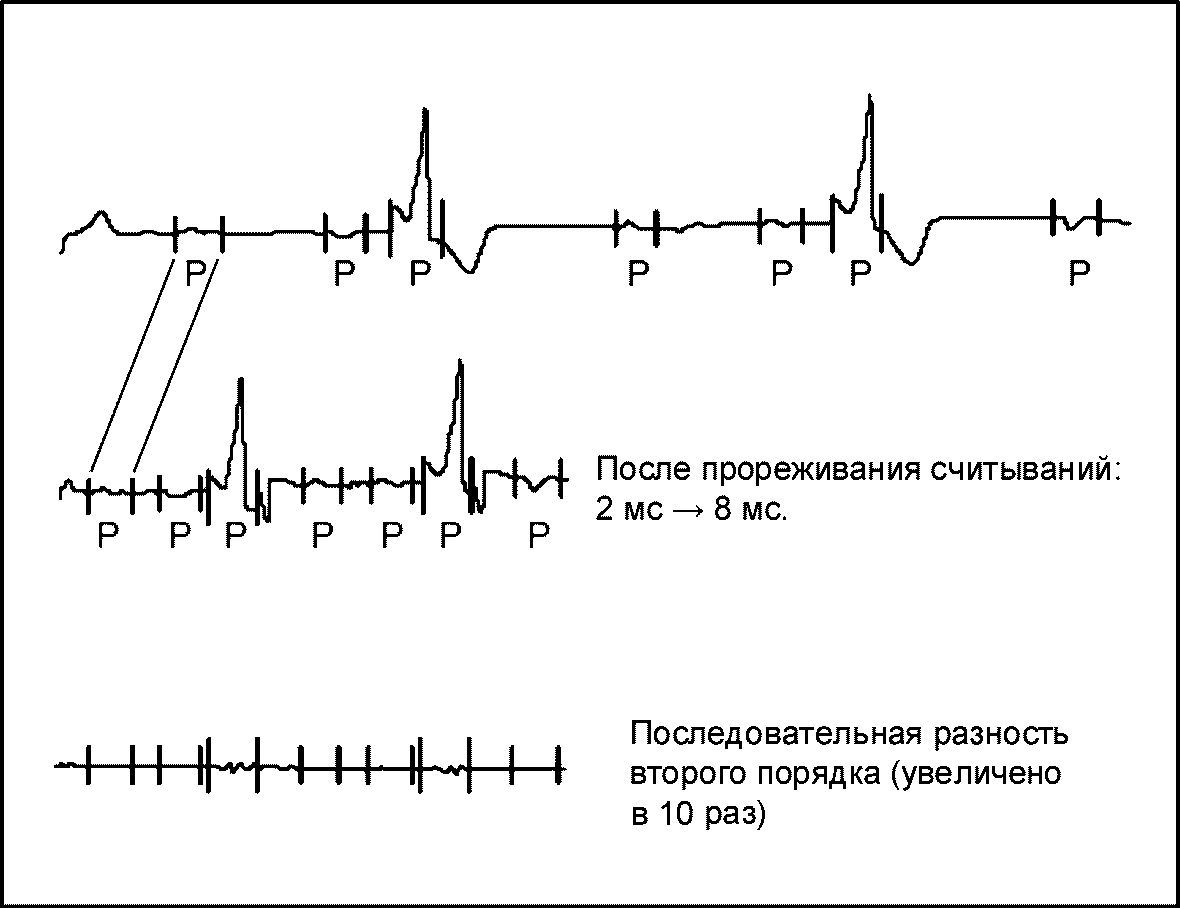
C.2.5 Кодирование
Далее последовательные разности второго порядка кодируются методом Хаффмана, см. численные примеры.
Для распаковки данных ЭКГ, как правило, выполняются в обратном порядке шаги, применяемые для сжатия. Если используется "высокое сжатие", то для остаточной записи и репрезентативного цикла 0 должны выполняться шаги (a) и (b), описанные ниже. Шаги (c) и (d) применимы только к остаточной записи, в то время как (e) и (f) применимы и к репрезентативному циклу 0, и к остаточной записи.
Ниже приведены шаги распаковки:
a) декодирование с применением таблиц Хаффмана;
b) воссоздание данных из разностей первого или второго порядка;
c) воссоздание прореженных считываний;
d) низкочастотная фильтрация воссозданной остаточной записи за пределами защищенных областей;
e) умножение на AVM (модификатор значения амплитуды);
f) в случае высокого сжатия: сложение эталонного цикла 0 с остаточной записью во всех местах комплекса типа 0. Для этого должны использоваться хранящиеся указатели fc(k), SB(k) и SE(k) остаточной записи и fcM эталонного цикла 0.
C.3.1 Определения
C.3.1.1 Необработанные данные
Элементы необработанных данных: Xr(m, n)
Нижний индекс r: необработанные данные
Отведение: m; 1 <= m <= M
Считывание: n; 1 <= n <= N
Дискретизация амплитуды: LSB [мкВ] = AVM·10-3
(AVM, множитель значения амплитуды, указанный в разделе 6, байты заголовка 1, 2.)
Интервал между считываниями: Sl [мс] = STM·10-3
(STM, множитель времени считываний, указанный в разделе 6, байты заголовка 3, 4.)
C.3.1.2 Связь номера и времени считывания
a) По определению: первое считывание (n = 1) выполняется в момент t = 0.
b) Интервал между считываниями (SI) 2 мс указан как минимальное требование для данных, совместимых с SCP-ECG.
c) При SI = 2 мс связь между считыванием n и временем t записи имеет вид
t = (n - 1)·S/[мс] = 2(n - 1)[мс].
C.3.1.3 Примеры деноминации и индексирования данных ЭКГ
C.3.1.3.1 Необработанные данные
Отведения I, II, V1, ...,  .
.Длина записи 10 с, интервал между считываниями 2 мс.
Число считываний 
Отведение I: | Xr(1, 1), Xr(1, 2), ..., Xr(1, n), ..., Xr(1, 5000) |
Отведение II: | Xr(2, 1), Xr(2, 2), ..., Xr(2, n), ..., Xr(2, 5000) |
Отведение V1: | Xr(3, 1), Xr(3, 2), ..., Xr(3, n), ..., Xr(3, 5000) |
Отведение V6: | Xr(8, 1), Xr(8, 2), ..., Xr(8, n), .., Xr(8, 5000) |
C.3.1.3.2 Эталонный цикл
Отведения I, II, V1, ...,  .
.Длина записи 1 с, интервал между считываниями 2 мс.
Число считываний 
Отведение I: | Yr(1, 1), Yr(1, 2), ..., Yr(1, n), ..., Yr(1, 5000) |
Отведение II: | Yr(2, 1), Yr(2, 2), ..., Yr(2, n), ..., Yr(2, 5000) |
Отведение V1: | Yr(3, 1), Yr(3, 2), ..., Yr(3, n), ..., Yr(3, 5000) |
Отведение V6: | Yr(8, 1), Yr(8, 2), ..., Yr(8, n), ..., Yr(8, 5000) |
Примечание - Данные (потенциалы B) для отведений III, aVR, aVL и aVF могут быть вычислены по формуле Эйнтховена и Голдберга, согласно которой:
III = I - I = VF - VL, | 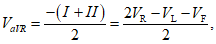 |
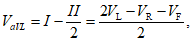 | 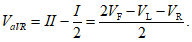 |
C.3.1.4 Указатели
C.3.1.4.1 Необработанные данные
Указатель на опорную точку цикла k в необработанных данных (число комплексов QRS в необработанных данных: K): fc(k).
C.3.1.4.2 Эталонный цикл
Указатель на опорную точку в данных эталонного цикла (опорной точкой может быть пространственный максимум, начало QRS-комплекса или любая другая точка QRS-комплекса): | fcM. |
Указатель на начало зубца P в данных эталонного цикла: | PBM. |
Указатель на завершение зубца P в данных эталонного цикла: | PEM. |
Указатель на начало QRS-комплекса в данных эталонного цикла: | QBM. |
Указатель на окончание QRS-комплекса в данных эталонного цикла: | QEM. |
Указатель на окончание зубца T в данных эталонного цикла: | TEM. |
C.3.1.4.3 Остаточная запись
Указатель на начало вычитания эталонного цикла 0 для цикла k в необработанных данных: | SB(k). |
Указатель на окончание вычитания эталонного цикла 0 для цикла k в необработанных данных: | SE(k). |
Указатель на начало защищенной области комплекса k в необработанных данных и в остаточных данных: | QB(k). |
Указатель на завершение защищенной области комплекса k в необработанных данных и в остаточных данных: | QE(k). |
Примечание - Указатели QB(k), QE(k) явно хранятся в записи SCP-ECG, раздел 4 (см. 5.7.5). Защищенная область включает в себя интервал от начала до завершения QRS-комплекса, но он может превышать его (например, из-за границ прореженных N-считываний, см. C.3.4.2). Начало и завершение QRS-комплекса могут быть вычислены по значению опорной точки fcM эталонного цикла 0, длительности его QRS-комплекса и интервалов bM и eM (см. C.3.3.1), а также по значениям опорных точек fc(k) для каждого цикла.
QRSonset(k) = fc(k) - bM,
QRSoffset(k) = fc(k) - eM,
где QRSonset - начало комплекса QRS, а QRSoffset - его завершение.
C.3.2 Огрубление всех значений до разрешения 5 мкВ
C.3.2.1 Общие положения
При дискретизации амплитуды (разрешение, точность) необработанных данных и данных эталонного цикла младший значащий бит (LSB) должен иметь значение <= 5 мкВ. Следующие уравнения описывают огрубление данных до 5 мкВ/LSB в предположении, что исходные данные записываются с разрешением 1 мкВ/LSB.
Примечания
1 Не все компиляторы одинаково обрабатывают округление и огрубление. При разработке программы, выполняющей сжатие, необходимо обеспечить правильное выполнение округления положительных и отрицательных чисел. Например, в процессорах Intel огрубление всегда направлено к нулю, т.е. -9/5 = -1,8 огрубляется до -1. Напротив, при вычислениях со смещением двоичного числа результат огрубления будет эквивалентен -2.
2 Индекс t: огрубленные данные.
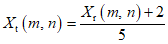 для Xr (m, n) >= 0,
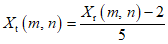 для Xr (m, n) < 0.
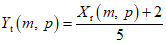 для Yr (m, p) >= 0,
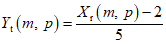 для Yr (m, p) < 0.
C.3.3 Вычитание эталонного цикла из необработанных данных сигнала
Протокол SCP-ECG спроектирован для обработки данных сигнала ЭКГ, которые могут подвергаться сжатию и кодированию различными методами:
a) только сокращение избыточности;
b) "высокое сжатие" при помощи "эталонного цикла 0", кодируемого отдельно; он может быть вычтен из необработанных данных и остаточные данные могут быть отфильтрованы, считывания прорежены и т.д.
Далее подробно описаны вычисление и спецификация остаточной записи в случае, когда применяется метод b), описанный выше как схема "высокого сжатия".
C.3.3.2 Огрубленные необработанные данные
Пусть имеются огрубленные необработанные данные отведения V6 с выделенными комплексами ЭКГ (опорные точки fck), показанные на рисунке C.5.
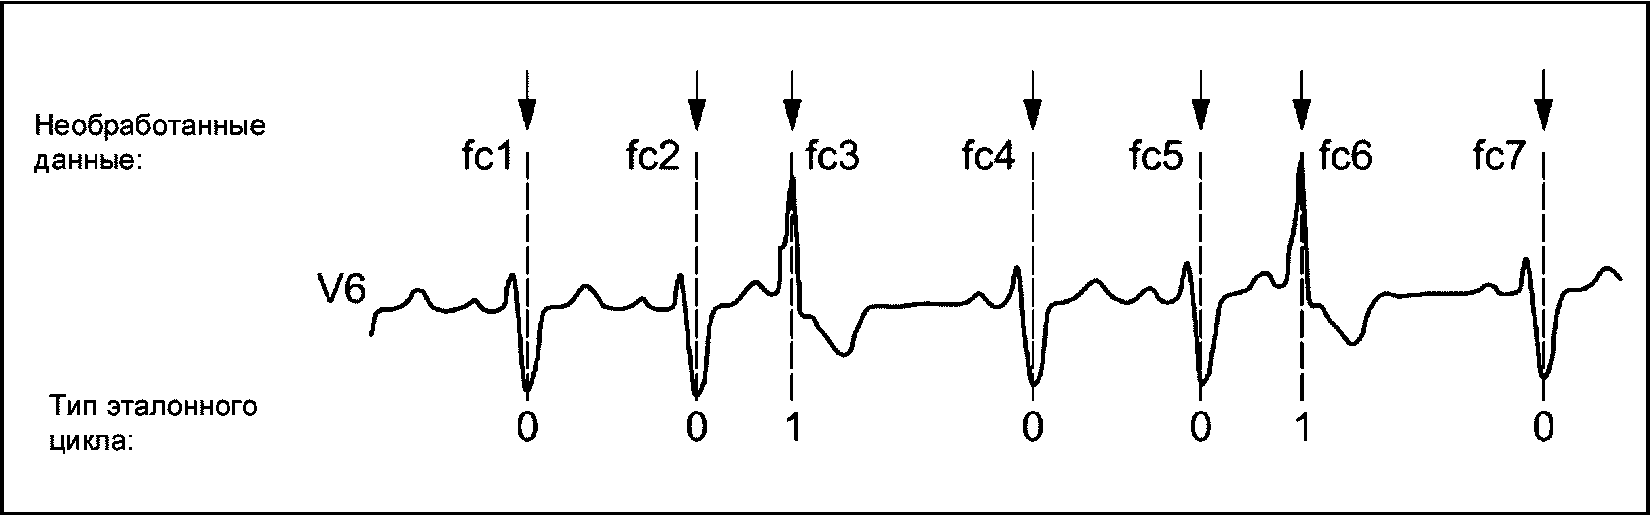
Рисунок C.5 - Пример необработанных данных
и опорных точек с указанием типов QRS
В таблице C.1 приведены местоположения и типы комплексов QRS, выделенных в необработанных данных, показанных на рисунке C.5 в диапазоне от t = 0 до t = 5 с (считывания от 1 до 2500).
Таблица C.1
Местоположения и типы комплексов QRS
Считывание | Указатель | Тип QRS | Данные |
1 | Xt(m, 1) | ||
2 | Xt(m, 2) | ||
333 | fc1 | 0 | Xt(m, 333) |
675 | fc2 | 0 | Xt(m, 675) |
840 | fc3 | 1 | Xt(m, 840) |
1357 | fc4 | 0 | Xt(m, 1357) |
1702 | fc5 | 0 | Xt(m, 1702) |
1869 | fc6 | 1 | Xt(m, 1869) |
2373 | fc7 | 0 | Xt(m, 2373) |
5000 | Xt(m, 5000) |
C.3.3.3 Вычисление остаточных данных
C.3.3.3.1 Совместите ("синхронизируйте") опорную точку fcM данных эталонного цикла 0 с каждой из опорных точек fc1, fc2, ..., fc(k) комплексов необработанных данных цикла типа 0. См. рисунок C.6.
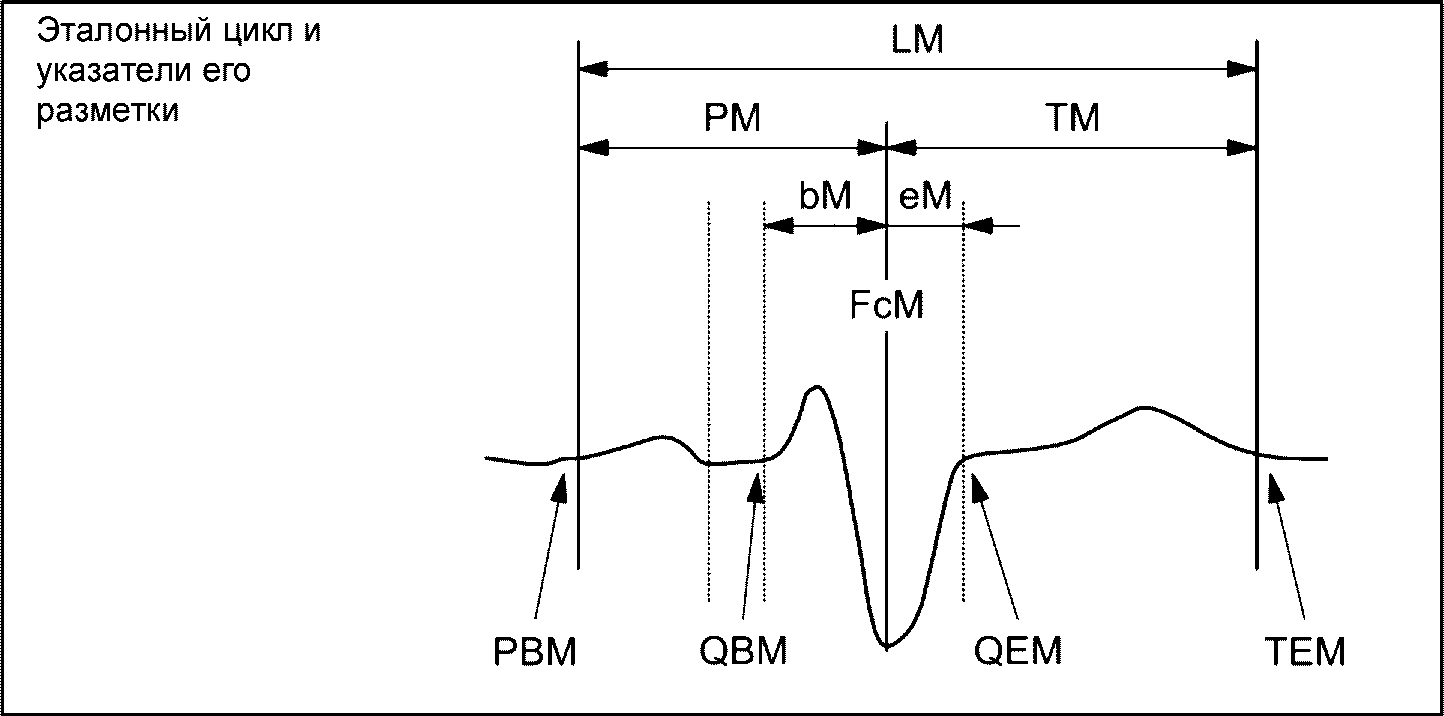
Рисунок C.6 - Пример эталонного цикла
и указателей его разметки
В таблице C.2 представлены непосредственные места размещения указателей и формула для их вычисления по данным записи SCP-ECG.
Таблица C.2
Непосредственные места размещения указателей
Указатель | Подраздел | Раздел | Байт | Непосредственное хранение | Вычисление |
LM | 7 | Нет | TEM-PBM | ||
PM | 4, 7 | Нет | fcM-PBM | ||
TM | 4, 7 | Нет | TEM-fcM | ||
BM | 4, 7 | Нет | fcM-QBM | ||
EM | 4, 7 | Нет | QEM-fcM | ||
FcM | 4 | 3, 4 | Да | ||
PBM | 7 | 1, 2 | Да | ||
PEM | 7 | 3, 4 | Да | ||
QBM | 7 | 5, 6 | Да | ||
QEM | 7 | 7, 8 | Да | ||
TEM | 7 | 9, 10 | Да |
C.3.3.3.2 Вычитание каждого считывания данных эталонного цикла из необработанных данных в соответствующем месте цикла fc(k).
Примечание - Длина сегмента данных, который необходимо вычесть, не обязательно является полной длиной LM эталонного цикла. К тому же в необработанных данных она может изменяться от цикла к циклу. Чтобы это учесть, в разделе 4 протокола SCP-ECG (см. 5.7.4) байты с 3 по 6 зарезервированы для хранения указателей начала вычитания данных эталонного цикла. Байты с 11 по 14 зарезервированы для хранения конца вычитания данных эталонного цикла для каждого цикла соответственно.
C.3.3.3.3 Из практических соображений удобнее всего постоянно вычитать данные "полного" эталонного цикла от PBM до TEM (данный сегмент имеет длину LM). Указатели на начало и конец вычитания данных эталонного цикла для цикла k вычисляются по следующим формулам:
SB(k) = fc(k) - PM,
SE(k) = fc(k) - TM.
Эти указатели должны использоваться во время процедуры вычитания и должны храниться в поле данных QRS, описанном в разделе 4.
Примечание - Вычитание эталонного цикла ("нормального" типа 0) не является эффективным, если цикл необработанных данных имеет другой тип, например, является экстрасистолой (тип 1). Тем не менее сегменты данных QRS экстрасистол также должны быть защищены от низкочастотной фильтрации и прореживания считываний.
C.3.3.3.4 Данные, остающиеся после вычитания эталонного цикла во всех подходящих местах комплекса fc(k), называются остаточной записью.
C.3.4 Низкочастотная фильтрация
C.3.4.1 Низкочастотная фильтрация остаточной записи эффективно повышает коэффициент сжатия. Так как высокочастотные компоненты, как правило, можно встретить только в QRS, все сегменты данных за исключением тех, где были размещены комплексы QRS, могут быть отфильтрованы и подвергнуты прореживанию считываний.
QB(k) = ORSonset(k) - eB(k),
QE(k) = ORSoffset(k) + eE(k).
Если глобальные измерения эталонного цикла (см. 5.10.4) представлены для типа цикла k, то указатели на QRSonset и QRSoffset вычисляются следующим образом:
ИС NORMPROD: примечание. Текст дан в соответствии с официальным текстом документа. |
ORSonset(k) = fc(k) - bM,
ORSonset(k) = fc(k) - eM,
где bM обозначает интервал от опорной точки fcM до начала QRS эталонного цикла, а eM - это интервал от fcM до завершения QRS. Значения bM и eM могут быть вычислены по местоположению опорной точки эталонного цикла (хранится в байтах 3, 4 раздела 4, см. 5.7.3) и указателей на начало и завершение QRS (хранятся в байтах 5, 6, 7, 8 раздела 7, см. 5.10.4).
Значения eB(k) и eE(k) в уравнениях являются поправками к сегменту защищенных данных, предотвращающими проблемы, связанные с прореживанием/восстановлением считываний. Практическим решением является определение таких границ QB и QE, чтобы интервал прореживания считываний между циклом k - 1 и циклом k[= QB(k) - QE(k - 1) - 1] являлся бы кратным интервалу считываний остаточной записи.
Таким образом, QB(k) может быть сокращен на значение eB(k) (от 0 до коэффициента снижения частоты - 1), чтобы учесть потребность в сохранении кратности предшествующего незащищенного интервала коэффициенту снижения частоты. Более того, указатель QE(k) последнего комплекса может быть увеличен на значение eE(k) (от 0 до коэффициента снижения частоты - 1), чтобы учесть необходимость в сохранении кратности последнего незащищенного интервала коэффициенту снижения частоты. Опорные точки eB(k) или eE(k) могут дополнительно быть уменьшены или увеличены на значения, кратные коэффициенту снижения частоты, чтобы обеспечить "запас надежности" от возможных ошибок в местах начала и завершения QRS.
C.3.4.3 Простой нерекурсивный фильтр, работающий по принципу "скользящего среднего", дает приемлемые результаты низкочастотной фильтрации остаточной записи. Длина фильтра L составляет 9 считываний.
Для нечетной длины фильтра L фильтруемые значения вычисляются следующим образом:
F(m, a) = X(m, a);
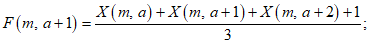
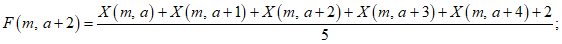
F(m, a + 3) = ...;
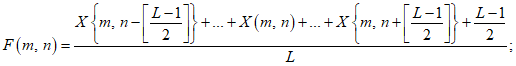
X(m, b - 3) = ...;
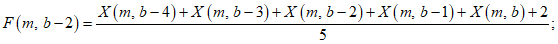
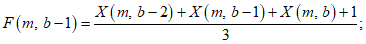
F(m, b) = X(m, b).
Примечание - Методы округления определены в C.3.2.2 и C.3.2.3. Константы округления 1, 2, ..., (L - 1)/2 в следующих уравнениях фильтра должны быть отрицательными, если фильтруемые значения отрицательны.
После вычитания эталонного цикла типа 0 могут потребоваться дополнительные отступы в остаточных данных на границах зон вычитания SB(k) и SE(k). Эти отступы не должны фильтроваться, чтобы их можно было воспроизвести в восстановленных остаточных данных.
Существует три интервала фильтрации, a и b для каждого комплекса k и один дополнительный от конца комплекса K до конца потока данных.
1) От конца вычитания эталонного цикла типа 0 из предшествующего комплекса (k - 1) до начала вычитания из текущего комплекса k.
a = SE(k - 1) + 1, SE(0) = 0,
b = SB(k) - 1.
2) От начала вычитания эталонного цикла типа 0 из текущего комплекса k до начала QRS текущего комплекса k:
a = SB(k),
b = SB(k - 1).
3) От начала QRS текущего комплекса k до конца вычитания эталонного цикла типа 0 из текущего комплекса k.
a = QE(k) + 1,
b = SE(k).
4) Интервал фильтрации для остающихся считываний до конца данных:
a = SE(K)+ 1,
b = N,
где m - номер отведения;
n - номер считывания;
K - число комплексов QRS;
N - номер последнего считывания;
k - номер комплекса QRS;
указатель на начало вычитания эталонного цикла типа 0 для цикла (k) в необработанных данных: | SB(k); |
указатель на конец вычитания эталонного цикла типа 0 для цикла (k) в необработанных данных: | SE(k); |
указатель на начало защищенной области комплекса (k) в необработанных и в остаточных данных: | QB(k); |
указатель на конец защищенной области комплекса (k) в необработанных и в остаточных данных: | QE(k). |
C.3.5 Прореживание считываний
К "медленно изменяющимся" данным наряду с низкочастотной фильтрацией может быть применено прореживание считываний. Для остаточной записи протокол SCP-ECG определяет минимальную частоту считываний - 125 считываний/с, что равносильно интервалу между считываниями 8 мс.
Прореживание считываний разрешается только за пределами защищенных сегментов данных QRS. В SCP прореживание считываний именуется "бимодальным сжатием".
Для прореживания считываний применяется усредняющий алгоритм. Он отличается от прореживания считываний с последующим усреднением четырех считываний.
Для реализации SCP-ECG производители могут выбрать метод прореживания считываний, а именно усреднение или пропуск считываний. Следует отметить, что лучшие результаты получаются, если алгоритмы сжатия и распаковки согласованы между собой.
Хотя настоящий стандарт не требует никакого конкретного метода прореживания и восстановления, на границах зон вычитания в процессе восстановления могут возникнуть переходные эффекты, если не были выполнены определенные требования. Поэтому SCP-ECG рекомендует использовать следующие границы вычитания эталонного цикла типа 0:
- поместить SB(k) в начале интервала прореженных считываний (например, считывания 1, 5, 9, 13, 17, 21, ...);
- поместить SE(k) в конце интервала прореженных считываний (например, считывания 4, 8, 12, 16, 20, ...).
Если эти условия выполнены, то нет необходимости знать, какой алгоритм прореживания используется во избежание переходных состояний на границах зон вычитания во время восстановления.
Интервал считываний 8 мс является максимальным разрешенным для остаточной записи в SCP-ECG. Поэтому наименьшая эффективная частота считываний для остаточной записи составляет 125 считываний/с. Признак бимодального сжатия указан в 5.9.3, байт 6.
Чтобы избежать проблем восстановления при прореживании считываний, практическим решением является задание таких границ QB и QE, при которых интервал прореживания считываний между циклом k - 1 и циклом k(= QB(k) - QE(k - 1) - 1) является кратным интервалу между считываниями в остаточной записи.
В обновлении указателей начала и конца защищенной области после прореживания считываний нет необходимости, так как они находятся внутри остаточной записи, а не в остаточной записи, прореженной считываниями (см. спецификацию раздела 4 в 5.7).
Не существует никакого универсального алгоритма для восстановления прореженных считываний. Выбор способа выполнения восстановления (интерполяция или повторение считываний) оставлен на усмотрение производителей. Однако среднеквадратичная ошибка и абсолютные отклонения восстановления между исходной и распакованной ЭКГ должны быть проверяемыми на тестовом наборе SCP-ECG. Этот тестовый набор описан в C.5.
Пример фильтрации и прореживания остаточной записи, получаемой из данных ЭКГ, представлены в таблице C.3.
Таблица C.3
Пример фильтрации и прореживания
Номер считывания | Указатель | Защищенный сегмент | Отфильтрованные данные | Прореженные данные | Комментарий |
1 | Нет | Да | Да | ||
2 | Нет | Да | Да | ||
3 | Нет | Да | Да | ||
178 | SB1 | Нет | Да | Да | Начало P1 |
264 | Нет | Да | Да | ||
265 | QB1 | Да | Нет | Нет | Начало защищенной области, первый QRS |
267 | QRSonsetl | Да | Нет | Нет | Начало QRS, первый QRS |
333 | fc1 | Да | Нет | Нет | Опорная точка, первый QRS |
361 | QE1 = QRSoffset1 | Да | Нет | Нет | Конец защищенной области и завершение QRS, первый QRS |
362 | Нет | Да | Да | ||
495 | SE1 | Нет | Да | Да | Завершение T1 |
520 | SB2 | Нет | Да | Да | Начало P2 |
605 | Нет | Да | Да | ||
606 | QB2 | Да | Нет | Нет | Начало защищенной области, второй QRS |
609 | QRSonset2 | Да | Нет | Нет | Начало QRS, второй QRS |
675 | fc2 | Да | Нет | Нет | Опорная точка, второй QRS |
Примечание - QB2 не равно QRSonset2, так как в этом случае разность для прореживания считываний (= QB2 - QE1 - 1) была бы равна 609 - 361 - 1 = 247 считываний, что не кратно коэффициенту прореживания считываний, равному 4. Подходящим для QB2 является считывание 606, так как 606 - 361 - 1 = 244 считывания, что кратно этому коэффициенту.
C.3.6 Вычисление и хранение разностных данных
C.3.6.1 Общие положения
Чтобы воспользоваться взаимосвязью считываний, вместо "исходных" значений эталонного цикла и данных остаточной записи можно хранить и кодировать последовательные разности первого или второго порядка соответствующих данных. Как правило, длина слова (в битах) исходных считываний гораздо больше, чем длина последовательных разностей первого или второго порядка.
Протокол SCP-ECG оставляет за пользователем выбор того, хранить/передавать разности первого или второго порядка (или даже исходные данные) или нет. Это должно быть указано в байте 5 заголовка раздела 5 (для данных эталонного цикла) и раздела 6 (для остаточных данных) соответственно.
C.3.6.2 Вычисление последовательных разностей первого и второго порядков
Предполагается, что из остаточной записи, полученной из записи необработанных данных с N считывания, в прореженной записи остаются Q считываний.
Эти считывания обозначаются следующим образом для отведения m:
Z(m, 1), Z(m, 2), ..., Z(m, q), ..., Z(m, Q).
Затем вычисляются разности следующим образом:
Разности первого порядка:
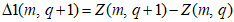 ; q = 1, ..., (Q - 1).
Примечание - 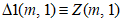 , где
 означает "определен как".
, где означает "определен как".Разности второго порядка:
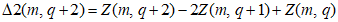 ; q = 1, ..., (Q - 2).
Примечание - 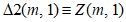 ,
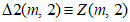 .
, .Подобным же образом разности первого и/или второго порядка для эталонного цикла могут быть вычислены для данных эталонного цикла Yt(m, p).
C.3.6.3 Восстановление данных из разностей
Восстановление данных из разностей требует хранения/передачи одного (первого) исходного значения, поскольку
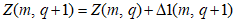 ; q = 1, ..., (Q - 1),
где Z(m, 1) необходимо для восстановления Z(m, 2):
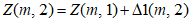 .
Примечание - 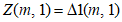 .
.Восстановление данных из разностей второго порядка требует хранения и передачи двух исходных значений:
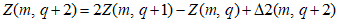 ; q = 1, ..., (Q - 2),
где Z(m, 1) и Z(m, 2) являются обязательными значениями для восстановления Z(m, 3),
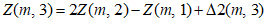 .
Примечание - 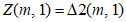 ,
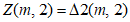 .
, .Соответствующие исходные значения должны храниться в начале кодированных данных (см. 5.8.3).
C.3.7 Кодирование записи SCP-ECG методом Хаффмана
C.3.7.1 Общие положения
Кодирование методом Хаффмана обеспечивает минимальную избыточность кодирования данных с неодинаковой вероятностью возникновения. Применяется схема кодирования, в которой наиболее часто возникающим значениям назначается самая короткая длина битового кода. А наиболее редко возникающим данным присваивается наибольшая длина битового кода. Кодирование Хаффмана заменяет данные, представленные словами, на данные, представленные битами.
С помощью таблиц Хаффмана, представленных в протоколе SCP-ECG, можно использовать полное кодирование методом Хаффмана и исходное кодирование. Если распределение длин слов в данных меняется, то можно использовать более одной таблицы Хаффмана, а также переключать разные таблицы во время кодирования в целях более эффективного сжатия.
C.3.7.2 Полное кодирование Хаффмана
При полном кодировании Хаффмана одно слово данных представляется в таблице Хаффмана "полным кодом", который хранится как "базовый код" или "префикс". Префикс должен использоваться для кодирования, а для декодирования должно использоваться базовое значение, взятое из таблицы. Длина полного кода в битах после кодирования равна длине префикса.
Пример - В таблице Хаффмана N 1 (см. таблицу C.4) код значения "0" равен 0b в префиксе. Вся длина кода составляет 1 бит, что равносильно длине префикса. Для значения "1" префикс равен 100b, а длина битового кода равна 3, т.е. длине префикса.
C.3.7.3 Исходное кодирование
Если значение не содержится в таблице Хаффмана, то оно должно иметь исходный код. Базовое значение в этом случае не содержит никакого приемлемого или полезного значения (должно быть "0"). Но таблица содержит информацию о числе битов "остатка" в потоке битов, который следует за префиксом. Из этого остатка должно вычисляться восстанавливаемое слово данных. Число этих битов равно разности между числом битов всего случая и префикса.
Пример - Битовый поток: 1110000000101b.
1) Сравнение битового потока с таблицей Хаффмана N 1 (см. таблицу C.4) указывает на структуру 6 для декодирования. Поэтому используются первые 4 бита, которые служат переключателем на таблицу Хаффмана N 2.
2) Для декодирования должен использоваться метод исходного кодирования, так как в таблице N 2 число битов префикса 1 (префикс 0b) меньше длины всего кода (9 битов - 1 бит = 8 битов > 0).
3) Длина остатка равна разности между числом битов всего кода и префикса. В данном случае это 8 битов (00000101b), используемых для восстановления слова данных.
4) Чтобы завершить слово данных (2 байта), недостающие биты должны быть заполнены значением старшего значащего бита остатка.
Пример - Восстановленное слово данных: 0000000000000101b = 5h.
C.3.7.4 Таблицы Хаффмана, используемые в SCP-ECG
C.3.7.4.1 Общие положения
Таблицы C.4 и C.5 используются в примерах кодирования данных ЭКГ.
C.3.7.4.2 Структура таблиц Хаффмана
Таблица Хаффмана N 1 содержит семь структур. Из них пять структур используются для полного кодирования Хаффмана, одна - для 8-битового исходного кодирования и одна - для смены таблицы на таблицу N 2. Значения не более 2 кодируются с помощью полного кодирования Хаффмана. Значения более 2 кодируются с помощью исходного кодирования. В этом случае первые 4 бита из 12 битов полного кода являются префиксом (1111b). Следующие 8 битов являются остатком.
Если третий байт (переключатель таблиц) структуры (в данном случае номер 6) равен 0, то это указывает, что текущую таблицу Хаффмана необходимо сменить на таблицу, номер которой указан в базовом значении. В данном случае префикс смены таблиц равен 1110b, а номер новой таблицы равен 2.
Таблица C.4
Номер кодовой структуры | Число битов | Режим таблицы | Базовое значение | Код префикса (в битах) | |
Полный код | Префикс | ||||
1 | 1 | 1 | 0 | 0 | |
2 | 3 | 3 | 1 | 100 | |
3 | 3 | 3 | -1 | 101 | |
4 | 4 | 4 | 2 | 1100 | |
5 | 4 | 4 | -2 | 1101 | |
6 | 4 | 4 | 0 | 2 (перейти к таблице N 2) | 1110 |
7 | 12 | 4 | 1 | Запись отсутствует (0), 8-битовый оригинал | 1111 |
Таблица Хаффмана N 2 содержит пять структур. Из них три структуры используются для полного кодирования Хаффмана, одна - для 8-битового исходного кодирования и одна - для смены таблицы на таблицу N 1. Значения не более 1 кодируются с помощью полного кодирования Хаффмана. Значения более 1 кодируются с помощью исходного кодирования. Первый бит 9-битового кода является префиксом.
Если третье поле (переключатель таблиц) структуры (в данном случае номер 5) равно 0, то это означает, что фактическую таблицу Хаффмана необходимо сменить на таблицу, номер которой указан в базовом значении. В данном случае префикс для смены таблиц равен 111b, а номер новой таблицы равен 1.
Таблица C.5
Номер кодовой структуры | Число битов | Режим таблицы | Базовое значение | Код префикса (в битах) | |
Полный код | Префикс | ||||
1 | 9 | 1 | 1 | Запись отсутствует (0), 8-битовый оригинал | 0 |
2 | 3 | 3 | 1 | 0 | 100 |
3 | 3 | 3 | 1 | 1 | 101 |
4 | 3 | 3 | 1 | -1 | 110 |
5 | 3 | 3 | 0 | 1 (перейти к таблице N 1) | 111 |
C.3.7.4.3 Таблицы Хаффмана без переключателя таблиц
Рассмотрим пример следующей последовательности байт-ориентированных данных:
1, 2, -1, 0, 3, 0, 4, 1, 0, -2,
0, 15, -1, 0, 13, 0, 1, -2, -1, 1.
Эти данные должны кодироваться с помощью таблицы Хаффмана N 1. Для каждого значения данных выбирается соответствующий битовый код из таблицы Хаффмана и соединяется с битовым потоком. Если значение не обнаружено в таблице, то оно должно кодироваться с помощью исходного кодирования, как описано выше.
Таблица C.6
Номер | Значение | Полный код | Комментарии |
1 | 1 | 100 | 3-битовый префикс, без остатка |
2 | 2 | 1100 | 4-битовый префикс, без остатка |
3 | -1 | 101 | 3-битовый префикс, без остатка |
4 | 0 | 0 | 1-битовый префикс, без остатка |
5 | 3 | 111100000011 | 4-битовый префикс, 8-битовый остаток |
6 | 0 | 0 | 1-битовый префикс, без остатка |
7 | 4 | 111100000100 | 4-битовый префикс, 8-битовый остаток |
8 | 1 | 100 | 3-битовый префикс, без остатка |
9 | 0 | 0 | 1-битовый префикс, без остатка |
10 | -2 | 1101 | 4-битовый префикс, без остатка |
11 | 0 | 0 | 1-битовый префикс, без остатка |
12 | 15 | 111100001111 | 4-битовый префикс, 8-битовый остаток |
13 | -1 | 101 | 3-битовый префикс, без остатка |
14 | 0 | 0 | 1-битовый префикс, без остатка |
15 | 13 | 111100001101 | 4-битовый префикс, 8-битовый остаток |
16 | 0 | 0 | 1-битовый префикс, без остатка |
17 | 1 | 100 | 3-битовый префикс, без остатка |
18 | -2 | 1101 | 4-битовый префикс, без остатка |
19 | -1 | 101 | 3-битовый префикс, без остатка |
20 | 1 | 100 | 3-битовый префикс, без остатка |
Полученный поток битов:
100110010101111000000110111100000100100011010111100001111101011110000110101001101101100
C.3.7.4.4 Таблицы Хаффмана с переключением таблиц
Для более эффективного сжатия можно кодировать данные с помощью нескольких таблиц Хаффмана. Например, разумным является кодирование эталонного цикла и остаточной записи с помощью разных таблиц или переключаться на другую таблицу в процессе кодирования, если вероятность появления значений данных со временем изменилась.
Пусть, например, извлечена следующая последовательность байт-ориентированных значений данных (включая объявления переключения):
1, 2, -1, 0, 3, 0, 4, 1, 0, -2, переключение на таблицу 2,
0, 15, -1, 0, 13, переключение на таблицу 1, 0, 1, -2, -1, 1.
Кодирование начинается с таблицы Хаффмана N 1. После 10-го значения для кодирования используется таблица Хаффмана N 2, а после кодирования 16-го значения снова используется таблица N 1.
Соответствие байт-ориентированных значений данных и битовых кодов Хаффмана см. в таблице C.7.
Таблица C.7
Номер | Значение | Полный код | Таблица | Переключатель таблиц (ПТ) | Комментарии |
1 | 1 | 100 | 1 | 1 | 3-битовый префикс, без остатка |
2 | 2 | 1100 | 1 | 1 | 4-битовый префикс, без остатка |
3 | -1 | 101 | 1 | 1 | 3-битовый префикс, без остатка |
4 | 0 | 0 | 1 | 1 | 1-битовый префикс, без остатка |
5 | 3 | 111100000011 | 1 | 1 | 4-битовый префикс, 8-битовый остаток |
6 | 0 | 0 | 1 | 1 | 1-битовый префикс, без остатка |
7 | 4 | 111100000100 | 1 | 1 | 4-битовый префикс, 8-битовый остаток |
8 | 1 | 100 | 1 | 1 | 3-битовый префикс, без остатка |
9 | 0 | 0 | 1 | 1 | 1-битовый префикс, без остатка |
10 | -2 | 1101 | 1 | 1 | 4-битовый префикс, без остатка |
11 | (2) | 1110 | 1 | 0 | 4-битовый префикс  таблица N 2 |
12 | 0 | 100 | 2 | 1 | 3-битовый префикс, без остатка |
13 | 15 | 000001111 | 2 | 1 | 1-битовый префикс, 8-битовый остаток |
14 | -1 | 110 | 2 | 1 | 3-битовый префикс, без остатка |
15 | 0 | 100 | 2 | 1 | 3-битовый префикс, без остатка |
16 | 13 | 000001101 | 2 | 1 | 1-битовый префикс, 8-битовый остаток |
17 | (1) | 111 | 2 | 0 | 3-битовый префикс  таблица N 1 |
18 | 0 | 0 | 1 | 1 | 1-битовый префикс, без остатка |
19 | 1 | 100 | 1 | 1 | 3-битовый префикс, без остатка |
20 | -2 | 1101 | 1 | 1 | 4-битовый префикс, без остатка |
21 | -1 | 101 | 1 | 1 | 3-битовый префикс, без остатка |
22 | 1 | 100 | 1 | 1 | 3-битовый префикс, без остатка |
Обозначения "  таблица N" - переключение на таблицу N; () означают, что число не будет перемещено из базового значения в поле восстановленных данных. | |||||
Результирующий поток битов:
100110010101111000000110111100000100100011011110
10000000111111010000000110111101001101101100
C.3.7.5 Определение и хранение таблиц Хаффмана в разделе 2
В целях объяснения того, как таблицы Хаффмана (для базового кода/префикса см. примечание 1) должны храниться в разделе 2, в таблицах C.6 и C.7 представлен общий вид их расположения в стиле, использованном в основном документе протокола SCP-ECG. См. таблицу C.8.
Таблица C.8
Пример хранения двух таблиц Хаффмана в разделе 2
Заголовок раздела: | CRC | ID | Длина | Зарезервировано | ||
2 a) | 2 | 4 | 8 | |||
Число таблиц: | 2 | |||||
2 | ||||||
Число структур: | 7 (в первой таблице) | |||||
2 | ||||||
Структура 1 | 1 | 1 | 1 | 0 | 0 | |
Структура 2 | 3 | 3 | 1 | 1 | 1 | |
Структура 3 | 3 | 3 | 1 | -1 | 5 | |
Структура 4 | 4 | 4 | 1 | 2 | 3 | |
Структура 5 | 4 | 4 | 1 | -2 | 11 | |
Структура 6 | 4 | 4 | 0 | 2 | 7 | |
Структура 7 | 4 | 12 | 1 | 0 | 15 | |
a) для каждой структуры | 1 | 1 | 1 | 2 | 4 | |
Число структур: | 5 (во второй таблице) | |||||
2 | ||||||
Структура 1 | 1 | 9 | 1 | 0 | 0 | |
Структура 2 | 3 | 3 | 1 | 0 | 1 | |
Структура 3 | 3 | 3 | 1 | 1 | 5 | |
Структура 4 | 3 | 3 | 1 | -1 | 3 | |
Структура 5 | 3 | 3 | 0 | 1 | 7 | |
a) для каждой структуры | 1 | 1 | 1 | 2 | 4 | |
Примечания
1 Первый бит базового кода/префикса в коде представлен младшим значащим битом 4-байтовой области. Это означает, что код хранится в 4-байтовом поле с обратным порядком битов. Таким образом, код 100b (десятичное 4) хранится как 1b (десятичное 1), код 1100b (десятичное 12) как 0011b (десятичное 3) и т.д. Для понимания необходимо сравнить два последних столбца в таблице Хаффмана по умолчанию (таблица C.9 - см. C.3.7.6).
2 Числа, выделенные курсивом, указывают длину соответствующих полей в байтах.
Теоретически для разных наборов данных ЭКГ могут требоваться разные кодовые таблицы Хаффмана. Однако в результате широких экспериментов с различными наборами данных было выявлено, что следующая таблица Хаффмана может использоваться практически для всех типов данных ЭКГ без особых потерь в эффективности сжатия.
Если, с другой стороны, производитель хочет применять разные таблицы к разным ЭКГ (наборам данных ЭКГ), то он может определить свои таблицы в разделе 2 протокола SCP-ECG.
Таблица C.9 является таблицей Хаффмана по умолчанию в SCP-ECG, упомянутой в 5.5.4, байты 1, 2. Она использовалась для кодирования данных, приведенных в примерах 1 и 2 соответственно в C.4.1 и C.4.2.
Таблица C.9
Номер кодовых структур | Число битов | Переключение таблицы | Базовое значение | Код префикса (в битах) | Хранится в двоичном виде как | |
Полный код | Префикс | |||||
1 | 1 | 1 | 1 | 0 | 0 | 0d |
2 | 3 | 3 | 1 | 1 | 100 | 1d |
3 | 3 | 3 | 1 | -1 | 101 | 5d |
4 | 4 | 4 | 1 | 2 | 1100 | 3d |
5 | 4 | 4 | 1 | -2 | 1101 | 11d |
6 | 5 | 5 | 1 | 3 | 11100 | 7d |
7 | 5 | 5 | 1 | -3 | 11101 | 23d |
8 | 6 | 6 | 1 | 4 | 111100 | 15d |
9 | 6 | 6 | 1 | -4 | 111101 | 47d |
10 | 7 | 7 | 1 | 5 | 1111100 | 31d |
11 | 7 | 7 | 1 | -5 | 1111101 | 95d |
12 | 8 | 8 | 1 | 6 | 11111100 | 63d |
13 | 8 | 8 | 1 | -6 | 11111101 | 191d |
14 | 9 | 9 | 1 | 7 | 111111100 | 127d |
15 | 9 | 9 | 1 | -7 | 111111101 | 383d |
16 | 10 | 10 | 1 | 8 | 1111111100 | 255d |
17 | 10 | 10 | 1 | -8 | 1111111101 | 767d |
18 | 18 | 10 | 1 | 8-битовый оригинал | 1111111110 | 511d |
19 | 26 | 10 | 1 | 16-битовый оригинал | 1111111111 | 1023d |
Чтобы идентифицировать переключение на другую таблицу Хаффмана, следует использовать ПТ (см. в основном документе пункт 5.6.4, байт 7). Этот переключатель должен быть вставлен в поток данных, кодируемый по Хаффману. Он идентифицирует смену таблицы Хаффмана. Новая таблица Хаффмана, которая должна использоваться для декодирования данных, идентифицирована в соответствующей структуре (см. 5.6.4, байты 8, 9 в основном документе).
C.3.8 Декодирование сжатых ЭКГ данных
C.3.8.1 Общие положения
Для логически согласованного описания сжатия и распаковки используется одинаковая нотация для переменных и индексов. Имена переменных и индексов, используемых в алгоритме распаковки, дополнены знаком штриха (').
Пример - Сжатие: X(m, n), Z(m, q),  и т.д.; распаковка: X'(m, n), Z'(m, q),
 и т.д.
; распаковка: X'(m, n), Z'(m, q), и т.д.C.3.8.2 Декодирование с помощью таблиц Хаффмана
Декодирование данных, закодированных методом Хаффмана, осуществляется следующим образом.
Выбирается первый бит из битового потока каждого кодированного отведения и сравнивается с первой таблицей Хаффмана (или с таблицей по умолчанию). Если найден совпадающий префикс, то соответствующее значение должно быть введено в поле декодированных данных. При использовании полного кодирования Хаффмана оно является соответствующим базовым значением, а при использовании исходного кодирования - значением данных, восстановленным из остатка. Длина остатка равна разнице длины всего кода и префикса. Если не обнаружено никакого совпадающего кода префикса, то выбираются первые два бита и сравниваются, если необходимо, с первыми тремя и т.д. Если код найден и значение данных введено в поле, то сравнение продолжается со следующим битом.
Если найден префикс структуры переключателя таблиц Хаффмана, то из текущей таблицы необходимо выйти. На это указывает значение переключателя, равное 0. Номер новой таблицы считывается из базового значения данной структуры. После переключения на новую таблицу декодирование может продолжаться в соответствии с данным описанием.
C.3.8.3 Восстановление из разностей первого и второго порядков
C.3.8.3.1 Общие положения
Протокол SCP-ECG оставляют на усмотрение пользователя, будет ли он хранить/передавать разности первого или второго порядка либо даже исходные данные. Тип данных указан в байте 5 заголовка раздела 5 (для эталонного цикла) и заголовка раздела 6 (для остаточной записи). Предполагается, что остаточная запись, являющаяся результатом декодирования Хаффмана, содержит всего Q значений.
C.3.8.3.2 Разности первого порядка
Обозначим считывания, декодированные по Хаффману для отведения m, следующим образом:
 ,
 , ...,
 , ...,
 .
"Исходные" данные Z'(m, n) могут быть вычислены по следующей формуле:
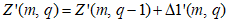 ; q = 2 по Q.
Восстановление "исходных" данных из разностей первого порядка требует хранения/передачи одного (первого) исходного значения данных:
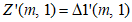 ,
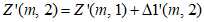 ,
где  является необходимым "исходным" значением.
C.3.8.3.3 Разности второго порядка
Обозначим считывания, декодированные по Хаффману для отведения m, следующим образом:
 ,
 , ...,
 , ...,
 .
"Исходные" данные Z'(m, n) могут быть вычислены по следующей формуле:
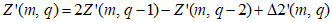 ; q = 3 по Q.
Восстановление "исходных" данных из разностей второго порядка требует хранения и передачи двух исходных значений:
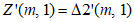 ,
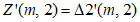 ,
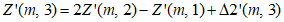 ,
где  и
 являются необходимыми "исходными" значениями.
и являются необходимыми "исходными" значениями.Таким же образом данные эталонного цикла Y'(m, p) могут быть вычислены из разностей первого и/или второго порядка эталонного цикла.
Соответствующие исходные значения должны храниться в начале кодированных данных (см. 5.8.3).
C.3.8.4 Восстановление прореженных считываний
К "медленно меняющимся" данным может применяться прореживание считываний (до максимального интервала между считываниями 8 мс, что равносильно частоте 125 считываний/с). Использование прореживания считываний называется бимодальным сжатием, его признаком служит байт 6, указанный в 5.9.3.
Не существует алгоритма для точного восстановления прореженных считываний. Лучшие результаты прореживания считываний получаются, если алгоритмы сжатия и распаковки согласованы между собой.
Следующий усредняющий алгоритм сжатия дает удовлетворительные результаты:
первое среднее значение:
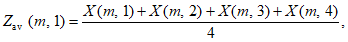
второе среднее значение:
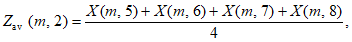
...
и для распаковки:
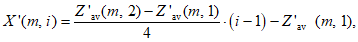
где 1 <= i <= 4.
Величина Z'av(m, 1) является левосторонним средним значением [равна X'(m, 1)], а величина Z'av(m, 2) является правосторонним средним значением четырех повторно вычисленных значений интервала. Это восстановление целиком покрывает незащищенную область, a, b (b - a равно числу непрореженных считываний). Первые два восстановленных считывания данной области полагаются равными первому среднему значению, а два последних считывания полагаются равными последнему среднему значению.
Интервал a, b:
X'(m, a) = Z'av(m, a),
X'(m, a + 1) = Zav(m, a).
Интерполяция в интервалах (b - a - 1)/4:
X'(m, b - 1) = Z'av(m, (b - a)/4),
X'(m, b) = Z'av(m, (b - a)/4).
Пример - В таблице C.10 приведен пример прореживания и восстановления 100 считываний. Для более простого представления шаги вычисления разностей и кодирования Хаффмана были опущены. Значения Zav вычисляются так, как описано выше.
Таблица C.10
Пример прореживания и восстановления 100 считываний
Номер | Оригинал | После прореживания | Реконструкция |
1 | X'(m, 1) | Z'av (m, 1) | Z'av (m, 1) |
2 | X'(m, 2) | Z'av (m, 1) | |
3 | X'(m, 3) | Z'av (m, 1) | |
4 | X'(m, 4) | Z'av (m, 1) + 1[Z'av (m, 2) - Z'av (m, 1)]/4 | |
5 | X'(m, 5) | Z'av(m, 2) | Z'av (m, 1) + 2[Z'av (m, 2) - Z'av (m, 1)]/4 |
6 | X'(m, 6) | Z'av (m, 1) + 3[Z'av (m, 2) - Z'av (m, 1)]/4 | |
7 | X'(m, 7) | Z'av (m, 2) | |
8 | X'(m, 8) | Z'av (m, 2) + 1[Z'av (m, 3) - Z'av (m, 2)]/4 | |
9 | X'(m, 9) | Z'av(m, 3) | Z'av (m, 2) + 2[Z'av (m, 3) - Z'av (m, 2)]/4 |
10 | X'(m, 10) | Z'av (m, 2) + 3[Z'av (m, 3) - Z'av (m, 2)]/4 | |
11 | X'(m, 11) | Z'av (m, 3) | |
12 | X'(m, 12) | Z'av (m, 3) + 1[Z'av (m, 4) - Z'av (m, 3)]/4 | |
... | |||
93 | X'(m, 93) | Z'av(m, 24) | Z'av (m, 23) + 2[Z'av (m, 24) - Z'av (m, 24)]/4 |
94 | X'(m, 94) | Z'av (m, 23) + 3[Z'av (m, 24) - Z'av (m, 24)]/4 | |
95 | X'(m, 95) | Z'av (m, 24) | |
96 | X'(m, 96) | Z'av (m, 24) + 1[Z'av (m, 25) - Z'av (m, 24)]/4 | |
97 | X'(m, 97) | Z'av(m, 25) | Z'av (m, 24) + 2[Z'av (m, 25) - Z'av (m, 24)]/4 |
98 | X'(m, 98) | Z'av (m, 24)+ 3[Z'av (m, 25) - Z'av (m, 24)]/4 | |
99 | X'(m, 99) | Z'av (m, 25) | |
100 | X'(m, 100) | Z'av (m, 25) | |
C.3.8.5 Низкочастотная фильтрация восстановленной остаточной записи
Низкочастотная фильтрация остаточной записи, выполненная за пределами защищенных областей после восстановления прореженных считываний, "сглаживает" шум, возникший во время восстановления. Простой нерекурсивный фильтр "скользящего среднего" дает удовлетворительную низкочастотную фильтрацию остаточной записи.
Длина фильтра составляет три считывания. Значения фильтра вычисляются следующим образом:
F'(m, a) - X'(m, a),
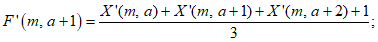
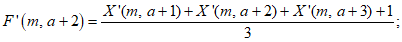
...
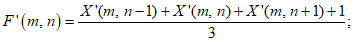
...
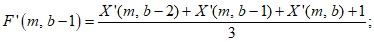
F'(m, b) = X'(m, b).
от k = 0 до K,
a = QE(k) + 1, QE(0) = 0,
b = QB(k + 1) - 1, QB(K + 1) = N + 1,
a + 1 <= n <= b - 1.
Примечание - Методы округления определены в C.3.2.2 и C.3.2.3. Константа округления "1" в предыдущем уравнении должна быть сделана отрицательной, если фильтруемые значения отрицательны.
C.3.8.6 Умножение необработанных данных на AVM
C.3.8.6.1 Общие положения
Этот шаг означает калибровку. С этой целью данные умножаются на AVM для получения необработанных данных, а в случае высокой степени сжатия на него также умножаются остаточная запись и эталонный цикл, имеющие одинаковое разрешение.
C.3.8.6.2 Необработанные данные
X'r(m, n) = X'(m, n)·AVM, | 1 <= n <= N, |
1 <= m <= M. |
C.3.8.6.3 Данные эталонного цикла
Y'r(m, p) = Y'(m, p)·AVM, | 1 <= p <= P, |
1 <= m <= M. |
C.3.8.7 Добавление эталонного цикла к остаточной записи
Протокол SCP-ECG спроектирован для обработки данных, которые можно сжимать и кодировать различными методами:
a) только сокращение избыточности;
b) "высокое сжатие SCP-ECG".
В случае "высокого" сжатия необходимо снова добавить эталонный цикл к остаточной записи во всех тех местах, где он был вычтен во время сжатия. Поэтому эталонный цикл должен быть синхронизирован с остаточной записью в опорных точках fc(k) и fcM, хранящихся в записи SCP-ECG. Указатели на защищенные зоны QRS вычисляются из хранящихся указателей. Область для добавления эталонного цикла в цикл k вычисляется по указателям SB(k) (начало добавления) и SE(k) (конец добавления).
Примечания
1 В разделе 4 протокола SCP-ECG (см. 5.7.4) байты с 3 по 6 зарезервированы для хранения указателей на начало добавления данных эталонного цикла [SB(k)]. Байты с 7 по 10 зарезервированы для хранения опорной точки цикла k [fc(k)], а байты с 11 по 14 зарезервированы для хранения конца добавления данных эталонного цикла к циклу k [SE(k)] для всех циклов. Добавление данных эталонного цикла в остаточную запись (по принципу считывание за считыванием) в соответствующем месте цикла fc(k) позволит восстановить исходные данные считываний.
2 Если QRS имеет ненулевой тип (в байтах 1, 2, см. 5.7.4), то эталонный цикл 0 не был вычтен из цикла (см. сноску 3 5.7.4).
C.3.8.8 Параметры распаковки записи SCP-ECG по умолчанию
В алгоритме распаковки записи SCP-ECG по умолчанию используются следующие параметры:
- использование вычитания эталонного цикла (раздел 3, байт 2, бит 0 = 1);
- AVM для данных эталонного цикла = 5 мкВ (раздел 5, байты 1 + 2 = 5000);
- интервал между считываниями в данных эталонного цикла = 2 мс (раздел 5, байты 3 + 4 = 2000);
- для представления данных эталонного цикла используются разности второго порядка (раздел 5, байт 5 = 2);
- AVM для остаточной записи = 20 мкВ (раздел 6, байты 1 + 2 = 20 000);
- интервал между считываниями в остаточной записи за пределами защищенных зон (QRS) = 8 мс (раздел 6, байты 3 + 4 = 8000);
- для представления данных остаточной записи используются разности второго порядка (раздел 6, байт 5 = 2);
- интерполяция считываний осуществляется для интервала между считываниями 2 мс (алгоритм см. C.3.8.9);
- низкочастотная фильтрация, осуществляемая после интерполяции считываний, имеет длину фильтра три считывания (алгоритм см. C.3.8.10);
- для декодирования данных эталонного цикла и остаточной записи используется таблица Хаффмана (см. таблицу C.9).
В сжатых данных только защищенные области имеют исходный интервал между считываниями. Чтобы восстановить исходный интервал между считываниями, области сигнала, находящиеся между защищенными областями, а также части сигнала перед первой и после последней защищенной области должны быть развернуты с помощью алгоритма интерполяции.
Удовлетворительные результаты интерполяции считываний в интервале a, b можно получить с помощью следующего алгоритма:
Z'(m, a') - прореженные считывания;
X'(m, a) - считывания, прошедшие интерполяцию;
m - номер отведения;
X'(m, a) = Z'(m, a');
X'(m, a + 1) = Z'(m, a');
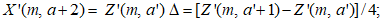 ;
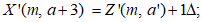
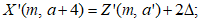
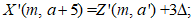
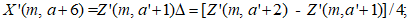
...
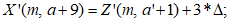
...
...
...
X'(m, b - 1) = Z'(m, b');
X'(m, b) = Z'(m, b').
Следующие вычисления выполняются для всех сегментов данных K + 1, находящихся за пределами защищенных областей:
от k = 0 до K
a = QE(k) + 1QE(0) = 0,
b = QB(k + 1) - 1QB(K + 1) = N + 1.
Низкочастотная фильтрация восстановленной остаточной записи выполняется для сглаживания результатов огрубления. Она может выполняться только за пределами защищенных областей, так как внутри QRS ошибка восстановления строго ограничена 15 мкВ. Особое внимание следует уделять границам областей вычитания. После вычитания данных эталонного цикла к этим границам могли применяться смещения, которые должны быть учтены после добавления данных эталонного цикла. Поэтому они не могут быть устранены при фильтрации. Для низкочастотной фильтрации восстановленной остаточной записи достаточно эффективен описанный ниже нерекурсивный фильтр "скользящего среднего".
Длина фильтра L должна составлять три считывания. Значения фильтра для нечетной длины фильтра L вычисляются следующим образом:
F'(m, a) = X'(m, a),
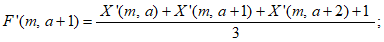
...
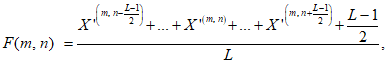
...
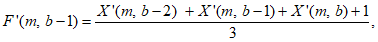
F'(m, b) = X'(m, b).
Существует три интервала фильтрации: a и b для каждого комплекса k и один дополнительный от конца комплекса K до конца потока данных.
1) От конца вычитания эталонного цикла типа 0 из предшествующего комплекса (k - 1) до начала вычитания из текущего комплекса k.
a = SE(k - 1) + 1, SE(0) = 0,
b = SB(k) - 1.
2) От начала вычитания эталонного цикла типа 0 из текущего комплекса k до начала QRS текущего комплекса k.
a = SB(k),
b = SB(k - 1).
3) От начала QRS текущего комплекса k до конца вычитания эталонного цикла типа 0 из текущего комплекса k.
a = QE(k) + 1,
b = SE(k).
4) Интервал фильтрации для остающихся считываний до конца данных:
a = SE(K) + 1,
b = N,
где m - номер отведения;
n - номер считывания;
K - число комплексов QRS;
N - номер последнего считывания;
k - номер комплекса QRS;
указатель на начало вычитания эталонного цикла типа 0 для цикла (k) в необработанных данных: | SB(k); |
указатель на конец вычитания эталонного цикла типа 0 для цикла (k) в необработанных данных: | SE(k); |
указатель на начало защищенной области комплекса (k) в необработанных и в остаточных данных: | QB(k); |
указатель на конец защищенной области комплекса (k) в необработанных и в остаточных данных: | QE(k). |
Примечание - Методы округления определены в C.3.2.2 и C.3.2.3. Константы округления 1, 2, ..., (L - 1)/2 в предыдущих уравнениях должны браться отрицательными, если фильтруемые значения отрицательны.
В настоящем примере показаны разные данные, полученные при высоком сжатии SCP-ECG для первых 28 считываний записи ЭКГ.
RAW - необработанные данные 1 мкВ/LSB, интервал между считываниями 2 мс (500 считываний/с);
TRU - огрубленные необработанные данные 1 мкВ/LSB -> 5 мкВ/LSB;
RES - остаточная запись после вычитаний эталонного цикла;
FIL - нерекурсивный фильтр "скользящего среднего" по девяти считываниям;
DEC - прореживание до интервала между считываниями 8 мс с усреднением (125 считываний/с);
2D - разности второго порядка, первые два значения исходные;
HUF - кодирование Хаффмана (код по умолчанию, таблица C.9).
Таблица C.11
Данные, получаемые при высоком сжатии записи SCP-ECG
Номер считывания | RAW | TRU | RES | FIL | DEC | 2D | HUF |
1 | 63 | 13 | 13 | 13 | 14 | 14 | 111111111000001110 |
2 | 70 | 14 | 14 | 14 | |||
3 | 74 | 15 | 15 | 14 | |||
4 | 71 | 14 | 14 | 15 | |||
5 | 79 | 16 | 16 | 16 | 18 | 18 | 111111111000010010 |
6 | 89 | 18 | 18 | 17 | |||
7 | 96 | 19 | 19 | 19 | |||
8 | 102 | 20 | 20 | 20 | |||
9 | 108 | 22 | 22 | 21 | 22 | 0 | 0 |
10 | 112 | 22 | 22 | 22 | |||
11 | 114 | 23 | 23 | 22 | |||
12 | 116 | 23 | 23 | 23 | |||
13 | 116 | 23 | 23 | 23 | 22 | -4 | 111101 |
14 | 112 | 22 | 22 | 22 | |||
15 | 110 | 22 | 22 | 21 | |||
16 | 100 | 20 | 20 | 19 | |||
17 | 87 | 17 | 17 | 18 | 13 | -9 | 111111111011110111 |
18 | 74 | 15 | 15 | 14 | |||
19 | 59 | 12 | 12 | 12 | |||
20 | 42 | 8 | 8 | 9 | |||
21 | 28 | 6 | 6 | 6 | 3 | -1 | 101 |
22 | 13 | 3 | 3 | 4 | |||
23 | 5 | 1 | 1 | 2 | |||
24 | -1 | 0 | 0 | 0 | |||
25 | -8 | -2 | -2 | -1 | -2 | 5 | 1111100 |
26 | -11 | -2 | -2 | -2 | |||
27 | -13 | -3 | -3 | -3 | |||
28 | -17 | -3 | -3 | -3 | |||
... | ... | ... | ... | ... | ... | ... | ... |
56 байтов = 448 битов -> сокращены до 71 бита.
Первые 28 считываний необработанных данных отведения сжимаются в битовый поток
11111111100000111011111111100001001001111011111111110111101111011111100...,
имеющий следующее шестнадцатеричное представление:
FF 83 BF E1 27 BF F7 BD...
В этом примере показаны разные данные, получаемые при полном сокращении избыточности по методу SCP-ECG для первых 28 считываний записи ЭКГ.
RAW - необработанные данные 1 мкВ/LSB, интервал между считываниями 2 мс (500 считываний/с);
TRU - огрубленные необработанные данные 1 мкВ/LSB -> 5 мкВ/LSB;
RES - остаточная запись после вычитаний эталонного цикла;
2D - разности второго порядка, первые два значения исходные;
HUF - кодирование Хаффмана (код по умолчанию, таблица C.9).
Таблица C.12
Полное сокращение избыточности по методу SCP-ECG
Номер считывания | RAW | TRU | RES | 2D | HUF |
1 | 63 | 13 | 13 | 13 | 111111111000001101 |
2 | 70 | 14 | 14 | 14 | 111111111000001110 |
3 | 74 | 15 | 15 | 0 | 0 |
4 | 71 | 14 | 14 | -2 | 1101 |
5 | 79 | 16 | 16 | 3 | 11100 |
6 | 89 | 18 | 18 | 0 | 0 |
7 | 96 | 19 | 19 | -1 | 101 |
8 | 102 | 20 | 20 | 0 | 0 |
9 | 108 | 22 | 22 | 1 | 100 |
10 | 112 | 22 | 22 | -2 | 1101 |
11 | 114 | 23 | 23 | 1 | 100 |
12 | 116 | 23 | 23 | -1 | 101 |
13 | 116 | 23 | 23 | 0 | 0 |
14 | 112 | 22 | 22 | -1 | 101 |
15 | 110 | 22 | 22 | 1 | 100 |
16 | 100 | 20 | 20 | -2 | 1101 |
17 | 87 | 17 | 17 | -1 | 101 |
18 | 74 | 15 | 15 | 1 | 100 |
19 | 59 | 12 | 12 | -1 | 101 |
20 | 42 | 8 | 8 | -1 | 101 |
21 | 28 | 6 | 6 | 2 | 1100 |
22 | 13 | 3 | 3 | -1 | 101 |
23 | 5 | 1 | 1 | 1 | 100 |
24 | -1 | 0 | 0 | 1 | 100 |
25 | -8 | -2 | -2 | -1 | 101 |
26 | -11 | -2 | -2 | 2 | 1100 |
27 | -13 | -3 | -3 | -1 | 101 |
28 | -17 | -3 | -3 | 1 | 100 |
... | ... | ... | ... | ... | ... |
56 байтов = 448 битов -> сокращены до 113 битов.
Первые 28 считываний необработанных данных отведения сжимаются в битовый поток
11111111100000110111111111100000111001101111010101010011011001
010101100110110110010110111001011001001011100101100...,
имеющий следующее шестнадцатеричное представление:
FF 83 7F E0 E6 F5 53 65 59 B6 5B 96 4B 96...
В таблице C.13 представлены ЭКГ, выбранные для тестирования ошибок сжатия и распаковки SCP-ECG. Данные предоставлены в виде 10-секундных цифровых записей с частотой 500 считываний/с и уровнем дискретизации 5 мкВ/LSB. В ЭТОТ набор включены ЭКГ с синусовым ритмом, фибрилляцией предсердий, трепетанием предсердий, полиформными и моноформными желудочковыми экстрасистолами, а также с суправентрикулярной экстрасистолой. Включены два случая со значительными нарушениями внутрижелудочковой проводимости. Для верификации абсолютной калибровки в набор включена искусственная ЭКГ с низким уровнем шума и частотой сердечных сокращений 120 ударов в минуту с синусовым ритмом.
Эти данные взяты из эталонной базы данных CSE, содержащей многие отведения и предназначенной для тестирования распознавания зубцов, а также из диагностической эталонной базы CSE. Некоторые данные были слегка "сглажены", чтобы избавиться от определенного уровня шума. Все эти записи ЭКГ подверглись сжатию и распаковке в соответствии со стандартами, предложенными рабочей группой SCP-ECG. Среднеквадратичные ошибки (RMS) и абсолютные максимальные ошибки, выявленные после восстановления, приведены в таблице C.13.
Рисунок C.7 - ЭКГ для данных примера (отведения с V1 по V6)
Таблица C.13
в соответствии со стандартом SCP-ECG
Пациент | Ритм, морфология QRS | Шум |
PD2-003 Распакована | Синусовый ритм, передний инфаркт, QRS с зубцом Абсолютная максимальная ошибка: 64 мкВ; RMS: 7,9 мкВ | 5 мкВ |
PD2-010 Распакована | Синусовая тахикардия; Абсолютная максимальная ошибка: 67 мкВ; RMS: 8,1 мкВ | 6 мкВ |
PD2-051 Распакована | Синусовый ритм, инфаркт Абсолютная максимальная ошибка: 44 мкВ; RMS: 7,6 мкВ | 3 мкВ |
PD2-078 PF2-078 Распакована | Предсердное трепетание, мышечный тремор в отведениях I и II, большие амплитуды (с предварительной фильтрацией). Абсолютная максимальная ошибка: 43 мкВ; RMS: 8,8 мкВ | 16 мкВ 10 мкВ |
PD2-217 Распакована | Синусовый ритм, нарушения внутрижелудочковой проводимости, передний инфаркт Абсолютная максимальная ошибка: 39 мкВ; RMS: 7,5 мкВ | 3 мкВ |
PD2-313 Распакована | Трепетание/мерцание предсердий Абсолютная максимальная ошибка: 62 мкВ; RMS: 8,8 мкВ | 8 мкВ |
PD3-145 PF3-145 Распакована | Полиморфные желудочковые экстрасистолы (с предварительной фильтрацией) Абсолютная максимальная ошибка: 77 мкВ; RMS: 8,6 мкВ | 18 мкВ 8 мкВ |
PD3-471 Распакована | Трепетание предсердий Абсолютная максимальная ошибка: 52 мкВ; RMS: 8,1 мкВ | 4 мкВ |
PD3-1207 PF3-1207 Распакована | Суправентрикулярные экстрасистолы (с предварительной фильтрацией) Абсолютная максимальная ошибка: 89 мкВ; RMS: 7,7 мкВ | 6 мкВ 4 мкВ |
PWE-103 PFE-103 Распакована | Полиморфные желудочковые экстрасистолии (с предварительной фильтрацией) Абсолютная максимальная ошибка: 41 мкВ; RMS: 8,6 мкВ | 26 мкВ 8 мкВ |
PWE-105 PFE-105 Распакована | Желудочковые экстрасистолы, полная блокада правой ножки пучка Гиса (с предварительной фильтрацией) Абсолютная максимальная ошибка: 54 мкВ; RMS: 7,7 мкВ | 19 мкВ 12 мкВ |
P120-N00 Распакована | Синусовая тахикардия, нормальный, математически сконструированный комплекс QRS Абсолютная максимальная ошибка: 16 мкВ; RMS: 5,0 мкВ | 0 мкВ 3 мкВ |
(справочное)
И ЗАПРОСОВ ДЛЯ ОБМЕНА ДАННЫМИ ЭЛЕКТРОКАРДИОГРАММЫ
D.1 Общие положения
Часть стандарта SCP-ECG, посвященная обмену сообщениями, описывает тип информации, который можно запрашивать и передавать на прикладном уровне между устройствами, а также формат заголовков сообщений. Настоящий стандарт определяет структуры сообщений данных и указывает последовательности обменов сообщениями, необходимые для передачи данных и запросов, требуемых протоколом, вместе с форматом каждого типа сообщений. Описано также использование информационных сообщений. Содержание данных описано ранее в разделе 5. Знание содержания данных протокола необходимо для понимания части, описывающей обмен сообщениями.
D.2.1 Общие положения
Длина каждого блока сообщения составляет 256 байтов. Первый байт каждого блока сообщения является символом ASCII, идентифицирующим тип сообщения. В настоящий момент определены следующие типы (минимальный набор): I, R, S, A и D. Двоичные данные по умолчанию и зарезервированные поля должны заполняться нулями. Строки текстовых символов должны завершаться байтом NULL. Разработчик должен следить за тем, чтобы все сообщения имели длину 256 байтов или меньше. Для выполнения этого требования может понадобиться усечение полей данных свободного текста (например, раздел 1, тег 14). Сообщения с длиной больше 256 байтов будут восприниматься как неправильно форматированные.
Таблица D.1
Обмен идентификационными данными (тип сообщения - "I")
Номера байтов | |
Тип сообщения - "I" (ASCII, 1 байт) | 1 |
Идентификационный номер организации <a> (двоичный) | 2, 3 |
Идентификационный номер отделения <a> (двоичный) | 4, 5 |
Идентификационный номер устройства (ID) <a> (двоичный) | 6, 7 |
Тип устройства <a> (0 - устройство картирования, 1 - система) (двоичный) | 8 |
Код производителя <b> (двоичный) | 9 |
Описание модели <b> (до 5 символов ASCII, например, "0107B", "MAC15", "4760A" + NULL) | С 10 по 15 |
Номер версии протокола SCP-ECG (двоичный) | 16 |
Уровень совместимости с протоколом SCP-ECG (двоичный) | 17 |
Код языковой поддержки <c> (1-байтовое побитовое отображение) | 18 |
Функциональные возможности <d> (двоичный) | 19 |
Частота основных внешних источников питания (двоичный) | 20 |
Зарезервированы | С 21 по 128 |
Идентификатор программного обеспечения реализации SCP устройства снятия. Максимум 24 символа плюс терминатор NULL из 5.4.5, тег 14 | С 129 по 153 |
Производитель устройства снятия. Содержит зарегистрированное торговое наименование производителя. Максимум 24 символа плюс терминатор NULL из 5.4.5, тег 14 | С 154 по 178 |
Запасное поле <l> | С 179 по 256 |
D.2.3 Запрос (тип сообщения - "R")
Таблица D.2
Запрос (тип сообщения - "R")
Номера байтов | |||||
Общее содержание запросов (байты с 1 по 14) | |||||
Тип сообщения - "R" (ASCII, 1 байт) | 1 | ||||
Запрос обработки <e> (ASCII, 1 байт) | 2 | ||||
Подзапрос <f> (1 двоичный байт) | 3 | ||||
Номер последовательности запроса (1 целочисленное без знака; 1 - 65 535) | 4, 5 | ||||
Пароль, 9 символов ASCII (необязательный) <g> | С 6 по 14 | ||||
С 15 по 256 | |||||
Примечания 1 Из соображений безопасности любой запрос должен подвергаться обработке только в том случае, когда между двумя взаимодействующими системами (устройством картирования и сервером) произошел успешный обмен идентифицирующими сообщениями. 2 Неизвестные поля или те, значения которых безразличны, должны иметь значение NULL. | |||||
| |||||
3 Каждое сообщение запроса начинается с поля "Общее содержание запросов" длиной в 14 байт, за которым следует поле, содержащее данные пациента длиной в 242 байта (байты с 15 по 256) в соответствии с D.2.2.1 - D.2.2.3. Каждый параметр должен храниться в отдельном поле и идентифицироваться ведущим специфицирующим байтом, называемым "тегом". За этим байтом следует длина (целое без знака), которую именуют "длиной", а за ней следует нуль или более байтов параметров, именуемых "значением" (см. D.2.2.1 - D.2.2.3). 4 Счетчик номеров последовательности запросов должен увеличиваться с каждым сообщением "запроса" и может возвращаться к 1 (один). Сбрасывается до 1 (один) при получении каждого идентифицирующего сообщения от машины-получателя. Значение 0 (нуль) не допускается. 5 Номера последовательности запросов предназначены для использования процедурой обнаружения избыточных и/или потерянных сообщений "запроса". | |||||
Таблица D.3
Запрос списка ЭКГ (подзапрос типа "E" или "L")
Длина поля в байтах | |
Общее содержание запросов (см. D.2.2) | 14 |
Номер организации (1 двоичное целое) | 2 |
Номер отдела (1 двоичное целое) | 2 |
Идентификатор пациента, тег = 2 (двоичное) | 1 |
Длина идентификатора пациента (двоичное) | 1 |
Текст идентификатора пациента (текстовые символы) | Переменная |
Фамилия пациента, тег = 0 (двоичное) | 1 |
Длина фамилии пациента (двоичное) | 1 |
Фамилия пациента (текстовые символы) | Переменная |
Имя пациента, тег = 1 (двоичное) | 1 |
Длина имени пациента (двоичное) | 1 |
Имя пациента (текстовые символы) | Переменная |
Пол пациента, тег = 8 (двоичное) | 1 |
Длина пола пациента = 1 (двоичное) | 1 |
Пол пациента (байт) | 1 |
Дата рождения пациента (ДРП), тег = 5 (двоичное) | 1 |
Длина ДРП пациента - 4 (двоичное) | 1 |
ДРП пациента (двоичное, 4 байта) <h> | 4 |
Запасное поле <l> | Переменная |
Всего 256 байтов |
D.2.3.2 Правила поиска для подзапросов типа "I" или "P"
Таблица D.4
Запрос списка пациентов (подзапрос типа "I" или "P")
Длина поля в байтах | |
Общее содержание запросов (см. D.2.2) | 14 |
Номер организации (двоичное) | 2 |
Номер отдела (двоичное) | 2 |
Идентификатор пациента, тег = 2 (двоичное) | 1 |
Длина идентификатора пациента (двоичное) | 1 |
Текст идентификатора пациента (текстовые символы) | Переменная |
Фамилия пациента, тег = 0 (двоичное) | 1 |
Длина фамилии пациента (двоичное) | 1 |
Фамилия пациента (текстовые символы) | Переменная |
Имя пациента, тег = 1 (двоичное) | 1 |
Длина имени пациента (двоичное) | 1 |
Имя пациента (текстовые символы) | Переменная |
Запасное поле <l> | Переменная |
Всего 256 байтов |
Таблица D.5
Запрос тестирования (подзапрос типа "R" или "S")
Длина поля в байтах | |
Общий запрос (см. D.2.2) | 14 |
Номер организации (учреждения?) (двоичное) | 2 |
Номер отделения (двоичное) | 2 |
ID пациента, тег = 2 (двоичное) | 1 |
Длина ID пациента (двоичное) | 1 |
ID пациента (текстовые символы) | Переменная |
Фамилия пациента, тег = 0 (двоичное) | 1 |
Длина фамилии пациента (двоичное) | 1 |
Фамилия пациента (текстовые символы) | Переменная |
Имя пациента, тег = 1 (двоичное) | 1 |
Длина имени пациента (двоичное) | 1 |
Имя пациента (текстовые символы) | Переменная |
Пол пациента, тег = 8 (двоичный) | 1 |
Длина пола пациента = 1 (двоичный) | 1 |
Пол пациента (двоичный) | 1 |
Дата рождения пациента (ДРП), тег = 5 (двоичное) | 1 |
Длина ДРП пациента = 4 (двоичное) | 1 |
ДРП пациента (двоичная в 4 байта) | 4 |
Дата снятия, тег = 25 (двоичное) | 1 |
Длина даты снятия = 4 (двоичное) | 1 |
Дата снятия (двоичная в 4 байта, формат, как у ДРП) | 4 |
Время снятия, тег = 26 (двоичное) | 1 |
Длина времени снятия = 3 (двоичное) | 1 |
Время снятия (двоичное в 3 байта) <i> | 3 |
Запасное поле <l> | Переменная |
Всего 256 байтов |
Данные, отправленный в ответ на запросы типов "L" и "P" (для каждого отчета или пациента, соответствующего критериям поиска), состоят из последовательности разделов заголовков SCP-ECG, состоящей только из разделов 0 и 1.
D.2.3.4 Правила поиска для типов подзапросов "L" и "P"
1) При запросе списка ЭКГ (тип подзапроса "L") или списка пациентов (подзапрос типа "P") применимы следующие правила поиска:
i) любое поле может быть указано или не указано;
ii) если поле не указано, то предполагается, что оно "безразлично" и не используется как часть критериев поиска;
iii) если поле указано без символов подстановки [см. перечисление iv)], то необходимо точное совпадение;
iv) поля идентификатора пациента и его именования могут включать в себя "символы подстановки", они определяются следующим образом:
? - совпадает ровно с одним символом в данном месте,
* - совпадает с нулем или несколькими символами в данном месте,
символы "*" и "?" могут интерпретироваться буквально, если им предшествует символ обратной косой черты "\";
v) любой поиск является нечувствительным к регистру (символы в верхнем и нижнем регистрах эквивалентны).
Примеры
1 Идентификатор пациента = 123, фамилия и имя не указаны, совпадает со всеми фамилиями и именами пациентов, имеющих идентификатор = 123.
2 Фамилия пациента - "M*CFARL*" соответствует "MCFARLEY", "MacFarlane", "Macfarlane", "Mcfarlane" и т.д.
3 ID пациента - "\*FAR?" соответствует "*FAR1", "*FAR2", но не "*FAR99".
2) Эти правила поиска применяются только к запросам списков и не применимы к запросам ЭКГ (тип подзапроса "R"), в которых критерии поиска являются точными для обязательных параметров (организация, отделение, идентификатор пациента, дата и время снятия).
3) Тег типа 255 длиной 0 применяется для маркировки конца тегированных данных в сообщении "запроса списка".
Формат сообщения статуса показан в таблице D.6.
Таблица D.6
Сообщение статуса (тип сообщения - "S")
Номер байта | |
Тип сообщения - "S" (символ ASCII) | 1 |
Флаг статуса <j> (символ ASCII) | 2 |
Код причины ошибки <k> (двоичное) | 3 |
Порядковый номер запроса (двоичное): с 1 по 65 535 | 4, 5 |
Запасное поле <l> | С 6 по 256 |
Порядковый номер запроса в этом сообщении совпадает с порядковым номером того сообщения "запроса", чей статус возвращается.
Ложные сообщения "STATUS OK" (нормальный статус), полученные до ожидаемого сообщения типа "D" (запрос выполнен), будут игнорироваться.
D.2.5 Информационное сообщение (тип сообщения - "A")
Формат информационного сообщения показан в таблице D.7.
Таблица D.7
Информационное сообщение (тип сообщения - "A")
Номер байта | |
Тип сообщения - "A" (символ ASCII) | 1 |
Зарезервировано | 2, 3 |
Информационное сообщение (текстовая строка символов, завершаемая байтом NULL) | С 4 по 256 |
Руководство по использованию информационных сообщений приведено в D.5.
Сообщение о выполнении ("DONE") означает завершение выполнения команды. Сообщение "выполнено" имеет следующий формат.
Таблица D.8
Номер байта | |
Тип сообщения - "D" (символ ASCII) | 1 |
Зарезервировано | 2, 3 |
Запасное поле <l> | С 4 по 256 |
Информация к сообщению о выполнении:
- каждое устройство управляет флагом "ожидание завершения" (PT - pending termination);
- посылая сообщение типа "D" и устанавливая свой флаг РТ, ведущее устройство изменяет свой статус на ведомое;
- приняв сообщение типа "D", ведомое устройство изменяет свой статус на ведущее и устанавливает свой флаг РТ;
- если у ведомого устройства флаг РТ установлен, то при приеме сообщения типа "D" (без предшествующего сообщения типа "R"), оно должно завершить сеанс и прекратить связь;
- если у ведомого устройства флаг РТ не установлен, то оно может отправить сообщение типа "D", не меняя свой статус на ведущее устройство. При этом состояния флагов РТ ведущего и ведомого устройства не изменяются;
- если у ведущего устройства флаг РТ не установлен, то при приеме сообщения типа "D" оно устанавливает свой флаг РТ;
- если у ведущего устройства флаг РТ установлен, то при приеме сообщения типа "D" оно прекращает связь.
b) Коды производителя и обозначение модели устройства записи ЭКГ определены в полях демографических данных пациента и полях данных снятия ЭКГ раздела 1 (см. 5.4.3.1 и 5.4.5).
c) Код поддержки языка определен в 5.4.5, раздел 1, тег 14, байт 17.
1 - (LSB) запасной;
2 - запасной;
4 - запасной;
8 - запасной;
16 - печать ECG;
32 - интерпретация ECG;
64 - хранение ECG;
128 (MSB) - снятие ECG.
"E" - запрос на отправку списка ЭКГ, снятых для заданного пациента;
"I" - запрос на отправку списка пациентов с заданными именем и фамилией;
"L" - запрос на получение списка ЭКГ, снятых для заданного пациента;
"P" - запрос на получение списка пациента с заданными именем и фамилией;
"R" - запрос на получение ЭКГ;
"S" - запрос на отправку ЭКГ;
"X" - переход на запрос, специфичный для поставщика.
f) Данное поле используется только для запросов типа "R" и "X". Для этих типов запроса получатель извлекает из этого поля дополнительный код запроса.
В запросах типа "R" с помощью этого поля можно запросить несколько тестов. При этом нет необходимости использовать несколько запросов или обязательно знать дату и время проведения теста. Это поле является битовым массивом. Его значения определены следующим образом:
0 (ни один бит не установлен) - маска запроса не нужна: передать все ЭКГ;
1 (LSB) - запрошенная ЭКГ будет иметь дату и время;
2 - самая последняя ЭКГ;
4 - первая предыдущая ЭКГ;
8 - вторая предыдущая ЭКГ;
16 - базовая ЭКГ, если имеется, иначе самая ранняя ЭКГ;
32 - все с определенного срока, будет дополнен датой и временем.
В запросах типа "X" коды подзапросов являются расширениями, специфичными для поставщика, и здесь не определены.
g) Если система-получатель требует пароль, данное поле содержит пароль в кодировке ASCII, состоящий из девяти символов и заканчивающийся байтом NULL.
h) Даты имеют следующий формат (см. 5.4.5, раздел 1, теги 5 и 25):
Байты с 1 по 2 - двоичное: год.
Байт 3 - двоичное: месяц (с 01 по 12).
Байт 4 - двоичное: день месяца (с 01 по 31).
i) Время имеет следующий формат (см. 5.4.5, раздел 1, тег 26):
Байт 1 - двоичное: часы (с 00 по 23).
Байт 2 - двоичное: минуты (с 00 по 59).
Байт 3 - двоичное: секунды (с 00 по 59).
"G" - ОК (можно продолжать); код ошибки не используется. Приемник должен возобновить работу и отправить следующее сообщение.
"E" - Не ОК, ошибка:
- если ошибка идентификации, то вызов сразу завершается;
- в случае ошибки в запросе или в данных ЭКГ получатель может отправить другой запрос или сообщение "выполнено".
k) Для флага статуса "E" (статус ошибки) данное поле содержит следующий двоичный код, указывающий причину ошибки:
0 - неспецифичная ошибка;
1 - тип последнего сообщения не распознан;
2 - последнее сообщение недействительно;
3 - недействительный код местоположения; отправленное местоположение (т.е. номер организации или отдела) не определено;
4 - недействительный пароль;
5 - запрос на обработку не распознан: обрабатывающее устройство не понимает запрос;
6 - запрос на обработку не поддерживается: обрабатывающее устройство не поддерживает запрос;
7 - запрос на обработку не поддерживается: обрабатывающему устройству не хватает памяти;
10 - идентификация пациента недействительна;
11 - фамилия и имя пациента недействительны;
12 - демографические данные пациента недействительны; данные, не являющиеся идентификацией, фамилией или именем, имеют недействительный тип или диапазон;
13 - демографические данные пациента являются противоречивыми; данные не согласуются с уже хранящейся информацией о пациенте.
Следующие коды относятся к данным сигнала и к их поддержке принимающим устройством:
20 - неправильная частота считываний;
21 - неправильная комбинация отведений;
22 - ошибочная длительность отведения;
23 - неправильное сжатие данных;
24 - другая ошибка данных ЭКГ;
30 - измерения недействительны; одно или несколько измерений недействительны;
31 - недействительный диагноз;
40 - устройство вывода не готово;
41 - устройство хранения не готово;
42 - ошибка базы данных;
43 - другая системная ошибка;
44 - ошибка нехватки памяти;
50 - ЭКГ для данного местоположения отсутствуют;
60 - нет данных, соответствующих запросу.
Коды в диапазоне с 128 по 255 зарезервированы для кодов ошибок, специфичных для производителя.
l) Области, определенные в блоках данных сообщения как "ЗАПАСНЫЕ", доступны реализациям, специфичным для производителя.
D.2.8 Минимальные функциональные возможности
Чтобы соответствовать спецификациям данного раздела, система, состоящая из устройства картирования и сервера, должна быть способна:
1) обмениваться идентифицирующими сообщениями;
2) отвечать на запрос типа "R" с дополнительным кодом 0 в соответствии с D.2.7, перечисление f);
3) передавать "все" ЭКГ в соответствии с D.2.7, перечисления e) или f).
D.3 Диаграммы перехода состояний
На рисунке D.1 описан процесс обмена идентифицирующими сообщениями между устройством картирования и сервером, обеспечивающего установление сеанса взаимодействия по стандарту SCP-ECG. Необходимо отметить, что сеанс не переходит в состояние "соединения", пока не произошел успешный обмен идентифицирующими сообщениями (см. D.2.2). Описание функционирования после установления сеанса см. в D.3.2.
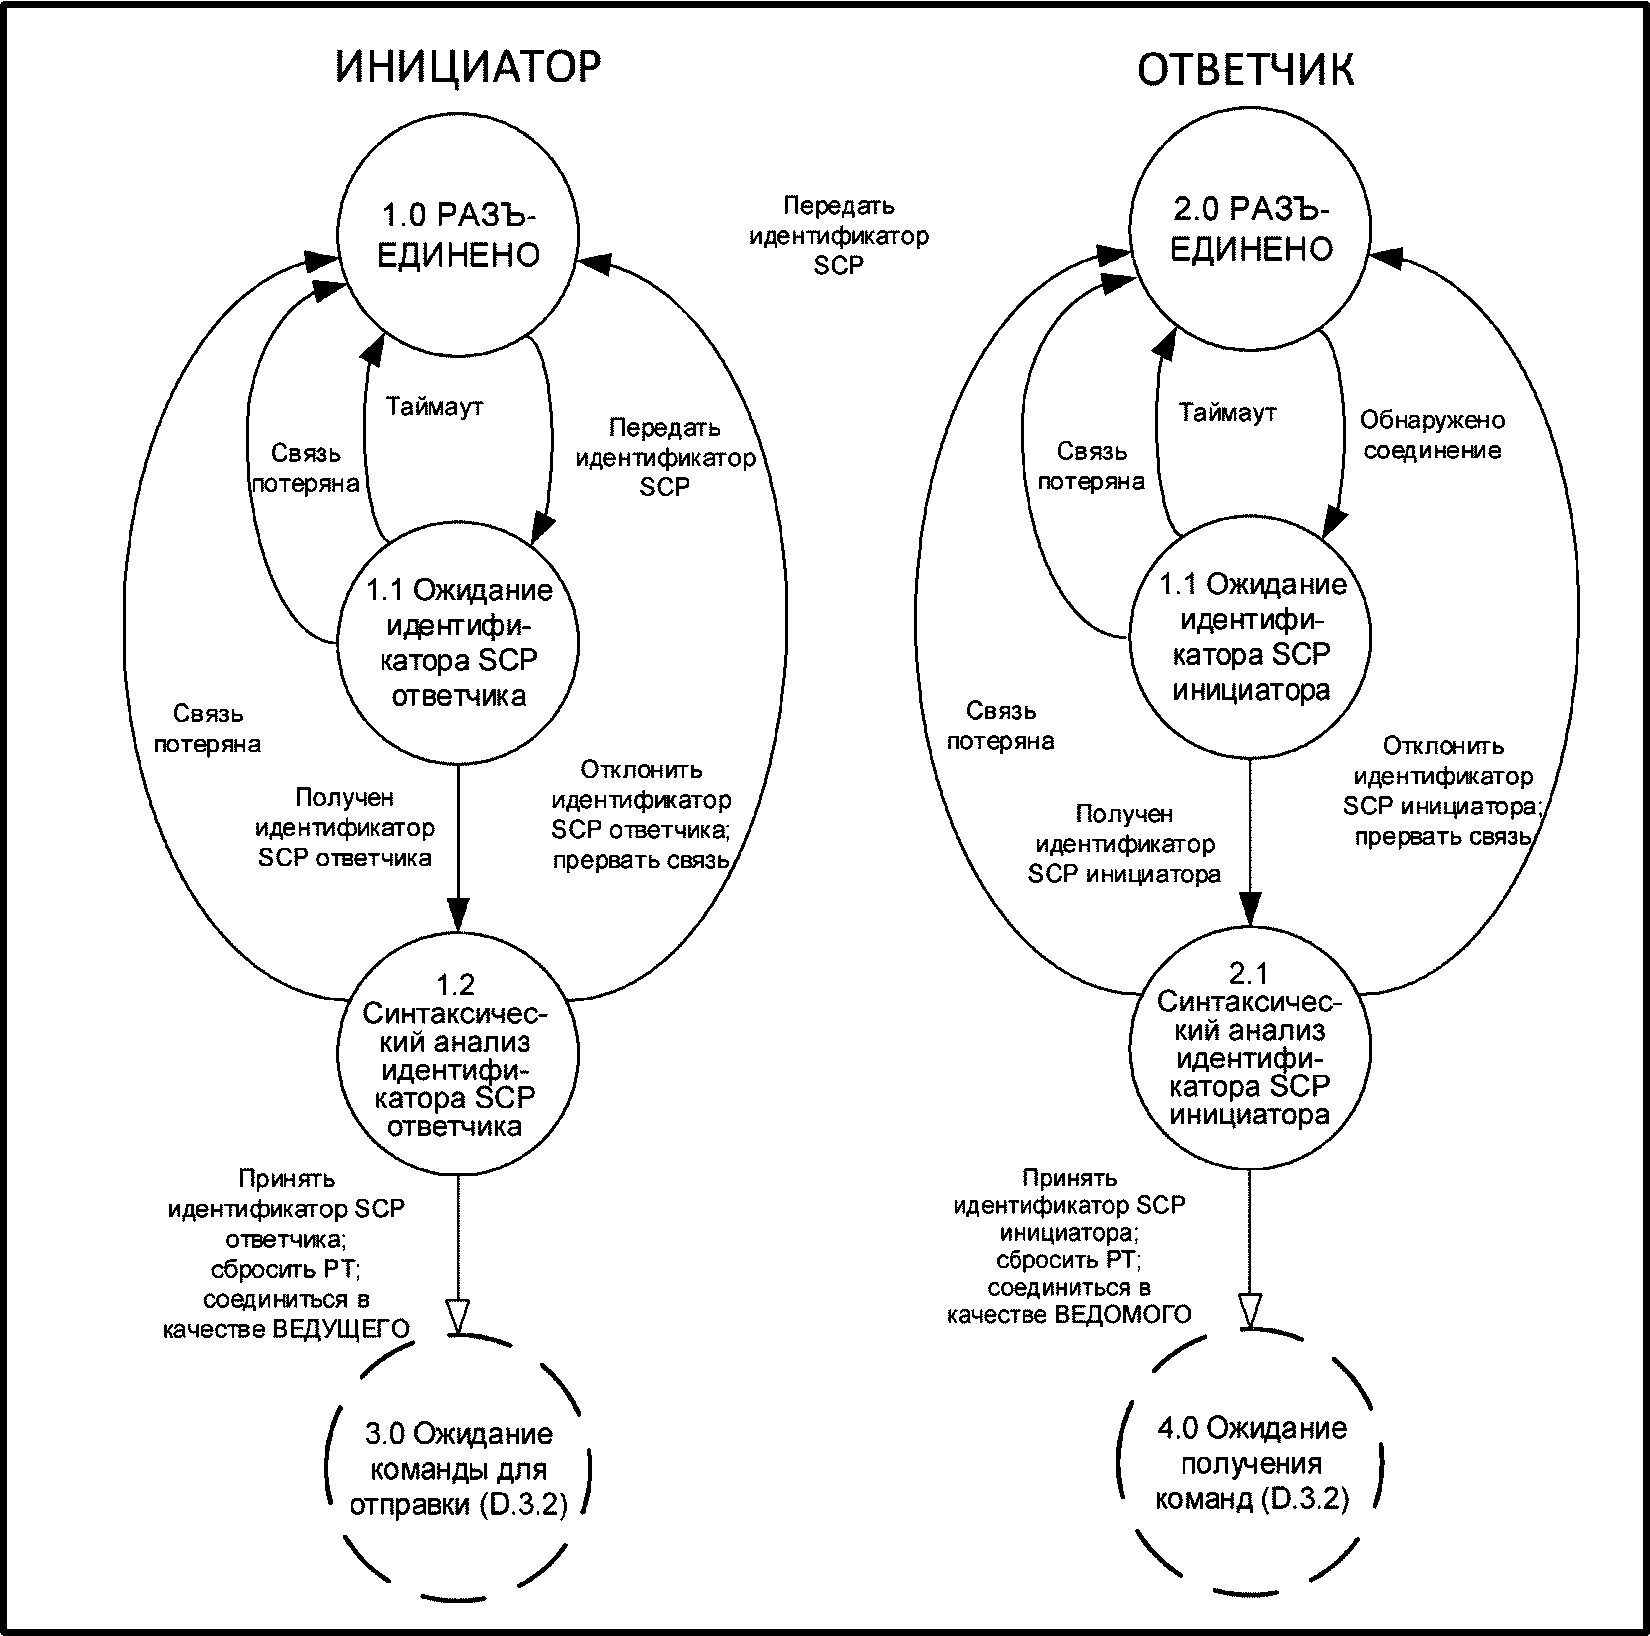
На диаграмме состояний, приведенной на рисунке D.2, показаны операции системы обмена сообщениями запросов, выполняемые после обмена идентифицирующими сообщениями в соответствии с D.3.1. В процессе работы устройство системы существует в одном из двух состояний: ведущее или ведомое. Ведущему устройству разрешено отправлять команды. Ведомое устройство может только отвечать на команды.
Сообщения и ответы, специфичные для производителя, не обязаны следовать этой диаграмме.
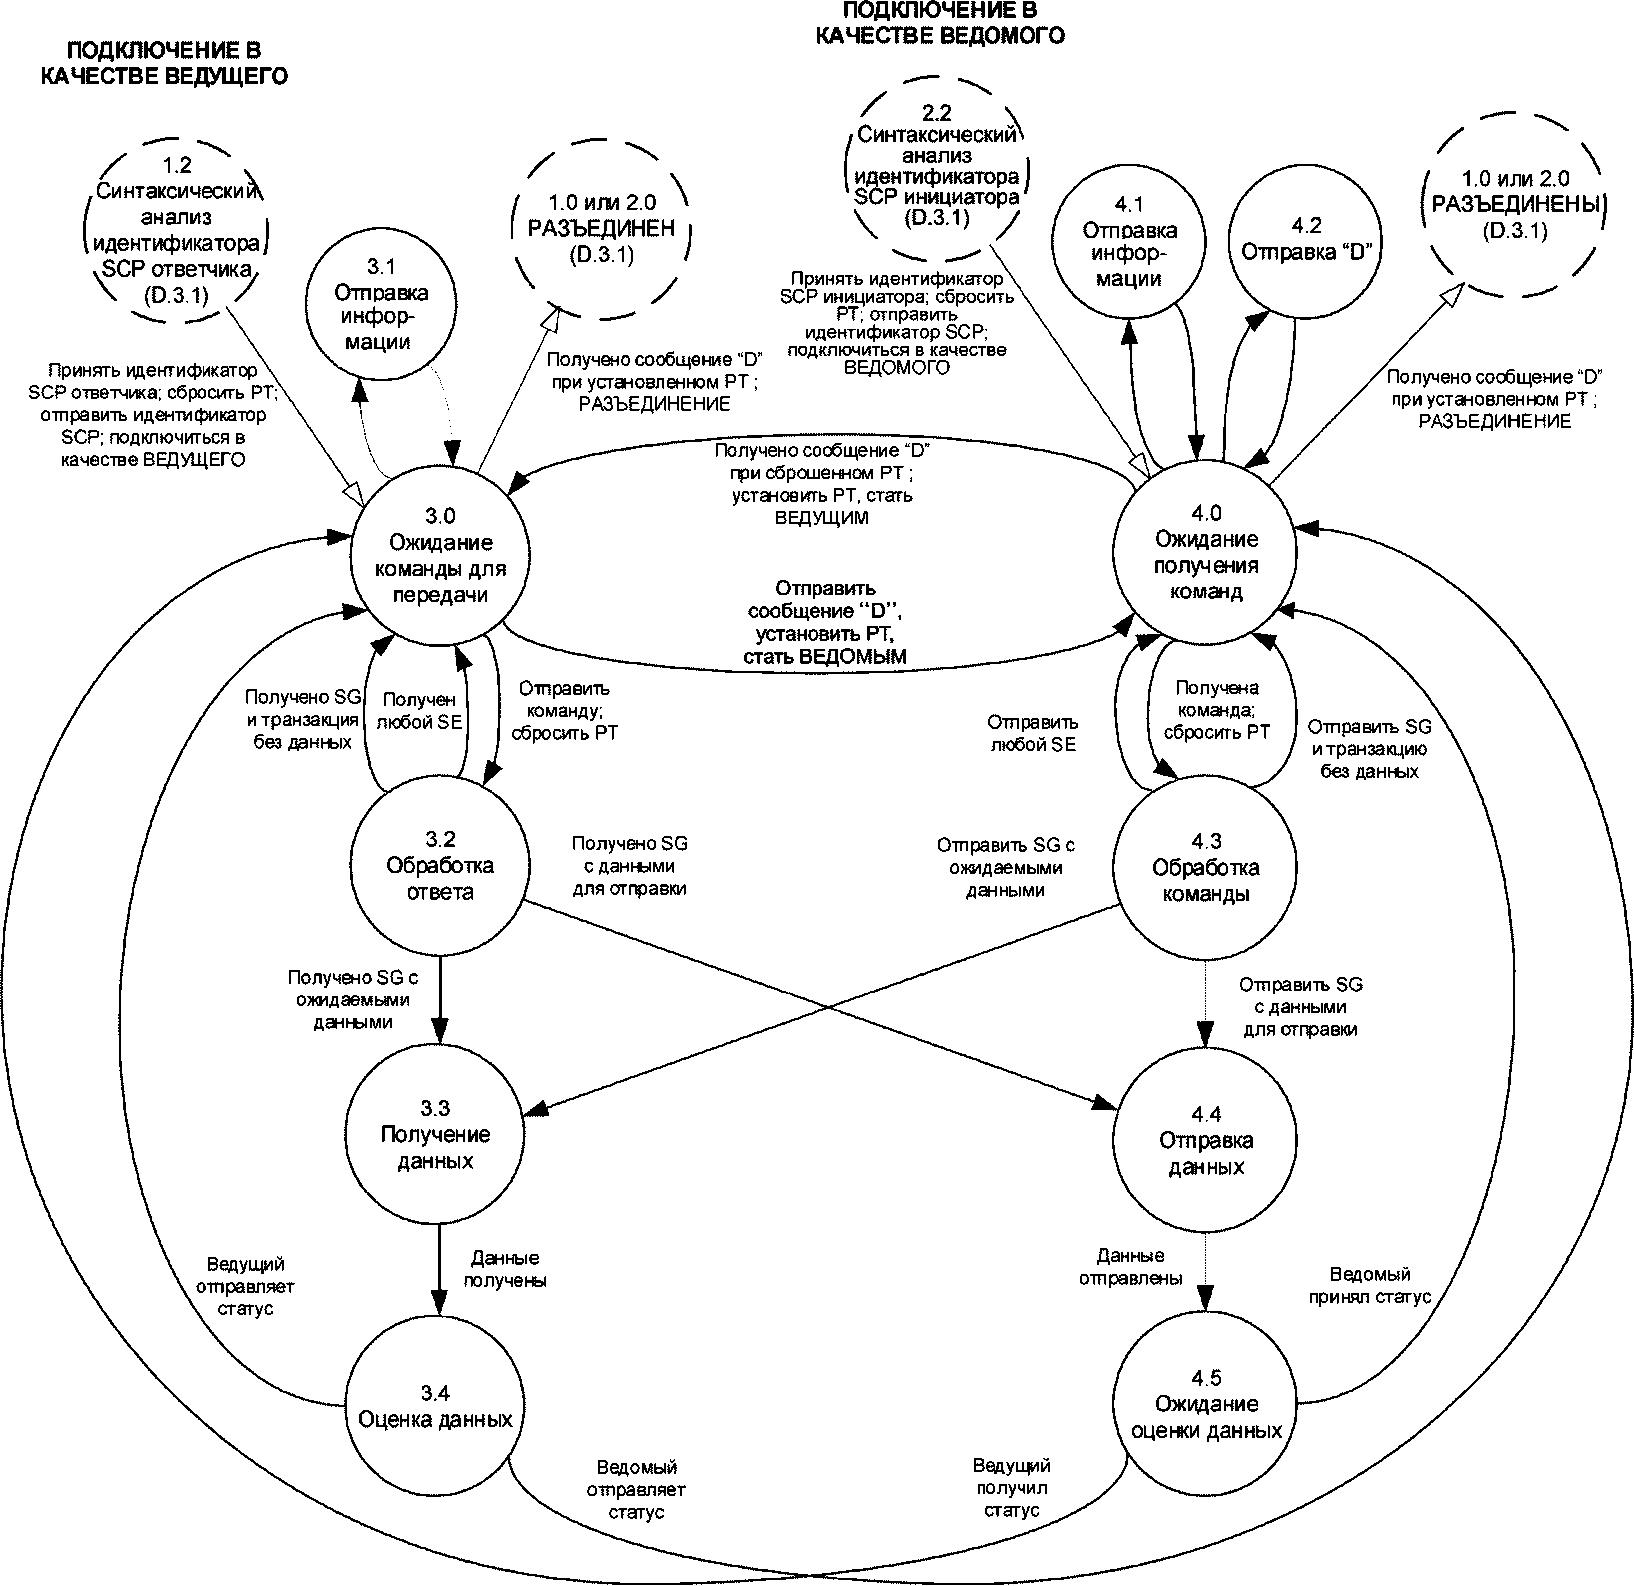
системы обмена сообщениями запросов
D.4 Примеры последовательности сообщений
D.4.1 Общие положения
В следующих примерах под "Данными ЭКГ" подразумевается файл данных, отформатированный в соответствии с SCP-ECG, а "Идентификационное", "Запрос", "Статус", "Выполнено" и "Информационное" означают сообщения SCP-ECG, определенные в D.2.
Нормальная последовательность сообщений для отправки инициатором ЭКГ ответчику имеет следующий вид:
Инициатор | Ответчик | Комментарий | |
a) | Идентификационное | Начало сеанса: обмен идентифицирующими данными с помощью сообщения типа "I". | |
b) | Идентификационное | ||
c) | Запрос | Инициатор запрашивает отправку ЭКГ (сообщение типа "R"). | |
Статус | Ответчик отвечает: готов принять (тип сообщения "S"). | ||
e) | Данные ЭКГ | Инициатор отправляет данные. | |
f) | Статус | Ответчик отвечает: принятые данные пригодны (см. примечание 1, подраздел D.4.5). | |
g) | Запрос | Инициатор отправляет другой запрос (см. примечание 2 подраздел D.4.5) [перейти к d) или к D.4.3 - D.4.5] | |
или | или | ||
Выполнено | сообщает, что "данных больше нет" (тип сообщения "D"). | ||
h) | Запрос | Ответчик отправляет свой собственный запрос (перейти к D.4.5) | |
или | или | ||
(выполнено) | прекращает вызов. |
Нормальная последовательность сообщений для запроса списка пациентов, соответствующих маске запроса, имеет следующий вид:
Инициатор | Ответчик | Комментарий | |
a) | Идентификационное | Начало сеанса: обмен идентифицирующими данными. | |
b) | Идентификационное | ||
c) | Запрос | Инициатор запрашивает список пациентов. | |
Статус | Ответчик возвращает ОК. Ответчик поддерживает соединение, пока запрос не будет обработан. | ||
e) | Запрос | Ответчик запрашивает отправку списка пациентов. | |
f) | Статус | Инициатор отвечает "готов принять". | |
g) | Данные | Ответчик отправляет список пациентов. | |
h) | Статус | Инициатор отвечает, что полученные данные пригодны (см. примечание 1 к D.4.5). | |
i) | Выполнено | Ответчик сообщает "данных больше нет". | |
j) | Запрос | ||
или | или | ||
Выполнено | сообщает "данных больше нет". | ||
k) | Запрос | Ответчик отправляет свой собственный запрос (перейти к D.4.5) | |
или | или | ||
(выполнено) | завершает вызов. |
Последовательность сообщений запроса у ответчика списка отчетов по ЭКГ, снятых для заданного пациента, имеет следующий вид:
Инициатор | Ответчик | Комментарий | |
a) | Идентификационное | Начало сеанса: обмен идентифицирующими данными. | |
b) | Идентификационное | ||
c) | Запрос | Инициатор запрашивает список ЭКГ. | |
Статус | Ответчик возвращает ОК. Ответчик поддерживает соединение, пока запрос не будет обработан. | ||
e) | Запрос | Ответчик запрашивает отправку списка ЭКГ. | |
f) | Статус | Инициатор отвечает "готов принять данные". | |
g) | Данные | Ответчик отправляет данные. | |
h) | Статус | Инициатор отвечает, что полученные данные пригодны (см. примечание 1 к D.4.5). | |
i) | Выполнено | Ответчик сообщает "данных больше нет". | |
j) | Запрос | ||
или | или | ||
Выполнено | сообщает "данных больше нет". | ||
k) | Запрос | Ответчик отправляет свой собственный запрос (перейти к D.4.5) | |
или | или | ||
(выполнено) | завершает вызов. |
Последовательность сообщений запроса у ответчика конкретного отчета или отчетов по ЭКГ, снятых для заданного пациента, имеет следующий вид:
Инициатор | Ответчик | Комментарий | |
a) | Идентификационное | Начало сеанса: обмен идентифицирующими данными. | |
b) | Идентификационное | ||
c) | Запрос | Инициатор запрашивает получение ЭКГ. | |
d) | Статус или | Ответчик возвращает статус "ошибка", если у него нет ЭКГ для отправки, | |
Запрос | или запрос на отправку ЭКГ. | ||
Статус | Инициатор отвечает "готов принять". | ||
f) | Данные ЭКГ | Ответчик отправляет данные. | |
Статус | Инициатор отвечает, что полученные данные пригодны (см. примечание 1). | ||
h) | Запрос | Ответчик отправляет еще один запрос [перейти к e)] (см. примечание 2) | |
или | или | ||
Выполнено | сообщает "данных больше нет". | ||
i) | Запрос | ||
или | или | ||
(выполнено) | завершает вызов. |
Примечания
1 Если принятые данные непригодны, то ответчик возвращает код ошибки (см. D.2.4). Затем инициатор переходит к g), чтобы повторно передать те же данные, другие (новые) данные или отправить статус "Выполнено".
2 С помощью этого механизма может быть передан "пакет" ЭКГ или "набор списков пациентов". См. также пример 2 в D.5.
В любой точке, приведенной выше последовательности, где может быть отправлено сообщение управления (идентификация, запрос, статус или "Выполнено"), могут быть дополнительно отправлены одно или несколько информационных сообщений. Информационное сообщение не оказывает никакого влияния на последовательности обработки. Оно позволяет предоставить дополнительную информацию оператору-человеку.
Передача информационного сообщения не приводит к смене ведущего и ведомого. По получении информационного сообщения вместо очередного сообщения управления получатель обрабатывает информационное сообщение (обычно отображая его оператору) и продолжает находиться в том же состоянии, ожидая сообщения управления, которое он рассчитывал получить до этого.
Ниже рассмотрены примеры использования информационных сообщений.
Пример 1
Инициатор | Ответчик | Комментарий | |
a) | Идентификационное | Начало сеанса: обмен идентифицирующими данными. | |
b) | Идентификационное | ||
c) | Запрос | Инициатор запрашивает отправку ЭКГ. | |
d) | Статус | Ответчик возвращает статус готовности к приему. | |
e) | Данные ЭКГ | Инициатор отправляет данные. | |
Информационное | "Значение по умолчанию для возраста пациента". | ||
Информационное | "Пожалуйста, подождите 30 секунд". | ||
f) | Статус | Ответчик сообщает, что полученные данные пригодны. | |
g) | Выполнено | Инициатор отвечает "данных больше нет". | |
h) | (выполнено) | Ответчик завершает вызов. |
Инициатор | Ответчик | Комментарий | |
a) | Идентификационное | Начало сеанса: обмен идентифицирующими данными. | |
b) | Идентификационное | ||
c) | Запрос | Инициатор запрашивает получение ЭКГ. | |
Информационное | "Отправка ЭКГ N 1 из 1 найденной". | ||
d) | Запрос | Ответчик запрашивает отправку ЭКГ. | |
e) | Статус | Инициатор возвращает статус готовности к приему. | |
f) | Данные ЭКГ | Ответчик отправляет данные. | |
g) | Статус | Инициатор сообщает, что полученные данные пригодны. | |
h) | Выполнено | Ответчик отвечает "запросов больше нет". | |
i) | (выполнено) | Инициатор завершает вызов. |
(справочное)
НИЗКОГО УРОВНЯ ДЛЯ ВЗАИМОДЕЙСТВИЯ УСТРОЙСТВА
КАРТИРОВАНИЯ ЭЛЕКТРОКАРДИОГРАММЫ С СЕРВЕРОМ
E.1 Общие положения
Низкоуровневый транспортный протокол, предназначенный для обмена ЭКГ между цифровыми устройствами картирования ЭКГ и компьютеризированными системами управления (хранения) ЭКГ, состоит из двух функциональных уровней:
- канальный уровень;
- физический уровень.
Коммуникации между двумя системами управления ЭКГ и коммуникации между этими системами и другими серверами не входят в рамки данной спецификации.
E.2 Функциональный канальный и физический уровни
В разделе E.3 приведено краткое описание минимальных требований для локального и дистанционного соединения и передачи данных, связанных с ЭКГ, позволяющих использовать малозатратные, высокоскоростные асинхронные модемы или простые локальные каналы RS-232-C. Выполнение этих требований должно гарантировать, что устройства, использующие данный стандартный протокол, способны взаимодействовать.
В разделе E.5 описаны методы, обеспечивающие синхронизацию двух взаимодействующих устройств и отсутствие искажений данных в процессе передачи. Настоящий стандарт описывает состояния, необходимые для обработки исключительных ситуаций.
При обмене данными между устройствами, в особенности сжатыми двоичными данными, которые особенно подвержены искажению из-за ошибок передачи, важно использовать некоторые устройства или программное обеспечение, позволяющие обеспечивать целостность данных и канала передачи данных. Такие устройства или программное обеспечение доступны во многих форматах, например, низкоуровневые сетевые протоколы, модемы с коррекцией ошибок и т.д. В данном приложении описан низкоуровневый протокол, который можно использовать в отсутствие какого-либо другого доступного или пригодного адекватного протокола.
Для облегчения понимания данного уровня в настоящее приложение включены диаграммы перехода состояний, алгоритм вычисления контрольной суммы каждого пакета данных и формат каждого определяемого блока данных. В целом этот канальный уровень является улучшением протокола XMODEM.
E.3.1 Общее описание
В данном разделе дано описание физического уровня стандартного протокола передачи ЭКГ. Приведены минимальные требования как для "локального", так и для "дистанционного" соединения. Локальные соединения определены как прямые соединения "точка-точка". Дистанционными являются те соединения, которые задействуют публичные коммутируемые телефонные сети или их эквивалент.
Отдельные производители могут принять решение о расширении приведенных здесь требований или об использовании других физических уровней. Описанные в данном приложении стандарты не усложняют разработку будущих систем и не приводят к деградации их производительности. Они предлагают общий интерфейс, обеспечивающий достаточные показатели эффективности при минимальной стоимости реализации и предоставляющий общий метод передачи ЭКГ между поставщиками.
E.3.2 Локальные соединения
Локальное соединение представляет собой канал RS-232-C, способный обеспечить следующие параметры:
9600 бод;
8 битов данных;
1 стоповый бит;
без бита четности.
E.4 Дистанционное соединение
Минимальным требованием для дистанционного соединения является модем V.22bis, официально разрешенный в стране использования. Стандарт V.22bis реализуется полнодуплексным асинхронным модемом 2400 бод. Функция обнаружения и коррекции ошибок по протоколу MNP level 5 не требуется, так как уровень обработки ошибок спроектирован для ее выполнения. Другие требования те же, что и для локальных соединений.
E.5.1 Общее описание
E.5.1.1 В данном разделе определен уровень коррекции ошибок и линии арбитража стандартного протокола передачи ЭКГ. Целью данного раздела является определение минимального стандарта, обеспечивающего коммуникации устройств картирования и систем разных производителей. Он не предназначен для определения или предложения метода коммуникаций между системами. Данный уровень протокола называется канальным уровнем.
Описанный здесь канальный уровень является модифицированной (расширенной) версией протокола XMODEM. Он легко реализуется с помощью "стандартных" асинхронных коммуникационных устройств и адекватен требованиям к производительности при передаче ЭКГ.
Эти требования отдельно рассмотрены в E.5.1.2 - E.5.1.6.
E.5.1.2 Таймауты были сокращены с 10 до 2,5 с (t1) и 3,5 с (t2), тем самым снижая время выполнения, когда производительность машины ниже оптимальной.
E.5.1.3 Временная задержка текста была введена, чтобы машина могла поддерживать соединение в отсутствие данных для отправки. Это обеспечивает поддержку ситуаций, в которых передающее устройство ожидает передачу блока данных, но данные не готовы из-за задержек обработки. При обычном протоколе XMODEM получатель, ожидающий данные, несколько раз прервется по таймауту, а затем отключит соединение.
E.5.1.4 Была добавлена способность передающего устройства запрашивать повторную передачу сообщения подтверждения самого последнего блока данных, чтобы учесть ситуацию, в которой управляющие символы ACK или NAK получателя были искажены. В стандартном протоколе XMODEM передающая станция просто повторно передает свой блок данных, что является потенциально долгим процессом.
E.5.1.6 Протокол позволяет "реверс канала", чтобы данные можно было передавать в обоих направлениях во время одного сеанса.
Ниже для идентификации участвующей станции два устройства именуются "передатчиком" и "приемником". Устройство, передающее данные или передавшее данные последним, является ведущим. Эти роли могут меняться во время сеанса коммуникации (см. также рисунок E.2).
Во время пребывания в каждом описанном ниже состоянии, за исключением TRANSMIT WAKE-UP и RECEIVE WAKE-UP, обе станции могут получать или передавать код завершения EOT. Возможность передачи и получения EOT в любой момент времени является необходимой для обработки аварийных завершений. Этот же механизм может использоваться для нормального завершения, поскольку на канальном уровне между этими двумя ситуациями нет различий.
E.5.2.1 Графическое представление передатчика см. на рисунках E.3 - E.5.
E.5.2.2 Передатчик имеет три состояния: TRANSMIT WAKE-UP (пробуждение для передачи), NO DATA WAIT (нет данных, ожидание) и WAIT FOR ACKNOWELDGE (ожидание подтверждения).
E.5.2.2.1 Состояние TRANSMIT WAKE-UP является начальным для вызывающего устройства. Предполагается, что отвечающее устройство отправит управляющий код ASCII "ENQ". По получении ENQ, если данные готовы к отправке, вызывающее устройство отправляет данные и переходит в состояние WAIT FOR ACK. Если по получении ENQ у этого устройства нет данных, готовых к передаче, то его текущим состоянием становится NO DATA WAIT. Если в течение одной минуты не получено ни одного управляющего кода ENQ, то процесс прекращается.
E.5.2.2.2 Состояние NO DATA WAIT. В данном состоянии передатчик ожидает данные для отправки. Это случается, когда станция передачи ждет блок данных для его передачи, но этот блок еще не был подготовлен приложением более высокого уровня. Данное состояние имеет таймаут, длящийся только 2,5 с.
Если таймер сработал через 2,5 с, то передатчик проверяет наличие данных. Если они существуют, то данные отправляются и текущим состоянием становится WAIT FOR ACK. Если данных нет, то отправляется временная задержка текста, чтобы предотвратить отключение принимающей станции по таймауту, а управление передатчиком сохраняется в состоянии NO DATA WAIT. Если данные становятся доступными до истечения 2,5 с, то они могут быть отправлены в соответствии с представленным выше описанием.
E.5.2.2.3 Состояние WAIT FOR ACK. В этом состоянии передатчик ожидает ответа от приемника на последний отправленный блок данных. Надлежащими ответами являются управляющие коды ACK или NAK.
E.5.2.2.3.1 Если получен управляющий код ACK и передатчик получил от прикладного уровня указание выполнить реверс канала, то он передает управляющий код ENQ и управление передатчиком переходит в состояние получения WAIT FOR TURNAROUND.
E.5.2.2.3.2 Если получен управляющий код ACK и передатчик не ожидает реверса, то он проверяет наличие данных для отправки. Если данные имеются, то они отправляются и передатчик остается в состоянии WAIT FOR ACK. Если доступных данных нет, то текущим состоянием становится NO DATA WAIT.
E.5.2.2.3.3 Если получен управляющий код NAK, то происходит повторная передача последнего блока данных. Состояние WAIT FOR ACK сохраняется. Если было последовательно получено 10 кодов NAK, то будет отправлен код завершения EOT с номером ошибки 006, и соединение прекращается.
E.5.2.2.3.4 Если ответ не пришел в течение 2,5 с, то происходит повторная передача последнего пакета. После десяти передач того же пакета без ответа отправляется код завершения EOT с номером ошибки 001, и соединение прекращается.
E.5.3.1 Графическое представление приемника см. на рисунках E.6 - E.9.
E.5.3.2 Приемник имеет четыре состояния: RECEIVE WAKE-UP (пробуждение для приема), WAIT FOR TURNAROUND (ожидание реверса канала), WAIT ON DATA (ожидание данных) и BAD DATA (плохие данные).
E.5.3.2.1 RECEIVE WAKE-UP. Это начальное состояние приемника. При пробуждении устройство передает управляющий код ENQ и переходит в состояние WAIT FOR TURNAROUND.
E.5.3.2.2 WAIT FOR TURNAROUND. В этом состоянии приемник ждет от передатчика передачи первого блока данных. Допустимы два варианта входной информации: блок данных или управляющий код TTD.
E.5.3.2.2.1 Если данные получены, то проводится проверка их правильности, основанная на номере блока и контрольной сумме. Если данные хорошие, то отправляется управляющий код ACK и текущим состоянием становится WAIT ON DATA. Если данные плохие, то отправляется NAK и приемник переходит в состояние BAD DATA.
E.5.3.2.2.2 Если принят управляющий код TTD, то не выполняется никаких действий (кроме перезапуска часов таймаута).
E.5.3.2.2.3 Если за 3,5 с не принято никаких данных, то осуществляется повторная передача управляющего кода ENQ. Если после отправки десяти кодов ENQ ответа нет, то соединение прерывается и отправляется управляющий код EOT с номером ошибки 002.
E.5.3.2.3 WAIT ON DATA. Это нормальное состояние приема. Приемник ждет получения блока данных от передатчика. Допустимы четыре вида входной информации: данные, управляющие коды TTD, SYN и ENQ. Недействительная входная информация отбрасывается.
E.5.3.2.3.1 Если получены данные, то проводится проверка их правильности, основанная на номере блока и контрольной сумме. Если данные хорошие, то отправляется управляющий код ACK, а машина остается в состоянии WAIT ON DATA. Если данные плохие, то отправляется управляющий код NAK и текущим состоянием становится BAD DATA.
E.5.3.2.3.2 Если только что полученный пакет совпадает с предыдущим, то отправляется управляющий код ACK, а полученный пакет отбрасывается. После приема десяти последовательных копий одного и того же пакета отправляется управляющий код EOT с номером ошибки 005 и соединение прекращается.
E.5.3.2.3.3 Если получен управляющий код TTD, то не предпринимается никаких действий (кроме перезапуска часов таймаута).
E.5.3.2.3.4 Если получен управляющий код SYN, то осуществляется повторная передача управляющего кода ACK и состояние WAIT ON DATA остается действительным.
E.5.3.2.3.5 Если получен управляющий код ENQ, то приемник готов стать передатчиком. Проверяется наличие данных для отправки. Если данных нет, то приемник становится передатчиком в состоянии NO DATA WAIT. Если данные имеются, то они отправляются и управление передается состоянию передачи WAIT FOR ACK.
E.5.3.2.3.6 Если в течение 3,5 с никакие данные не получены, то передается управляющий код NAK. Это гарантирует, что передатчик перешлет последний блок данных, если он был потерян. Код NAK отправляется вместо кода ACK, поскольку передача ACK может привести к потере данных, если передатчик отправил блок данных, который приемник не смог принять. Приемник переходит в состояние BAD DATA.
E.5.3.2.4 BAD DATA. После отправки управляющего кода NAK приемник ожидает в состоянии BAD DATA. Допустимой входной информацией являются данные, а также управляющие коды SYN и ENQ.
E.5.3.2.4.1 Если получены хорошие данные, то приемник отправляет управляющий код ACK и переходит в состояние WAIT ON DATA. Если данные плохие, то приемник отправляет управляющий код NAK. После отправки десяти кодов NAK подряд и получения еще одного блока плохих данных отправляется управляющий код EOT с номером ошибки 003 и соединение прекращается.
E.5.3.2.4.2 Если получен управляющий код SYN, то последний управляющий код NAK передается повторно. Состояние BAD DATA сохраняется.
E.5.3.2.4.3 Если за 3,5 с не приняты никакие данные, то передается управляющий код NAK. Если десять NACK были отправлены в связи с отсутствием входной информации, а не из-за плохих данных, то соединение прекращается и отправляется управляющий код EOT с кодом ошибки 004.
E.5.3.2.4.4 Если получен управляющий код ENQ, то приемник скоро станет передатчиком. Проверяется наличие данных для отправки. Если данных нет, то приемник становится передатчиком в состоянии NO DATA WAIT. Если данные имеются, то они отправляются и управление передается состоянию передачи WAIT FOR ACK.
E.5.4 Формат блоков данных
E.5.4.1 Управляющие коды должны передаваться следующим образом:
ENQ: | ENQ DC2, |
ACK: | ACK DC2, |
NAK: | NAK DC2, |
SYN: | SYN DC2, |
TTD: | CAN DC2, |
EOT: | EOT $FF CHAR CHAR CHAR DC2, |
где три символа (CHAR) являются цифрами в кодировке ASCII, означающими коды завершения, т.е. коды ошибок с 001 по 006, упомянутые в E.5.2 и E.5.3. При нормальном завершении должен отправляться код ошибки 000.
E.5.4.2 Блоки данных имеют следующий формат:
a) Сообщение: | SOH | |
Номер блока | (последовательно возрастает от 1 до 255, затем сбрасывается до 1) | |
255 - номер блока | (дополнение номера блока до единицы) | |
данные | (256 байтов данных) | |
CRCHI | ||
CRCLO | ||
b) Данные: | STX | |
Номер блока | (последовательно возрастает от 1 до 255, затем сбрасывается до 1) | |
255 - номер блока | (дополнение номера блока до единицы) | |
данные | (256 байтов данных) | |
CRCHI | ||
CRCLO |
Примечание - Для сообщений и блоков данных используется один и тот же счетчик номеров. Он должен прирастать для каждого экземпляра блока любого типа.
Алгоритм вычисления контрольной суммы CRC основан на полиноме CRC-CCITT (X16 + X12 + X5 + 1). Контрольная сумма CRC является 16-битовым числом, которому должно быть присвоено двоичное значение из всех единиц (FFFF hex) перед началом вычисления для каждого блока данных. CRC вычисляется для всего блока данных вплоть до самого значения CRC, как показано на рисунке E.1.
Область CRC
?
?<??????????????????????????????????????????????????>?
? ?
??????????????????????????????????????????????????????????????????????
? Тип ? Номер блока?255 - (номер? Данные ? CRCHI ? CRCLO ?
? сообщения ? ? блока) ? ? ? ?
??????????????????????????????????????????????????????????????????????
1 1 1 256 1 1
Рисунок E.1 - Обнаружение ошибок в соответствии с CRC-CCITT
Алгоритм CRC-CCITI описан ниже. Учтите, что все операции осуществляются над байтами.
A - новый байт;
B - временный байт;
CRCHI - старший байт (старший значащий) 16-битовой CRC;
CRCLO - младший байт (младший значащий) 16-битовой CRC.
START:
FOR A = FIRST_BYTE TO LAST_BYTE IN BLOCK DO:
A = A XOR CRCHI
CRCHI = A
SHIFT A RIGHT FOUR TIMES (ЗАПОЛНЕНИЕ НУЛЯМИ)
A = A XOR CRCHI {I J K L M N O P}
CRCHI = CRCLO {перестановка CRCHI, CRCLO}
CRCLO = A
ROTATE A LEFT 4 TIMES {M N O P I J K L}
B = A {сохранить во временном байте}
ROTATE A LEFT ONCE {N O P I J K L M}
A = A AND $1F {0 0 0 I J L L M}
CRCHI =A XOR CRCHI
A = B AND $F0 {M N O P 0 0 0 0}
CRCHI = A XOR CRCHI {завершить вычисление CRCHI}
ROTATE B LEFT ONCE {N O P 0 0 0 0 M}
B = B AND $ E0 {N O P 0 0 0 0 0}
CRCLO = B XOR CRCLO {завершить вычисление CRCLO}
DOEND;
FINISH
Последняя проверка CRC осуществляется с помощью добавления (конкатенации) CRCHI и CRCLO к концу потока данных. Контрольная сумма CRC, вычисленная для дополненного потока данных, должна быть нулевой, если данные были получены правильно.
E.5.6 Диаграммы переходов состояний (STD - State transition diagram)
E.5.6.1 Схема потоков данных (не STD)
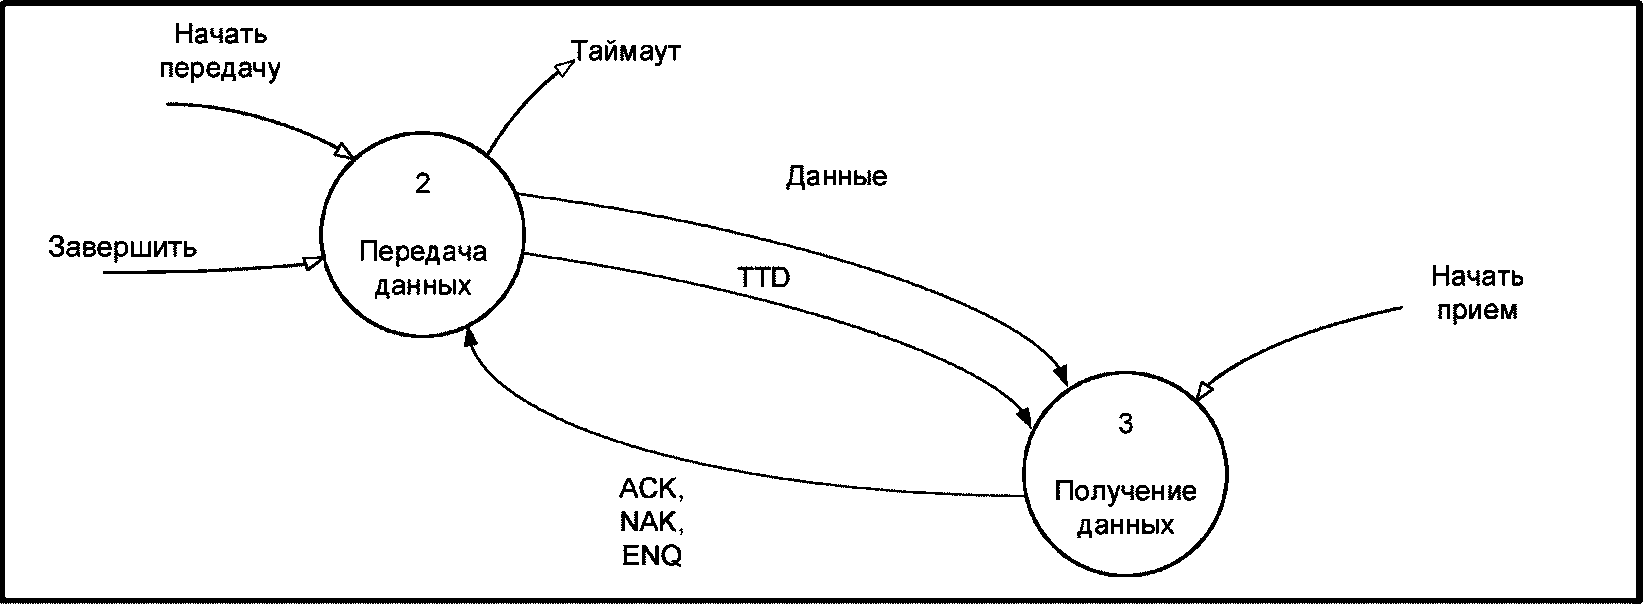
E.5.6.2 Диаграмма переходов состояний передатчика
E.5.6.3 Диаграмма переходов для состояния "Отсутствие данных, Ожидание"
Рисунок E.4 - Диаграмма переходов для состояния
"Отсутствие данных, Ожидание"
E.5.6.4 Диаграмма переходов для состояния "Ожидание ACK"
"Ожидание ACK"
E.5.6.5 Диаграмма переходов состояний приемника
E.5.6.6 Диаграмма переходов для состояния "Ожидание реверса канала"
Рисунок E.7 - Диаграмма переходов для состояния
"Ожидание реверса канала"
E.5.6.7 Диаграмма переходов для состояния "Ожидание данных"
Рисунок E.8 - Диаграмма переходов для состояния
"Ожидание данных"
E.5.6.8 Диаграмма переходов для состояния "Плохие данные"
"Плохие данные"
E.5.7 Сценарий коммуникаций
Сценарий, в котором электрокардиограф отправляет ЭКГ центральной системе управления ЭКГ
Устройство картирования (инициатор) | Система (ответчик) | Комментарий | |
a) | ENQ | Готовность к приему. | |
b) | SOH | Идентификация (вход в сеанс). | |
c) | ACK | Подтверждение. | |
d) | ENQ | Реверс канала. | |
e) | SOH | Идентификация (завершение входа в сеанс). | |
f) | ACK | Подтверждение. | |
g) | ENQ | Реверс канала. | |
h) | SOH | Устройство картирования запрашивает отправку ЭКГ. | |
i) | ACK | Подтверждение. | |
j) | ENQ | Реверс канала. | |
k) | SOH | Статус (система получила данные успешно). | |
l) | ACK | Подтверждение. | |
m) | ENQ | Реверс канала. | |
n) | STX | Передача ЭКГ. | |
o) | ACK | Подтверждение. | |
p) | STX | Данные ЭКГ. | |
... | |||
q) | ......................................... | Запись ЭКГ передана. | |
... | |||
r) | ACK | Подтверждение. | |
s) | ENQ | Реверс канала (выполняется после получения ЭКГ). | |
t) | SOH | Статус (система получила данные успешно). | |
u) | ACK | Подтверждение. | |
v) | ENQ | Реверс канала. | |
w) | SOH | Выполнено (больше данных нет). | |
x) | ACK | Подтверждение. | |
y) | ENQ | Реверс канала. | |
z) | SOH | Запрос (система может отправить свой собственный запрос) | |
или | или | ||
EOT | прекратить вызов (см. E.5.1.5). | ||
(справочное)
ОПИСАНИЙ ЭЛЕКТРОКАРДИОГРАММЫ
F.1 Общие положения
Универсальные коды интерпретации ЭКГ могут использоваться в дополнение к свободному тексту для обмена интерпретирующими описаниями между различными системами анализа ЭКГ, а также между такими системами и клиническими рабочими станциями и больничными информационными системами.
Общий набор кодов описаний является крайне важным для обмена сообщениями, интерпретирующими ЭКГ, в многоязычной среде. Он также является важным ресурсом для сжатия данных.
Эти коды могут использоваться в том числе для хранения предыдущих расшифровок, важного в силу юридических аспектов. Изменения, внесенные кардиологом в компьютерную интерпретацию, необходимо хранить. Они должны быть доступны врачам общей практики или другим специалистам, а также третьим сторонам.
F.2 Ограничения
Представленная ниже схема кодирования демонстрирует "прагматичный" подход к решению проблемы отображения компьютерных описаний на общепринятый и понятный лексикон. Предлагаются простые, базовые мнемокоды, их модификаторы и союзы, которые можно использовать для создания и отображения как простых, так и достаточно сложных интерпретирующих описаний ЭКГ.
Необходимо ясно понимать, что не предполагается, что компьютерные программы будут пытаться интерпретировать ЭКГ, используя все описания, перечисленные в данном приложении. Это выходит за рамки существующей технологии и даже желаний кардиологов. На самом деле, если используется только ЭКГ, то некоторые из описаний, перечисленных в данном приложении, трудно сделать объективными. При разработке настоящего стандарта не было желания давать оценку полезности или ограничений стандартной электрокардиографии. Тем не менее в данном приложении предпринята попытка дать достоверное представление о терминологии электрокардиографии и описаний ЭКГ, используемой в современной практике.
F.3 Создание кода и общие синтаксические правила
F.3.1 Общий принцип
Используются мнемокоды, которые широко используются в литературе и которые, вероятно, могут запомнить врачи, выполняющие расшифровку ЭКГ. Эти мнемокоды могут быть преобразованы в числовые коды для "внутреннего" использования в программе. Нельзя ожидать, что специалист по электрокардиографии, который лишь иногда имеет дело с компьютерными интерпретациями ЭКГ, запомнит шифры кодов или порой достаточно сложные мнемокоды, используемые в программах различных производителей.
Используя гибкую, но уникальную структуру кодов, можно добиться того, чтобы компьютер был способен получить хотя бы общее представление об изменениях, выполняемых читателями, не заставляя их оперировать числами. С другой стороны, довольно сложные конструкции, встречающиеся в свободном тексте описаний, интерпретируемых компьютером, могут быть с помощью акронимов и простых синтаксических правил преобразованы в универсально понимаемые коды описаний.
F.3.2 Базовая композиция кода
Универсальный код интерпретации SCP-ECG состоит из одного или нескольких полей. Принципиальных ограничений числа различных полей нет, разве что синтаксический анализ и формулировка интерпретирующего описания могут оказаться слишком долгими.
Первое поле (5 байтов) определяет базовую диагностическую интерпретацию или описательное утверждение.
Второе поле (1 или 2 байта) в основном используется для указания предполагаемой вероятности того, что описание правильное, или для определения степени вероятности.
Например,
A или DE - определенно; | D или CE - исключено/нельзя исключить; |
B или PR - вероятно; | SS - убедительный признак; |
C или PS - возможно; | CO - рассмотреть возможность; |
U или UN - неизвестно; | CW - согласуется. |
Второе поле может также использоваться для других целей.
Третье и другие поля (по 2 байта) используются для других модификаторов.
F.3.3 Модификаторы
Могут использоваться следующие модификаторы:
1) стадия развития инфаркта или ишемических изменений ST-T:
OL - рубцевание (old); | EV - развивающийся (evolving); |
RE - острейший (recent); | XO - вероятно, рубцевание (probably old); |
AC - острый (acute); | XA - вероятно, острый (острейший) [probably acute (recent)]; |
SU - подострый (subacute); | YO - предположительно рубцевание (possibly old); |
AI - стадия не определена (age indeterminate); | YA - предположительно острый (possibly acute); |
AU - вопрос о стадии открыт (age undeterminate); |
2) локализация ST-T и других патологических изменений:
AN - передний (anterior); | BA - базальный (basal); |
AS - переднеперегородочный (anteroseptal); | AF - передне-нижний (anteroinferior); |
AL - передне-боковой (anterolateral); | SE - септальный (septal); |
IN - нижний (inferior); | PL - задне-боковой (posterolateral); |
IL - нижне-боковой (inferolateral); | SN - субэндокардиальный (subendocardial); |
LA - боковой (lateral); | SP - субэпикардиальный (subepicardial); |
HL - высокий латеральный (high lateral); | EX - обширный (extensive); |
IP - нижне-задний (inferoposterior); | WI - распространенный (widespread); |
DI - диффузный (diffuse); |
3) степень тяжести патологического изменения, например, гипертрофии, нарушения проводимости или депрессии сегмента ST:
MA - значительная (major), MO - умеренная (moderate) и MI - легкая (minor).
Может использоваться другая схема кодирования, например, с S1 по S5, где степень S1 используется для указания легкой тяжести, а степень S5 представляет собой очень значительную тяжесть;
4) развивающийся характер или период действия некоторых патологических изменений:
SE - последовательные изменения, согласующиеся с... (serial changes consistent with...); | ||
CC - продолжающиеся изменения... (continuing changes of...); | ||
OC - редкие (occasional); | TR - кратковременные (transient); | UF - унифокальные (unifocal); |
IM - интермиттирующие (ntermittent); | FR - частые (frequent); | MF - мультифокальные (multifocal); |
TE - временные (temporary); | EV - развивающиеся (evolving); | NE - новые (new); |
MU - множественные (multiple); | ||
5) патофизиологический характер изменений ST-T:
LV - совместим с напряжением левого желудочка (compatible with left ventricular strain);
MD - совместим с ишемическим поражением миокарда (compatible with myocardial ischemic damage);
PE - совместим с перикардитом (compatible with pericarditis);
EL - совместим с электролитными аномалиями (compatible with electrolyte abnormalities);
6) нормальное или аномальное состояние:
NO - в пределах нормы (within normal limits);
NX - может быть вариантом нормы (may be normal variant);
BO - пограничное (borderline);
AB - аномальное (abnormal);
BN - пограничное нормальное (borderline normal);
BA - пограничное аномальное (borderline abnormal);
SI - синусовый (sinus);
AT - предсердный (atrial);
SV - суправентрикулярный (supraventricular);
ND - узловой (nodal);
VE - вентрикулярный (ventricular);
8) прочие термины:
IC - неполный (incomplete);
CP - полный (complete);
TY - типичный (typical);
YT - атипичный (atypical).
Примечание - AT означает "предсердный", см. перечисление 7) выше.
F.3.4 Разделители
1) Разные поля в описаниях кода разделяются с помощью нижнего подчеркивания, например, LVH_PR.
2) Основной диагностический код ставится первым. Модификатор достоверности или вероятности кода ставится вторым (как это показано в перечислении 1) (LVH_PR). Если программа или читатель не уверены в модификаторе, например касающемся стадии инфаркта или ишемических изменений ST-T, то к этому модификатору следует добавить модификатор достоверности, как это показано в следующих примерах:
AMI_PR_AC - вероятный острый передний инфаркт.
AMI_AC_PR - передний инфаркт, вероятно, острый.
AMI_PR_AC_PR - вероятный передний инфаркт, вероятно, острый.
Во втором случае предполагается (определенная) уверенность возникновения инфаркта, но неуверенность в его стадии.
3) Различные коды описаний отделяются друг от друга с помощью точки с запятой. Во время передачи данных перед описаниями идут порядковые номера (см. протокол SCP-ECG). Эти порядковые номера могут использоваться для соединения различных описаний, но для этой цели могут также использоваться термы связи.
F.3.5 Термы связи
Термы связи могут использоваться для связи описаний или для создания составных описаний.
1) Классические булевы операторы могут применяться как союзы, т.е.: AND, OR, NOT, XOR, EOR.
Союз NOT может использоваться для указания на то, что основное описание является истинным "в отсутствие" или "без" следующего описания;
2) Приведенные ниже арифметические операторы и операторы отношений могут использоваться как союзы:
ADD - сложить (+);
SUB - вычесть (-);
MPY - умножить (*);
DIV - разделить (/);
EXP - экспонента;
SQR - квадратный корень;
ABS - абсолютное значение;
MAX - максимальное значение;
MIN - минимальное значение;
EQU - равно;
ILT - меньше чем;
IGT - больше чем;
INE - равно;
IGE - больше или равно;
ILE - меньше или равно;
3) Термы связи для последовательного сравнения, например:
SER - последовательные изменения;
DEC - снижено (по сравнению с предыдущей записью);
INC - повышено (по сравнению с предыдущей записью);
UNC - неизмененное/не изменилось (по сравнению с предыдущей записью);
CHG - измененное/было изменено (по сравнению с предыдущей записью);
DIS - (теперь) исчезло (по сравнению с предыдущей записью);
REP - (теперь) заменено [(описание) было представлено ранее];
IMP - улучшено (по сравнению с);
WRS - ухудшено (по сравнению с);
4) Могут также использоваться другие термы связи, например:
RES - чтобы указать на то, что основное описание "приводит к" к (или "вызывает") следующее описание (results);
SEC - чтобы указать на то, что основное описание является "вторичным" по отношению к последующему описанию (secondary);
ASS - связано с (assotiated);
EXC - исключить, отклонить или учесть также следующее описание (exclude);
WTH - с (with);
ALT - является альтернативой для (alternating with).
Термы связи могут иметь максимальный размер 3 байта и ставятся между двумя точками с запятой для связи двух отдельных описаний.
Связывание термов связи в рамках составного описания выполняется с помощью нижнего подчеркивания (_).
F.4 Акронимы в интерпретирующих описаниях ЭКГ
F.4.1 Ссылки, используемые при детальной разработке этого предложения
Чтобы детально разработать данное предложение, рассматривались списки акронимов, встречающихся в интерпретирующих описаниях ЭКГ, выдаваемых различными компьютерными программами. Эти списки можно найти в пятом и восьмом Докладах о работе CSE (Canadian Society of Echocardiography - Канадское общество по электрокардиографии), а также в руководствах для врачей от нескольких производителей.
Кроме того, часто используются два отчета по "Стандартизации терминологии и интерпретации" и по "Определениям и классификации сердечной аритмии". Эти отчеты опубликованы в Amer. J. Cardiology (1978, 41, pp. 130 - 145) и в Amer. Heart J. (1978, 95, pp. 796 - 806) соответственно.
F.4.2 Акронимы
F.4.2.1 Нормальное/аномальное состояние
NORM | нормальная ЭКГ; |
NLECG | нормальная ЭКГ; |
NLQRS | нормальная QRS; |
NLP | нормальный P-зубец; |
NLSTT | нормальный ST-T; |
WHNOR | ЭКГ в рамках половозрастной нормы; |
POSNL | вероятно, нормальное ЭКГ; |
BOECG | пограничная ЭКГ; |
ABECG | анормальная ЭКГ; |
POSAB | вероятно, анормальная ЭКГ; |
ABQRS | анормальная QRS; |
ABSTT | анормальная ST-T; |
NFA | норма для возраста; |
NFB | норма для телосложения; |
ABFA | ненормально для возраста; |
ABFB | ненормально для телосложения; |
UFB | необычно для телосложения. |
F.4.2.2 Гипертрофия желудочка
LVH | гипертрофия левого желудочка (left ventricular hypertrophy); |
VCLVH | критерии вольтажа (QRS) для гипертрофии левого желудочка [voltage criteria (QRS) for left ventricular hypertrophy]; |
RVH | гипертрофия правого желудочка (right ventricular hypertrophy); |
VCRVH | критерии вольтажа (QRS) для гипертрофии правого желудочка [voltage criteria (QRS) for right ventricular hypertrophy]; |
BVH | бивентрикулярная гипертрофия (biventricular hypertrophy); |
SEHYP | септальная гипертрофия; |
PRANT | высокий зубец R в отведении V1 (prominent anterior forces). |
F.4.2.3 Инфаркт миокарда
(Локализация инфаркта преимущественно определяется базовым акронимом, но может также определяться с помощью модификатора локализации.)
MI | инфаркт миокарда (myocardial infarction); |
AMI | передний инфаркт миокарда (anterior myocardial infarction); |
ASMI | переднеперегородочный инфаркт миокарда (anteroseptal myocardial infarction); |
ALMI | инфаркт миокарда передне-боковой (anterolateral myocardial infarction); |
LMI | инфаркт миокарда боковой стенки левого желудочка (lateral myocardial infarction); |
HLMI | верхне-боковой инфаркт миокарда высокого отдела боковой стенки левого желудочка (high-lateral myocardial infarction); |
APMI | инфаркт миокарда верхушки левого желудочка (apical myocardial infarction); |
IMI | нижний диафрагмальный инфаркт миокарда (inferior myocardial infarction); |
ILMI | инфаркт миокарда задней и боковой стенок левого желудочка (inferolateral myocardial infarction); |
IPMI | заднедиафрагмальный инфаркт миокарда (inferoposterior myocardial infarction); |
IPLMI | инфаркт нижне-задне-боковой стенки левого желудочка (inferoposterolateral myocardial infarction); |
PMI | нижний инфаркт миокарда (posterior myocardial infarction). |
F.4.2.4 Нарушения проводимости
(Определения см. в J. Amer. Coll. Cardiol., 5, pp. 1261 - 1275, 1985.)
BBB | неуточненная блокада ножки пучка Гиса (unspecified bundle branch block); |
CLBBB | полная блокада ножки пучка Гиса (complete left bundle branch block); |
ILBBB | полная блокада ножки пучка Гиса (incomplete left bundle branch block); |
ALBBB | атипичная блокада ножки пучка Гиса (atypical left bundle branch block); |
CRBBB | полная блокада правой ножки пучка Гиса (complete right bundle branch block); |
IRBBB | неполная блокада правой ножки пучка Гиса (incomplete right bundle branch block); |
IVCD | неспецифическое нарушение внутрижелудочковой проводимости (блокада) [non-specific intraventricular conduction disturbance (block)]; |
IVCD> | нарушение внутрижелудочковой проводимости (QRS > 120 мс) [intraventricular conduction disturbance (QRS > 120 ms)]; |
IVCD< | незначительное нарушение внутрижелудочковой проводимости (QRS < 120 мс) [minor intraventricular conduction disturbance (QRS < 120 ms)]; |
WPW | синдром Вольфа - Паркинсона - Уайта (Wolf - Parkinson - White syndrome); |
WPWA | синдром Вольфа - Паркинсона тип A (Wolf - Parkinson type A); |
WPWB | синдром Вольфа - Паркинсона тип B (Wolf - Parkinson type B); |
PREEX | преждевременное возбуждение (pre-excitation); |
LAFB | блокада передней ветви левой ножки пучка Гиса (left anterior fascicular block); |
LPFB | блокада задней ветви левой ножки пучка Гиса (left posterior fascicular block); |
BIFAS | бифасцикулярная блокада (два компонента этой блокады всегда должны приводиться раздельно) [bifascicular block (its two components shall always be listed separately)]; |
TRFAS | трифасцикулярная блокада. |
F.4.2.5 Другая морфология QRS или обобщающие описания
COPD | ЭКГ, указывающая на хроническое обструктивное заболевание легких (ECG consistent with chronic obstructive pulmonary disease); |
PE | эмфизема легких (pulmonary emphysema); |
QWAVE | наличие Q-зубцов (Q waves present); |
POORR | малый прирост зубца R в грудных отведениях (poor R-wave progression in precordial leads); |
ABRPR | аномальный прирост зубца R (abnormal R-wave progression); |
PROMR | высокий зубец R в правых грудных отведениях (prominent R waves in right precordial leads); |
DXTRO | декстрокардия (dextrocardia); |
LVOLT | низкий вольтаж QRS в отведениях, расположенных во фронтальной и горизонтальной плоскости (low QRS voltages in the frontal and horizontal leads); |
HVOLT | высокий вольтаж QRS (high QRS voltage); |
LVOLF | низкий вольтаж в отведениях, расположенных во фронтальной плоскости (low voltage in frontal leads); |
LVOLH | низкий вольтаж QRS в отведениях, расположенных в горизонтальной плоскости (low QRS voltages in the horizontal leads); |
HVOLF | высокий вольтаж QRS в отведениях, расположенных во фронтальной плоскости (high voltage in frontal leads); |
HVOLH | высокий вольтаж QRS в отведениях, расположенных в горизонтальной плоскости (high QRS voltages in the horizontal leads); |
S1S23 | электрическая ось сердца по типу S1-S2-S3 (S1 S2 S3 type QRS pattern); |
RSR1 | комплекс типа rSr' в V1 или V2 (rSr' type in V1 or V2); |
TRNZL | смещение переходной области в грудных отведениях влево (transition zone in precordial leads displaced to the left); |
TRNZR | смещение переходной области в грудных отведениях вправо (transition zone in precordial leads displaced to the right); |
MYOPA | указывает на кардиомиопатию (compatible with cardiomyopathy); |
MYOCA | указывает на миокардит (compatible with myocarditis); |
CRIMA | критерии для (criteria for); |
CRIMO | умеренные критерии для (moderate criteria for); |
CRIMI | минимальные критерии для (minimal criteria for). |
F.4.2.6 Описания ритма
(Определения описаний ритма см. в Amer. Heart J., 95, pp. 796 - 806, 1978.)
Описания, связанные с формированием импульса (аномалиями):
SR | синусовый ритм (sinus rhythm); |
NSR | нормальный синусовый ритм (normal sinus rhythm); |
SARRH | синусовая аритмия (sinus arrhythmia); |
MSAR | выраженная синусовая аритмия (marked sinus arrhythmia); |
SVARR | суправентрикулярная аритмия (supraventricular arrhythmia); |
STACH | синусовая тахикардия (sinus tachycardia); |
ETACH | экстремальная тахикардия (extreme tachycardia); |
SBRAD | синусовая брадикардия (sinus bradycardia); |
EBRAD | экстремальная брадикардия (extreme bradycardia); |
JTACH | узловая тахикардия (junctional tachycardia); |
SVTAC | суправентрикулярная тахикардия (supraventricular tachycardia); |
JBRAD | узловая брадикардия (junctional bradycardia); |
SVBRA | суправентрикулярная брадикардия (supraventricular bradycardia); |
WQTAC | тахикардия с широкими комплексами QRS (wide QRS tachycardia); |
NQTAC | тахикардия с узкими комплексами QRS (narrow QRS tachycardia); |
TACHO | тахикардия, происхождение неизвестно или не указано (tachycardia, origin unknown or not specified); |
BRADO | брадикардия, происхождение неизвестно или не указано (bradycardia, origin unknown or not specified); |
ARRHY | аритмия, происхождение неизвестно (arrhythmia, origin unknown); |
IRREG | нерегулярный ритм (irregular rhythm); |
REGRH | регулярный ритм (regular rhythm); |
JESCR | замещающий узловой ритм (junctional escape rhythm); |
VESCR | замещающий желудочковый ритм (ventricular escape rhythm); |
ACAR | ускоренный предсердный ритм (accelerated atrial rhythm); |
ACVR | ускоренный желудочковый ритм (accelerated ventricular rhythm); |
ACJR | ускоренный узловой ритм (accelerated junctional rhythm); |
AVJR | атриовентрикулярный узловой ритм (AV-junctional rhythm); |
ARHYT | предсердный ритм (atrial rhythm); |
SVRHY | суправентрикулярный ритм (supraventricular rhythm); |
JRHYT | узловой ритм (junctional rhythm); |
VRHYT | желудочковый ритм (ventricular rhythm); |
UNRHY | неустановленный ритм (undetermined rhythm); |
EAR | эктопический предсердный ритм (ectopic atrial rhythm); |
LAR | левопредсердный ритм (left atrial rhythm); |
MAR | мультифокальный предсердный ритм (multifocal atrial rhythm); |
NODRH | атриовентрикулярный ритм (nodal rhythm); |
RAR | нижний правопредсердный ритм (low right atrial rhythm); |
LGL | синдром Лауна - Ганонга - Левина (Lown - Ganong - Levine syndrome); |
SHTPR | короткий PR-интервал (short PR-interval); |
AFIB | предсердная фибрилляция (atrial fibrillation); |
AFLT | трепетание предсердий (atrial flutter); |
ATACH | предсердная тахикардия (atrial tachycardia); |
PSVT | пароксизмальная суправентрикулярная тахикардия (paroxysmal supraventricular tachycardia); |
PAT | пароксизмальная предсердная тахикардия (paroxysmal atrial tachycardia); |
MFAT | мультифокальная предсердная тахикардия (multifocal atrial tachycardia); |
RATAC | пробежка предсердной тахикардии (run of atrial tachycardia); |
RJTAC | пробежка узловой тахикардии (run of junctional tachycardia); |
AVNRT | атриовентрикулярная узловая реципрокная тахикардия (atrioventricular nodal re-entrant tachycardia); |
AVRT | атриовентрикулярный реципрокная тахикардия (atrioventricular reciprocating tachycardia); |
IDIOR | идиовентрикулярный ритм (idioventricular rhythm); |
VFIB | фибрилляция желудочков (ventricular fibrillation); |
VTACH | желудочковая тахикардия (ventricular tachycardia); |
RVTAC | пробежка желудочковой тахикардии (run of ventricular tachycardia); |
SVT | стойкая желудочковая тахикардия (sustained ventricular tachycardia); |
NSVT | стойкая желудочковая тахикардия (non-sustained ventricular tachycardia); |
TORSA | полиморфная желудочковая тахикардия типа "пируэт" (torsade des pointes ventricular tachycardia); |
MTACH | мультифокальная тахикардия (полиморфная), суправентрикулярная или желудочковая [multifocal tachycardia (multiform), supraventricular or ventricular]; |
VFLT | трепетание желудочков (ventricular flutter); |
ASYST | асистолия. |
Дисфункция синусового узла, предсердные и атриовентрикулярные нарушения проводимости:
1AVB | AV-блокада первой степени (first degree AV block); |
2AVB | AV-блокада второй степени (second degree AV block); |
3AVB | AV-блокада третьей степени (third degree AV block); |
I2AVB | интермиттирующая AV-блокада второй степени (intermittent second degree AV block); |
A2AVB | чередующаяся AV-блокада второй степени (alternating second degree AV block); |
AVDIS | AV-диссоциация (AV-dissociation); |
WENCK | периоды Венкебаха (Wenckebach phenomenon); |
MOBI2 | AV блокада второй степени типа Мобитц 2 (Mobitz type 2 second degree AV block); |
SAR | остановка синусового узла (sinus arrest); |
SARA | остановка синусового узла с замещением на предсердный ритм (sinus arrest with atrial escape); |
SARSV | остановка синусового узла с замещением на суправентрикулярный ритм (sinus arrest with supraventricular escape); |
SARJ | остановка синусового узла с замещением на узловой ритм (sinus arrest with junctional escape); |
SARV | остановка синусового узла с замещением на желудочковый ритм (sinus arrest with ventricular escape); |
SABLK | синоаурикулярная блокада (sino-atrial block); |
SPAUS | синусовая пауза (sinus pause); |
WANDP | миграция водителя ритма (wandering pacemaker); |
LRR | длинный измеренный интервал R-R (long R-R interval measured); |
OCAP | периодический захват (occasional capture). |
Описания, связанные с аномалиями эктопического ритма:
PRC(S) | экстрасистола(ы) [premature complex(es)]; |
PAC или APC (APB) | предсердная экстрасистола (импульс) (не рекомендуется использовать APB) [atrial premature complex (beat) (use of APB is not recommended)]; |
BPAC | блокированное раннее предсердное сокращение (blocked premature atrial contraction); |
MAPCS | множественные ранние предсердные экстрасистолы (blocked premature atrial contraction); |
PVC или VPC (VPB) | желудочковая экстрасистола (импульс) (не рекомендуется использование VPB) [ventricular premature complex (beat) (use of VPB is not recommended)]; |
MVPCS | множественные желудочковые экстрасистолы (multiple premature ventricular complexes); |
RVPCS или RPVCS | пробежка желудочковых экстрасистол (run of ventricular premature complexes); |
RAPCS | пробежка предсердных экстрасистол (run of atrial premature complexes); |
RJPCS | пробежка узловых экстрасистол (run of junctional premature complexes); |
VIC | интерполированные желудочковые экстрасистолы (ventricular interpolated complexes); |
MVICS | множественные интерполированные желудочковые экстрасистолы (multiple interpolated complexes); |
MICS | множественные желудочковые экстрасистолы (multiple interpolated complexes); |
SVPC | суправентрикулярная экстрасистола (supraventricular premature complex); |
SVPCS | (множественные) суправентрикулярные экстрасистолы [(multiple) supraventricular premature complexes]; |
SVIC(S) | интерполированная суправентрикулярная экстрасистола(ы) [supraventricular interpolated complex(es)]; |
ABER(S) | аберрантная проводимость (aberrantly conducted complex); |
ABPCS | аберрантные экстрасистолы, источник неизвестен (aberrant premature complexes, origin unknown); |
ABSVC | аберрантный комплекс, вероятно, суправентрикулярного происхождения (aberrant complex, possibly supraventricular origin); |
ABSVS | аберрантные комплексы, вероятно, суправентрикулярного происхождения (aberrant complexes, possibly supraventricular origin); |
ABASH | аберрантные суправентрикулярные комплексы типа Ашмана (aberrant supraventricular complexes of the Ashman type); |
JPC(S) | узловая экстрасистола(ы) [junctional premature complex(es)]; |
MJPCS | множественные узловые экстрасистолы (multiple junctional premature complexes); |
PVPCS или PPVCS | парные желудочковые экстрасистолы (paired ventricular premature complexes); |
PAPCS | парные предсердные экстрасистолы (paired atrial premature complexes); |
PJPCS | парные узловые экстрасистолы (paired junctional premature complexes); |
OVPAC | периодические желудочковые комплексы, инициируемые кардиостимулятором (occasional ventricular paced complexes); |
ONPAC | периодические комплексы, не инициируемые кардиостимулятором (occasional non-paced complexes); |
VBIG | желудочковая бигеминия (ventricular bigeminy); |
ABIG | предсердная бигеминия (atrial bigeminy); |
SVBIG | суправентрикулярная бигеминия (supraventricular bigeminy); |
BIGU | бигеминальная картина (источник неизвестен, суправентрикулярная или желудочковая) [bigeminal pattern (unknown origin, SV or ventricular)]; |
FUSC(S) | сливной комплекс(ы) [fusion complex(es)]; |
CAPT(S) | комплекс(ы) захвата [capture complex(es)]; |
VEC(S) | замещающий желудочковый комплекс(ы) [ventricular escape complex(es)]; |
AEC(S) | замещающий предсердный комплекс(ы) [atrial escape complex(es)]; |
SVEC(S) | замещающий суправентрикулярный комплекс(ы) [supraventricular escape complex(es)]; |
JEC(S) | замещающий узловой комплекс(ы) [junctional escape complex(es)]; |
ESCUN | замещающий комплекс, источник неизвестен (escape complex, origin unknown); |
VPARA | желудочковая парасистолия (ventricular parasystole); |
APARA | предсердная парасистолия (atrial parasystole); |
VTRIG | желудочковая тригеминия (ventricular trigeminy); |
ATRIG | предсердная тригеминия (atrial trigeminy); |
SVTRI | суправентрикулярная тригеминия (supraventricular trigeminy); |
TRIGU | тригеминальная картина (источник неизвестен, суправентрикулярная или желудочковая) [trigeminal pattern (unknown origin, SV or ventricular)]; |
VQUAG | желудочковая квадригеминия (ventricular quadrigeminy); |
RECIP | реципрокный или возвратный импульс (reciprocal or re-entrant impulse). |
Описания, связанные с (предоминирующей) проводимостью и блокадой:
B2T1 | (предоминирующая) блокада типа 2:1 [(predominant) 2:1 block] |
B3T1 | (предоминирующая) блокада типа 3:1 [(predominant) 3:1 block] |
B4T1 | (предоминирующая) блокада типа 4:1 [(predominant) 4:1 block] |
B5T1 | (предоминирующая) блокада типа 5:1 [(predominant) 5:1 block] |
VARBL | вариабельная блокада (variable block); |
EXIBL | блокада выхода (exit block); |
ENTBL | блокада входа (entrance block); |
VABL | атриовентрикулярная блокада (ventriculo-atrial block); |
BLOCK | не специфицированная задержка или нарушение распространения импульса (unspecified delay or failure of impulse propagation); |
C2T1 | (преимущественная) проводимость типа 2:1 [(predominant) 2:1 conduction]; |
C3T1 | (преимущественная) проводимость типа 3:1 [(predominant) 3:1 conduction]; |
C4T1 | (преимущественная) проводимость типа 4:1 [(predominant) 4:1 conduction]; |
C5T1 | (преимущественная) проводимость типа 5:1 [(predominant) 5:1 conduction]; |
VARCO | вариабельная проводимость (variable conduction); |
SVR | медленный желудочковый ответ (slow ventricular response); |
IVR | иррегулярный желудочковый ответ (irregular ventricular response); |
RVR | быстрый желудочковый ответ (rapid ventricular response); |
WRV | значительная вариация желудочкового ответа (wide rate variation); |
AAVCO | ускоренная AV-проводимость (accelerated AV conduction); |
RETCO | ретроградная проводимость (retrograde conduction); |
ANTCO | антероградная проводимость (anterograde conduction); |
ORTCO | ортоградная проводимость (orthograde conduction); |
ABBCO | аберрантная проводимость (aberrant conduction); |
CONCO | скрытая проводимость (concealed conduction); |
AVREN | атриовентрикулярная узловая циркуляция (AV nodal re-entry); |
CONRE | внутренняя циркуляция возбуждения (concealed re-entry); |
RENTR | феномен циркуляции возбуждения (re-entry phenomenon); |
AECHO | возвращение импульса в камеру его возникновения: предсердие (return of impulse to its chamber of origin: the atrium); |
VECHO | возвращение импульса в камеру его возникновения: желудочек (return of impulse to its chamber of origin: the ventricle); |
FCOUP | фиксированный период между нормальным сокращением сердца и экстрасистолой (fixed coupling interval); |
VCOUP | вариабельный период между нормальным сокращением сердца и экстрасистолой (variable coupling interval). |
Типы кардиостимулятора и функция кардиостимулятора:
PACE | нормально функционирующий кардиостимулятор (normal functioning artificial pacemaker); |
PACEA | ритм кардиостимулятора со стимуляцией 100% (artificial pacemaker rhythm with 100% capture); |
PACEP | ритм кардиостимулятора с частичной стимуляцией (artificial pacemaker rhythm with partial capture); |
PACEF | ритм кардиостимулятора при фибрилляции или трепетании предсердий (artificial pacemaker rhythm with underlying atrial fib or flutter); |
PACED | ритм кардиостимулятора по требованию (demand pacemaker rhythm); |
PACEM | неисправный кардиостимулятор (malfunctioning artificial pacemaker); |
EPAVS | AV-последовательный электронный кардиостимулятор, нормальная стимуляция (electronic pacemaker AV sequential, normal capture); |
EPVC | электронный кардиостимулятор, желудочковая стимуляция (electronic pacemaker, ventricular capture); |
EPDM | электронный кардиостимулятор, режим работы по требованию (electronic pacemaker, demand mode); |
EPFC | электронный кардиостимулятор, неэффективная стимуляция (electronic pacemaker, failure to capture); |
EPFS | электрокардиостимулятор, нарушение управления (electronic pacemaker, failure to sense); |
EPARV | биполярный электронный кардиостимулятор на верхушке правого желудочка (bipolar electronic pacemaker at the apex of the right ventricle); |
EPU | однополярный электронный кардиостимулятор (unipolar electronic pacemaker); |
EPURV | однополярный электронный кардиостимулятор на верхушке правого желудочка (unipolar electronic pacemaker at the apex of the right ventricle); |
PAA | электронная предсердная кардиостимуляция (electronic atrial pacing); |
PAD | двухкамерная электронная кардиостимуляция (dual chamber electronic pacing); |
PAVA | электронная желудочковая кардиостимуляция с предсердным управлением (electronic ventricular pacing with atrial sensing); |
PADEM | кардиостимуляция по требованию, анализ собственных сокращений сердца (demand pacing, analysis based upon intrinsic complexes); |
OVPAC | периодические комплексы, инициированные желудочковой кардиостимуляцией (occasional ventricular paced complexes); |
ONPAC | периодические комплексы, не связанные с кардиостимуляцией (occasional non-paced complexes). |
Международная классификация типов кардиостимуляторов:
PAVVI | 3-й байт - стимулируемая камера: |
PAAAI | V - желудочек; A - предсердие; D - и то, и другое; |
PAVAT | 4-й байт - управляемая камера: |
PAVDD | V, A, D - так же, как и для PAAAI; O - без управления; |
PADVI | 5-й байт - реакция кардиостимулятора на управляющий импульс: |
PADDD | T - триггерный режим, I - ингибирование, D - двойное действие (триггерный режим стимуляции предсердия + ингибирование стимуляции желудочка или триггерный режим/ингибирование стимуляции предсердия + ингибирование стимуляции желудочка) [double (atrial triggered + ventricular inhibited or atrial triggered/inhibited + ventricular inhibited)]. |
Другие описания, связанные с ритмом:
ARATE | предсердный ритм (atrial rate); |
VRATE | желудочковый ритм (ventricular rate); |
RATE | ритм без указания, желудочковый или предсердный (но в основном желудочковый); |
RHY(T) | ритм (rhythm). |
F.4.2.7 Описание осей
LAD | отклонение электрической оси сердца влево во фронтальной плоскости (< - 30) [left axis deviation of QRS in frontal plane (< - 30)]; |
RAD | отклонение электрической оси сердца вправо, во фронтальной плоскости (> + 90) [right axis deviation of QRS in frontal plane (> + 90)]; |
AXL | ось отклонена влево (т.е. недостаточно существенно для классификации LAD) [leftward axis (i.e. not severe enough to be called LAD)]; |
AXR | ось отклонена вправо (т.е. недостаточно существенно для классификации RAD) [rightward axis (i.e. not severe enough to be called RAD)]; |
AXIND | ось QRS не определяется (QRS axis indeterminate); |
AXSUP | отклонение оси вперед (axis shifted superiorly); |
AXPOS | отклонение оси назад (axis shifted posteriorly); |
AXVER | ось вертикальна во фронтальной плоскости (axis vertical in frontal plane); |
AXHOR | ось горизонтальна во фронтальной плоскости (horizontal axis in frontal plane); |
TRSLT | смещение переходной области в горизонтальных отведениях влево (transition in horizontal leads shifted leftward); |
TRSRT | смещение переходной области в горизонтальных отведениях вправо (transition in horizontal leads shifted rightward); |
CCWRT | вращение против часовой стрелки [counterclockwise (anticlockwise) rotation]; |
CWRT | вращение по часовой стрелке (clockwise rotation). |
F.4.2.8 Описания ST-T
Предлагаются следующие базовые корни:
ISC_ | ишемия (ischemic); |
INJ_ | субэндокардиальное повреждение (subendocardial injury); |
EPI_ | эпикардиальное повреждение (epicardial injury); |
STT_ | изменение ST-T (ST-T change); |
NST_ | неспецифические изменения ST (non-specific ST changes); |
STE_ | неспецифическое повышение ST (non-specific ST elevation); |
STD_ | неспецифическая депрессия ST (non-specific ST depression); |
RST_ | реципрокные изменения ST-T (reciprocal ST-T changes); |
TAB_ | аномалия зубца T (T-wave abnormality); |
NT_ | неспецифические изменения зубца T (non-specific T-wave changes). |
Для указания локализации изменений ST-T могут использоваться два решения - добавить модификатор локализации либо расширить корень двумя дополнительными символами, указывающими область, что выполняется следующим образом:
ишемические изменения ST-T: | ||
ISCAN | в передних отведениях (in anterior leads); | |
ISCAL | в передне-боковых отведениях (in anterolateral leads); | |
ISCIN | в нижних отведениях (in inferior leads); | |
ISCAS | в переднеперегородочных отведениях (in anteroseptal leads); | |
ISCLA | в боковых отведениях (in lateral leads); | |
ISCPO | в задней области (in posterior region); | |
ISCIP | в нижне-задней области (in inferoposterior region); | |
ISCIL | в нижне-боковых отведениях (in inferolateral leads); | |
ISCAF | в передне-нижних отведениях (in anteroinferior leads); | |
ISCWI | распространенные ишемические изменения ST-T (widespread ischemic ST-T changes); | |
ISCDI | диффузные ишемические изменения ST-T (diffuse ischemic ST-T changes); | |
ишемические изменения ST-T, совместимые с субэндокардиальным повреждением: | ||
INJAN | в передних отведениях (in anterior leads); | |
INJAL | в передне-боковых отведениях (in anterolateral leads); | |
INJIN | в нижних отведениях (in inferior leads); | |
INJAS | в переднеперегородочных отведениях (in anteroseptal leads); | |
INJLA | в боковых отведениях (in lateral leads); | |
INJPO | в задней области (in posterior region); | |
INJIP | в нижне-задней области (in inferoposterior region); | |
INJIL | в нижне-боковых отведениях (in inferolateral leads); | |
INJAF | в передне-нижних отведениях (in anteroinferior leads); | |
INJWI | распространенное субэндокардиальное повреждение (widespread subepicardial injury); | |
INJDI | диффузное субэндокардиальное повреждение (diffuse subepicardial injury); | |
ST-T изменения, совместимые с субэпикардиальным повреждением: | ||
EPIAN | в передних отведениях (in anterior leads); | |
EPIAL | в передне-боковых отведениях (in anterolateral leads); | |
IPIIN | в нижних отведениях (in inferior leads); | |
EPIAS | в переднеперегородочных отведениях (in anteroseptal leads); | |
EPILA | в боковых отведениях (in lateral leads); | |
EPIPO | в задней области (in posterior region); | |
EPIIP | в нижне-задней области (in inferoposterior region); | |
EPIIL | в нижне-боковых отведениях (in inferolateral leads); | |
EPIAF | в передне-нижних отведениях (in anteroinferior leads); | |
EPIWI | распространенное субэпикардиальное повреждение (widespread subepicardial injury); | |
EPIDI | диффузное субэпикардиальное повреждение (diffuse subepicardial injury); | |
неспецифические изменения ST-T: | Альтернатива: | |
NSTAN | в передних отведениях (in anterior leads) | STNAN |
NSTAL | в передне-боковых отведениях (in anterolateral leads) | STNAL |
NSTIN | в нижних отведениях (in inferior leads) | STNIN |
NSTAS | в переднеперегородочных отведениях (in anteroseptal leads) | STNAS |
NSTLA | в боковых отведениях (in lateral leads) | STNLA |
NSTPO | в задней области (in posterior region) | STNPO |
NSTIL | в нижне-боковых отведениях (in inferolateral leads) | STNIL |
NSTAF | в передне-нижних отведениях (in anteroinferior leads) | STNAF |
NSTWI | распространенные неспецифические изменения ST-T (widespread non-specific ST-T changes) | STNWI |
NSTDI | диффузные неспецифические изменения ST-T (diffuse non-specific ST-T changes) | STNDI |
неспецифический подъем ST: | ||
STExx | заменить xx на соответствующее отведение или локализацию, например, AN; | |
неспецифическое снижение ST: | ||
STDxx | заменить xx на соответствующее отведение или локализацию, например, AL; | |
другие описания ST-T: | ||
NDT | недиагностические аномалии T (non-diagnostic T abnormalities); | |
TNOR | вариации нормального зубца T (normal T-wave variations); | |
DIG | эффект дигиталиса (digitalis-effect); | |
HTVOL | высокий вольтаж зубцов T (high T-voltages); | |
QUIN ST-T | изменения ST-T, вызванные действием хинидина (ST-T changes due to quinidine-effect); | |
PERIC ST-T | изменения ST-T, совместимые с перикардитом (ST-T changes compatible with pericarditis); | |
STVAG | подъем ST в отведениях V1 - V3, вероятно, связанный с повышенным тонусом блуждающего нерва (ST-elevation V1 - V3 possibly due to enhanced vagal tone); | |
LNGQT | длинный QT-интервал (long QT-interval); | |
SHTQT | короткий QT-интервал (short QT-interval); | |
HIGHT | высокая амплитуда зубцов T (high amplitude T-waves); | |
LOWT | низкая амплитуда зубцов T (low amplitude T-waves); | |
INVT | инвертированные зубцы T (inverted T-waves); | |
HPOCA | предположительно гипокальцемия (consider hypocalcemia); | |
HPOK | предположительно гипокалиемия (consider hypokalemia); | |
HPRCA | предположительно гипокальцемия (consider hypocalcemia); | |
HPRK | предположительно гипокалиемия (consider hypokalemia); | |
STDJ | узловая депрессия ST (junctional ST depression); | |
REPOL | изменения ST-T, совместимые с ранней реполяризацией (ST-T changes compatible with early repolarization); | |
ANEUR | изменения ST-T, совместимые с аневризмой желудочка (ST-T changes compatible with ventricular aneurysm); | |
POSTO | послеоперационные изменения (post-operative changes); | |
PULM | совместимы с легочной эмболией (compatible with pulmonary embolism); | |
ACET | связано с работой кардиостимулятора (related to pacemaker activity); | |
NDOC | совместимы с эндокринным заболеванием (compatible with endocrine disease); | |
METAB | вероятно, связано с метаболическими изменениями (possibly due to metabolic changes); | |
IBP | совместимы с гипертензией (compatible with hypertension); | |
CONG | на фоне врожденного порока сердца (secondary to congenital heart disease); | |
VALV | на фоне порока клапана сердца (secondary to valvular heart disease); | |
RESP | на фоне заболевания органов дыхательной системы (secondary to respiratory disease); | |
JUV | ювенильные зубцы T (juvenile T waves); | |
CLIN | интерпретация с привлечением клинических данных (interpret with clinical data); | |
MYOIN | предположительно инфаркт миокарда (локализация не указана) [suggests myocardial infarction (no location specified)]; | |
ISDIG | совместимы с ишемией/эффектом дигиталиса (compatible with ischemia/digitalis effect); | |
STNOR | вариация нормы (normal variant); | |
STPAC | проверить анализ ST-T на предмет эффектов кардиостимуляции (review ST-T analysis for the effects of pacing); | |
STPVC | постэкстрасистолические изменения зубца T (post-extrasystolic T-wave changes). | |
F.4.2.9 Описания, относящиеся к предсердиям
LAO/LAE | перегрузка/расширение левого предсердия (left atrial overload/enlargement); |
RAO/RAE | перегрузка/расширение правого предсердия (right atrial overload/enlargement); |
BAO/BAE | перегрузка/расширение обоих предсердий (bi-atrial overload/enlargement); |
IACD | задержка проведения в предсердии (intra-atrial conduction delay); |
HPVOL | высокий вольтаж зубцов P (high P-voltages); |
NSPEP | неспецифические аномалии зубца P (non-specific P wave abnormalities); |
ABPAX | аномальная ось P (abnormal P-axis); |
UNPAX | необычная ось P (unusual P-axis). |
F.4.2.10 Описания, связанные с педиатрическим анализом ЭКГ
PED | педиатрическая интерпретация (pediatric interpretation); |
RVD | доминирование правого желудочка (right ventricular dominance); |
ASD | изменения, совместимые с дефектом межпредсердной перегородки типа ostium secundum [changes compatible with atrial septal defect (ostium secundum)]; |
ECD | изменения, совместимые с атриовентрикулярным септальным дефектом (ASD ostium primum) [compatible endocardial cushion defect (ASD ostium primum)]; |
EBSTA | изменения, совместимые с аномалией Эбштейна; |
TCA | изменения, совместимые с атрезией трехстворчатого клапана; |
ACA | изменения, совместимые с аномальной локализацией коронарной артерии. |
F.4.2.11 Описания, относящиеся к калибровке ЭКГ
HSCAL | все отведения калибруются на половинном уровне от стандартного напряжения (т.е. 5 мм/мВ) [all leads half standard calibration (i.e. 5 mm/mV)]; |
HSPRE | грудные отведения калибруются на половинном уровне от стандартного напряжения (precordial leads half standard calibration); |
HSLIM | калибровка отведений на конечностях на половинном уровне от стандартного напряжения (limb leads half standard calibration); |
DSCAL | все отведения калибруются на двойном уровне стандартного напряжения (т.е. 20 мм/мВ) [all leads double standard calibration (i.e. 20 mm/mV)]; |
DSPRE | калибровка грудных отведений на двойном уровне стандартного напряжения (precordial leads double standard calibration); |
DSLIM | калибровка отведений на конечностях на двойном уровне стандартного напряжения (limb leads double standard calibration); |
NSCAL | нестандартная калибровка (non-standard calibration). |
F.4.2.12 Технические проблемы
ARMRE | вероятно, электроды рук перепутаны (suspect arm leads reversed); |
LMISP | неправильное наложение электродов (lead misplacement); |
QCERR | низкое качество данных, интерпретация может пострадать (poor data quality, interpretation may be adversely affected); |
AHERR | ошибка снятия/аппаратных средств (acquisition/hardware error); |
MEASE | возможна ошибка измерений (possibly measurement error); |
NOISE | запись с шумами (noisy recording); |
WANDR | волнистая изолиния (baseline wander); |
FAULT | неисправный электрод (faulty lead); |
ARTEF | артефакты (artifacts); |
SIMUL | входная информация поступает от симулятора или тестового шаблона (input is from simulator or test pattern); |
PINFO | несогласованные или ошибочные демографические данные пациента (inconsistent or erroneous patient demographic data); |
INCAN | неполный анализ или отсутствие анализа (выполняемого программой) [incomplete or no analysis (by the program)]; |
NODAT | потеря или отсутствие данных (missing or no data). |
F.4.3.1 Описание "Вероятный старый передний инфаркт и фибрилляция предсердий" должно кодироваться следующим образом: AMI_OL_PR; AFIB. Описание AFIB не имеет прямой связи с AMI, поэтому союз AND не используется. В действительности имеется два независимых описания, одно - для контура QRS и одно - для сердечного ритма.
F.4.3.2 Описание "Вероятная гипертрофия левого желудочка с изменениями ST-T, совместимыми с напряжением левого желудочка" кодируется следующим образом: LVH_PR_AND_STT_LV. Знаки нижнего подчеркивания до и после союза AND указывают на то, что этот союз используется в одном описании.
F.4.3.3 Если такое же описание написано на двух отдельных строках и их необходимо логически связать, т.е.:
- вероятная гипертрофия левого желудочка,
- изменения ST-T, указывающие на гипертрофию левого желудочка,
то кодирование выполняется следующим образом: LVH_PR;AND;STT_LV.
F.5 Расшифровка результатов измерений
F.5.1 Обозначения зубцов и сегментов
P | зубец P; |
P + | зубец P, положительный компонент; |
P - | зубец P, отрицательный компонент; |
PA | зубец реполяризации предсердий; |
Q | зубец Q, т.е. первый отрицательный зубец комплекса QRS; |
R | зубец R, т.е. первый положительный зубец комплекса QRS; |
S | зубец S, т.е. первый отрицательный зубец после первого положительного зубца комплекса QRS; |
R2 | второй зубец R, т.е. первый положительный зубец комплекса QRS после зубца S; |
S2 | второй зубец S; |
R3 | третий зубец R в комплексе QRS; |
S3 | третий зубец S в комплексе QRS; |
J | точка J; |
ST | сегмент ST; |
ST20 | амплитуда ST 20 мс после точки J; |
ST60 | амплитуда ST 60 мс после точки J; |
ST80 | амплитуда ST 80 мс после точки J; |
STO | амплитуда ST в начале ST, т.е. точка J; |
STM | амплитуда ST в середине ST; |
STE | амплитуда ST в конце ST, т.е. в начале зубца T; |
T | зубец T; |
T + | (максимальный) положительный компонент зубца T; |
T - | (максимальный) отрицательный компонент зубца T; |
U | зубец U; |
QRS | комплекс QRS; |
QR | комплекс QRS типа QR; |
QS | комплекс QRS типа QS; |
RS | комплекс QRS типа RS; |
RSR | комплекс QRS типа RSR2; |
PR | интервал PR; |
PP | интервал PP; |
RR | интервал RR; |
QT | интервал QT; |
JT | интервал между точкой J и концом зубца T; |
TP | интервал между концом зубца T и следующего зубца P; |
ARP | абсолютный рефракторный период; |
ERP | эффективный рефракторный период; |
RRP | относительный рефракторный период; |
FRP | функциональный рефракторный период. |
F.5.2 Обозначения отведений
a) Обозначения отведений см. в 5.6 "Определение отведения ЭКГ - раздел 3".
b) Приведенные ниже условные обозначения отведений должны использоваться наиболее часто:
D1 | aVR | V1 | V4 | X |
D2 | aVL | V2 | V5 | Y |
D3 | aVF | V3 | V6 | Z |
ИС NORMPROD: примечание. Обозначение пунктов дано в соответствии с официальным текстом документа. |
d) Дополнительные сокращения:
LEAD | отведение; |
INN | указание локализации, например "в отведении D3", обозначается как INN_D3; |
AXIS | ось. |
Примечание - сокращение INN используется вместо сокращения IN, которое зарезервировано для "inferior" (нижний).
F.5.3 Единицы измерения
DUR | длительность; |
MSEC | миллисекунды; |
SEC | секунда(ы); |
AMP | амплитуда; |
MVOLT | милливольт; |
MUVLT | микровольт; |
DEGR | градусы; |
RATIO | отношение, например, отношение амплитуд Q/R; |
UNIT | единицы измерения без знака. |
F.5.4 Примеры
ИС NORMPROD: примечание. Текст дан в соответствии с официальным текстом документа. |
В большинстве случаев используются достаточно простые единичные или составные интерпретирующие описания ЭКГ, например показанные в F.4.3, но могут создаваться и более сложные описания, подобные показанным ниже. Следует отметить, что эти сокращения и соглашения о создании описаний предназначены обеспечения взаимодействия разнородных систем, а каждый производитель систем может продолжать использование собственных сокращений для внутренних целей.
P_AMP_INN_LEAD_V1_EQU_120_MVOLT
Амплитуда зубца P в отведении V1 составляет 120 милливольт.
Q_DUR_INN_LEAD_D3_EQU_40_MSEC
Длительность зубца Q в отведении D3 составляет 40 миллисекунд.
RATIO_Q_AMP_DIV_R_AMP_INN_D2_IGT_0.5
Отношение Q/R в отведении D2 превышает 0,5.
(S_AMP_INN_V1_ADD_R_AMP_INN_V5)_IGT_3.5_MVOLT
Сумма амплитуды зубца S в отведении V1 и амплитуды зубца R в отведении V5 превышает 3,5 милливольта (т.е. индекс Соколова положительный).
(MAX_R_AMP_ADD_MAX_S_AMP)_INN_V_LEADS_IGT_4.5_MVOLT
Сумма максимальной амплитуды зубца R и максимальной амплитуды зубца S в прекордиальных отведениях превышает 4,5 милливольта.
(справочное)
Необходимыми условиями для понимания читателем данного стандарта коммуникационного протокола компьютерной электрокардиографии являются базовые знания электрокардиографии и компьютерных технологий. Поэтому в данном словаре представлены только те термины, которые выходят за рамки базовых названий и определений, используемых в этих областях знаний.
Кодирование амплитуды
Последний из трех шагов преобразования аналогового сигнала в цифровой. Для экономии памяти последовательность целочисленных значений, создаваемая на шаге квантования, может кодироваться (например, методом Хаффмана, первая разность).
Квантование амплитуды
Второй из трех шагов преобразования сигнала из аналогового в цифровой. Амплитуда каждого считывания округляется до целого кратного фиксированному значению, которое выбирается достаточно "малым" по сравнению с представляемыми деталями исходного сигнала.
Аналого-цифровое преобразование
Процесс приближения, в котором непрерывный сигнал преобразуется в цифровое представление. Степень приближения должна гарантировать сохранность всей полезной информации исходного сигнала.
Фильтр артефактов
Фильтр, удаляющий артефакты из сигнала ЭКГ.
Фильтр изолинии
Фильтр, удаляющий низкочастотные колебания или дрейф из сигнала ЭКГ.
Данные цикла
Данные, относящиеся к морфологическим характеристикам одиночных циклов ЭКГ.
Коэффициент сжатия
Соотношение занимаемой памяти перед сжатием данных и после него.
Сжатие данных
Любой метод, удовлетворяющий общей цели сокращения размера заданного набора данных. Алгоритмы, как правило, используют особенности характеристик сжимаемого сигнала, например, алфавитно-цифровых данных, оцифрованных сигналов или оцифрованных изображений.
Прореживание
Процесс выбора меньшего количества считываний из упорядоченного набора (см. приложение C).
Опорная точка
Точка отсчета в сигнале ЭКГ.
Метод кодирования Хаффмана
Метод кодирования, в котором коды переменной длины используются таким образом, что наиболее часто возникающие данные получают самые короткие коды.
Необратимое сжатие данных
Сжатие данных необратимо, если возможность реконструкции исходного сигнала в тот вид, в котором он был до сжатия, потеряна.
Низкоуровневый транспортный протокол
Детально описанная процедура, используемая в отсутствие других методов обеспечения целостности данных и канала обмена данными во время коммуникаций между двумя цифровыми машинами.
Фильтр высоких частот
Фильтр, удаляющий компоненты входного сигнала, частота которых превышает заданную частоту.
Заграждающий фильтр
Фильтр, который должен удалять компонент входного сигнала, имеющий определенную частоту, как правило, 50 Гц или 60 Гц, т.е. частоту сети переменного тока.
Импульсы кардиостимулятора
Импульсы кардиостимулятора, наложенные на ЭКГ.
Тег
Число, используемое для идентификации определенного элемента данных.
Считывание по таймеру
Первый из трех шагов преобразования сигнала из аналогового в цифровой, т.е. дискретные считывания непрерывного сигнала с определенной частотой.
Преобразование/обратное преобразование
Сигнал может быть представлен в виде взвешенной суммы ортогональных функций. Этот набор весов или коэффициентов известен как отображение сигнала в заданную область. Взвешенная сумма этих сигналов известна как обратное преобразование. Нередко представление, обработка или сжатие сигналов упрощаются, если они осуществляются над их преобразованиями.
Другие специальные термины, используемые в настоящем стандарте, см. в разделе 3.
(справочное)
ДОКУМЕНТОВ НАЦИОНАЛЬНЫМ СТАНДАРТАМ
Таблица ДА.1
Обозначение ссылочного международного документа | Степень соответствия | Обозначение и наименование соответствующего национального стандарта |
ISO/IEC 646 | NEQ | ГОСТ 27463-87 "Система обработки информации. 7-битные кодированные наборы символов" |
ISO/IEC 2022:1994 | - | <*> |
ISO/IEC 4873 | - | <*> |
ISO/IEC 8859-1 | - | <*> |
JIS X 0201-1976 | - | <*> |
JIS X 0208-1997 | - | <*> |
Примечание - В настоящей таблице использовано следующее условное обозначение степени соответствия стандарта: - NEQ - неэквивалентный стандарт. | ||
Национальные и международные стандарты | |||||
[1] | ANSI-AAMI EC18-1982, American National Standard for Diagnostic Electrocardiographic Devices | ||||
[2] | ANSI-AAMI EC12-1983, American National Standard for Pregelled Disposable Electrodes | ||||
[3] | ANSI-AAMI SCL12-78, American National Standard for Safe Current Limits for Electromedical Apparatus | ||||
[4] | ANSI X3.4-1986, 7-bit American National Standard Code for Information Interchange | ||||
[5] | CCITT Blue Book, ed. 1988, Volume VIII.2, Recommendations for X.25 and Specifications for the CCITT-CRC Calculations | ||||
IEC 60601-1:2005, Medical electrical equipment - Part 1: General requirements for basic safety and essential performance | |||||
[7] | HL7 aECG Implementation Guide, Final, March 21, 2005 | ||||
[8] | IEC 60601-2-25, Medical electrical equipment - Part 2: Particular requirements for the safety of electrocardiographs | ||||
[9] | IEC 62D(CO)6, Performance Requirements for Single Channel and Multichannel Electrocardiographs | ||||
[10] | ISO/IEC 2375, Information technology - Procedure for registration of escape sequences and coded character sets | ||||
[11] | ISO/IEC 10646, Information technology - Universal Multiple-Octet Coded Character Set (UCS) | ||||
ISO/IEC 6429, Information technology - Control functions for coded character sets | |||||
[13] | ISO/IEEE 11073-10101, Health informatics - Point-of-care medical device communication - Part 10101: Nomenclature | ||||
[14] | JIS X 0202, Code Extension Techniques for Use with the Code for Information Interchange | ||||
[15] | JIS X 0212-1990, Code of the Supplementary Japanese Graphic Character Set for Information Interchange | ||||
[16] | GB2312-80, Code of Chinese Graphic Character Set for Information Interchange - Primary Set References from the ECG standards literature | ||||
Ссылки на литературу из библиографии стандартов по ЭКГ | |||||
[17] | BAILEY J.J., BERSON A.S., GARSONA. et al. Recommendations for standardization and specifications in automated electrocardiography: bandwidth and digital signal processing, Circulation 81, pp. 730 - 739, 1990 | ||||
[18] | MACFARLANE P.W. and LAWRIE T.D.V. (Eds). Comprehensive Electrocardiology. Theory and Practice in Health and Disease, Volume 1 - 3, Pergamon Press, Oxford, 1989. | ||||
[19] | PIPBERGER H.V., ARZBAECHER B., BERSON A.S. et al. Recommendations for standardization of leads and of specifications for instruments in electrocardiography and vectorcardiography, Circulation 52 (August Suppl), pp. 11 - 31, 1975 | ||||
[20] | ROBLES DE MEDINA E.O., BERNARD R., COUMEL P. et al. Definition of terms related to cardiac rhythm, A special report of the WHO/ISC Task Force ad Hoc. Am. Heart J., 95, pp. 796 - 806, 1978 | ||||
[21] | SURAWICZ B., UHLEY H., BORUN R. et al. Standardization of terminology and interpretation, Report of Task Force I on Optimal Electrocardiography, Bethesda Conference, 1977. Am. J. Cardiol., 41, pp. 130 - 145, 1978 | ||||
[22] | The CSE Working Party, Recommendations for measurement standards in quantitative electrocardiography, Eur. Heart J., 6, pp. 815 - 825, 1985 | ||||
[23] | VAN BEMMEL J.H. and WILLEMS J.L. Standardization and validation of medical support-systems: The CSE Project, Meth. Inform. Med. 29 (special issue), pp. 261 - 262, 1990 | ||||
[24] | WILLEMS J.L. SCP-ECG Project Manager. Standard Communications Protocol for Computerized Electrocardiography. Final Specifications and Recommendations, Final Deliverable AIM Project # A1015. Leuven: ACCO Publ., Jan. 31, 1991 (ISBN-90-73402-01-7) | ||||
[25] | WILLEMS J.L., ABREU-LIMA C., ARNAUD P. et al. The diagnostic performance of computer programs for the interpretation of the electrocardiogram. N. Engl. J. Med. 325, pp. 1767 - 1773, 1991 | ||||
[26] | WILLEMS J.L., ARNAUD P., VAN BEMMEL J.H. et al. A reference database for multilead electrocardiographic computer measurement programs, JACC, 6: pp. 1313 - 1321, 1987 | ||||
| |||||
[27] | WILLEMS J.L., ARNAUD P., VAN BEMMEL J.H. et al. Assessment of the performance of electrocardiographic computer programs with the use of a reference database, Circulation 71: pp. 523 - 5234, 1985 | ||||
[28] | WILLEMS J.L., ARNAUD P., VAN BEMMEL J.H. et al. Establishment of a reference library for evaluating computer ECG measurement programs, Comput. Biomed. Res. 18, pp. 439 - 457, 1985 | ||||
[29] | WILLEMS J.L., ROBLES DE MEDINA E.O., BERNARD R. et al. Criteria for intraventricular conduction disturbances and pre-excitation, JACC, 5, pp. 1261 - 1275, 1985 | ||||
[30] | WILLEMS J.L., ZYWIETZ C., ARNAUD P. et al. Influence of noise on wave boundary recognition by ECG measurement programs. Recommendations for preprocessing, Comput. Biomed. Res., 20, pp. 543 - 562, 1987 | ||||
[31] | ZYWIETZ C., WILLEMS J.L., ARNAUD P. et al. Stability of computer ECG amplitude measurements in the presence of noise, Comp. Biomed. Res., 23, pp. 10 - 31, 1990 Specific references with respect to ECG data compression | ||||
Источники, посвященные сжатию данных ЭКГ | |||||
[32] | ABENSTEIN J. and TOMPKINS W. A new data reduction algorithm for real-time ECG analysis, IEEE Trans. Biomed. Eng., 29/1, pp. 43 - 48, 1982 | ||||
[33] | AHMED N., MILNE P.J. and HARRIS S.G. Electrocardiographic data compression via orthogonal transforms, IEEE Trans. Biomed. Eng., 22, pp. 484 - 487, 1975 | ||||
[34] | BEDINI R., FRANCHI D., GENERALI G.L. and SEVERI S. Performance evaluation and choice of criteria for data compression algorithms by extensive tests on the CSE database, Computers in Cardiology, MURRAY A., ed., IEEE Computer Society, Los Alamitos, pp. 403 - 406, 1990 | ||||
[35] | BERTINELLI M., CASTELLI A., COMBI C. and PINCIROLI F. Some experiments on ECG data compression in the presence of arrhythmias, IEEE 1988 | ||||
[36] | CAPPELLINI V., DEL RE E., EVANGELISTI A. and PASTORELLI M. Application of digital filtering and data compression to ECG processing, Digest of the 11th Internat. Conf. on Med. and Biol. Engineering, Ottawa 1976, pp. 32 - 33 | ||||
[37] | COX J.R., NOLLE F.M., FOZZARD H.A. and OLIVER G.G., AZTEC, a preprocessing program for realtime ECG rhythm analysis, IEEE Transactions Biomed. Engin., 15, pp. 128 - 129, 1968 | ||||
[38] | FURTH B. and PEREZ A. An adaptive real-time ECG compression algorithm with variable threshold, IEEE Transact, on Biomed. Eng., 35/6, pp. 489 - 494, 1988 | ||||
[39] | ISHIJIAMA M., SHIN S., HOSTETTER G. and SKLANSKY J. Scan-along polygonal approximation for data compression of electrocardiograms, IEEE Transact. Biomed. Engin., 30/11, pp. 723 - 729, 1983 | ||||
[40] | JAYANT N.S. and NOLL P., eds. Digital Coding of Waveforms, Prentice-Hall, Englewood Cliffs, 1984 | ||||
[41] | KARLSSON S. Representation of ECG records by  expansions, Digest of the 7th Internat. Conf. on Med. and Biol. Engineering, 1967, p. 105 | ||||
[42] | KUKLINSKI W.S. Fast Walsh transform data-compression algorithm: ECG application, Med. Biol. Eng. Comput., 21, pp. 465 - 472, 1983 | ||||
[43] | HSU K., WOMBLE M.E., TOLAN G.D. and ZIED A.M. Simultaneous noise filtering and data compression of ECGs, Proc. 18th Int. ISA Biomed. Sci. Instr. Symp., 1981, pp. 47 - 52 | ||||
[44] | HUFFMAN D.A. A method for the construction of minimum-redundancy codes, Proc. IRE, 40, pp. 1098 - 1101, 1952 | ||||
[45] | LAMBERTI C. and COCCIA P. ECG data compression for ambulatory device, in Computers in Cardiology, RIPLEY K.L., ed., IEEE Computer Society, Washington DC, pp. 171 - 178, 1988 | ||||
[46] | LEE H., CHENG Q. and THAKOR N. ECG waveform analysis by significant point extraction, Comp. Biomed. Research, 20, pp. 410 - 427, 1987 | ||||
[47] | MOODY G.B., SOROUSHIAN K. and MARK R.G. ECG Data compression for tapeless ambulatory monitors, in Computers in Cardiology, RIPLEY K.L., ed. IEEE Computer Society, Los Alamitos, pp. 467 - 470, 1987 | ||||
[48] | MOODY G.B. and MARK R.G. QRS morphology representation and noise estimation using the  transform, in Computers in Cardiology, RIPLEY K.L., ed. IEEE Computer Society, Los Alamitos, pp. 269 - 272, 1989 | ||||
[49] | MUELLER W.C. Arrhythmia detection program for an ambulatory ECG monitor, Biomed. Sci Instrum., 14, pp. 81 - 85, 1978 | ||||
[50] | PAHLM O.,  P. and WERNER O. Compact digital storage of ECGs, Comp. Programs Biomed., 9, pp. 293 - 300, 1979 | ||||
[51] | PEDEN J. ECG data compression: Some practical considerations, in Computing in Medicine, PAUL J., JORDAN M., FERGUSON-PELL M. and ANDREWS B. eds., pp. 62 - 67,1982 (ISBN 0 333 31886 2) | ||||
[52] | REDDY B.R.S. and MURTHY I.S.N. ECG data compression using Fourier descriptors, IEEE Trans. Biomed. Eng., 33, pp. 428 - 434, 1986 | ||||
[53] | RUTTIMANN U.E. and PIPBERGER H.V. Data compression and the quality of the reconstructed ECG, in WOLF H.K. and MACFARLANE P.W., eds. Optimization of Computer ECG Processing, North Holland, Amsterdam, pp. 77 - 83, 1980 | ||||
[54] | SHRIDAR M. and STEVENS M.F Analysis of ECG data for data compression, Int. J. Bio-Medical Computing, 10, pp. 113 - 128, 1979 | ||||
[55] | WOMBLE M.E., HALLIDAY J.S., MITTER S.K., LANCASTER M.C. and TRIEBWASSER J.H. Data compression for storing and transmitting ECGs/VCGs, Proc. IEEE, 65, pp. 702 - 706 KL, 1977 | ||||
[56] | ZYWIETZ C., JOSEPH G. and DEGANI R. Data compression for computerized electrocardiography, in WILLEMS J.L., ed. Digital ECG Data Communication, Encoding and Storage, Proc of the 1st Working Conf of the SCP-ECG Project AIM 1015, Leuven ACCO Press, pp. 95 - 136, 1990 | ||||
Другие источники | |||||
[57] | Amer. J. Cardiology (1978, 41, pp. 130 - 145) | ||||
[58] | Amer. Heart J. (1978, 95, pp. 796 - 806) | ||||
[59] | Amer. Heart J. 95, pp. 796 - 806, 1978 | ||||
[60] | J. Amer. Coll. Cardiol. 5, pp. 1261 - 75, 1985 | ||||
Вернуться в "Каталог нормативных документов"
Источник информации: https://internet-law.ru/documents/prod/gost-r_gosudarstvennyj-standart/30/gost_35158.html
На правах рекламы:
|
© Антон Серго, 1998-2026.
|
Разработка сайта |
|